


1. Introduction aux diagrammes de flux de données (DFD)
Un diagramme de flux de données (DFD) est une représentation graphique de la façon dont les données circulent au sein d’un système — montrant d’où proviennent les données, comment elles sont transformées, où elles sont stockées et où elles aboutissent en définitive. Contrairement aux organigrammes (qui se concentrent sur le flux de contrôle et la séquence), les DFD mettent l’accent sur le mouvement et la transformation des données sans se soucier du chronométrage ou de l’ordre d’exécution.
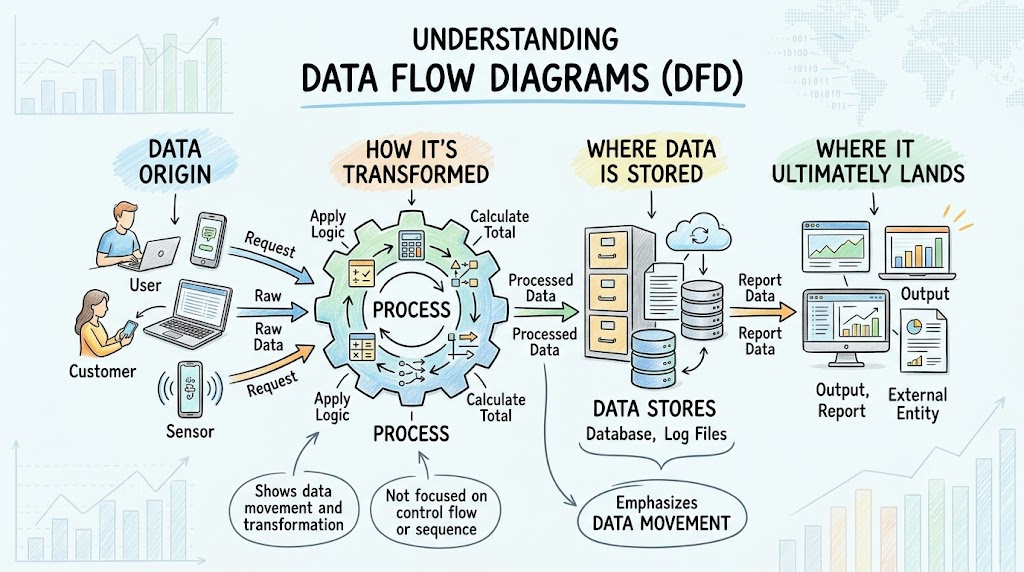
Pourquoi utiliser les DFD?
- Analyser un système existant ou concevoir un nouveau
- Identifier tôt les entrées, sorties et stocks de données
- Communiquer les limites du système et les exigences de données aux parties prenantes
- Décomposer la complexité, d’une vue d’ensemble jusqu’aux détails d’implémentation
2. Les quatre composants fondamentaux d’un DFD
Chaque DFD, à tout niveau, est construit à partir de seulement quatre éléments de base (notation Gane-Sarson) :
| Composant | Notation | Rôle | Exemple |
|---|---|---|---|
| Entité externe | Rectangle | Source ou destination des donnéesà l’extérieurde la limite du système | Client, passerelle de paiement |
| Traitement | Cercle | Transforme les données entrantes en données sortantes | « Passer une commande », « Autoriser le paiement » |
| Stockage de données | Enregistrement / rectangle ouvert | Un endroit où les données sont conservées pour une utilisation ultérieure | Commandes, inventaire de produits |
| Flux de données | Flèche (étiquetée) | Le mouvement des données entre les éléments ci-dessus | « Détails de la commande », « Statut du paiement » |
💡 Règle clé :Un traitementdoitavoir à la fois des flux d’entrée et des flux de sortie. Un traitement avec uniquement des entrées ou uniquement des sorties est une erreur de modélisation — chaque transformation produit un résultat.
3. Niveaux de DFD— La pyramide du haut vers le bas
La puissance de la décomposition du haut vers le bas réside dans le fait que vous commencezde manière abstraite et ajouter détail itérativement. Chaque niveau suit une convention de numérotation standard :
| Niveau | Nom | Contenu |
|---|---|---|
| Niveau 0 | Diagramme de contexte | Un seul processus (l’ensemble du système), toutes les entités externes et leurs flux — aucun stockage de données, aucun détail interne |
| Niveau 1 | DFD du système | Le système décomposé en processus majeurs (1.0, 2.0, 3.0…), des stocks de données internes et des flux |
| Niveau 2 | Sous-diagramme | Un seul processus de niveau 1 décomposé en processus plus fins (2.1, 2.2, 2.3…) |
| Niveau 3 | Sous-sous-diagramme | Un seul processus de niveau 2 décomposé davantage (2.2.1, 2.2.2, 2.2.3…) |
La numérotation vous indique exactement où vous vous situez dans la hiérarchie — 2.2.4 appartient à 2.2, qui appartient à 2.0. Cette structure arborescente rend les grands systèmes navigables.
4. Le style de la maison (légende des couleurs)
Chaque diagramme de ce guide suit une convention visuelle cohérente. Dans Graphviz, la recette est : d’abord le style, puis la déclaration, puis la connexion.
| Élément | Forme | Remplissage | Bordure | Objectif |
|---|---|---|---|---|
| Entité externe | boîte |
#E1F5FE |
#0288D1 |
Qui est à l’extérieur |
| Processus | cercle |
#E8F5E9 |
#388E3C |
Ce qui transforme les données |
| Stockage de données | enregistrement |
#FFF9C4 |
#FBC02D |
Où les données reposent |
| Processus parent (réf.) | cercle |
#FCE4EC |
#C2185B |
Contexte en dehors du niveau actuel |
| Limite du système | pointillé, arrondi cluster |
#FAFAFA / #757575 |
Gris | Cadre du diagramme actuel |
| Flux de données | flèche |
— | #555555 |
Mouvement des données |
⚠️ Important — un modèle de style n’est PAS un diagramme
Un fichier Graphviz qui définit uniquement les styles des nœuds/arêtes mais ne déclare jamais de nœuds ou d’arêtes sera rendu comme un canevas vide. Un DFD nécessite trois ingrédients dans l’ordre :
- Styliser le graphe —
graph [...],node [...],edge [...]attributs. - Déclarer les éléments — entités externes (boîtes), processus (cercles), magasins de données (enregistrements), enveloppés dans un
clusterfrontière en pointillés. - Dessiner les flux — explicites
A -> B [label="..."]arêtes, en utilisantdir=bothpour des échanges bidirectionnels.
Comparez ces deux — les deux valident correctement, mais seul le second produit une image :
❌ Style uniquement (ne produit rien) :
digraph DFD {
    graph [rankdir = LR]
    node [shape = box, style = "filled", fillcolor = "#E1F5FE"]
    edge [color = "#555555", arrowsize = 0.8]
}
✅ Complet (produit une image) :
digraph DFD {
    graph [rankdir = LR]
    node [style = "filled", fillcolor = "#E1F5FE", shape = box]
    Client;
    // ...plus processus, magasins de données, frontière et arêtes
}
5. Le Processus de décomposition descendante (Étape par étape)
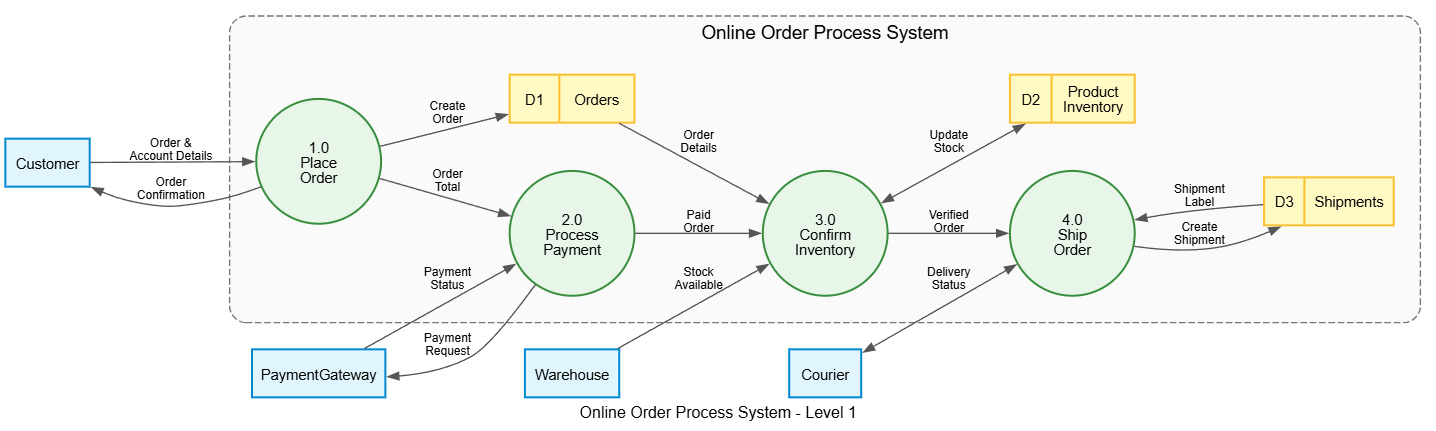
Le Système de processus de commande en ligne illustre la méthodologie. À chaque niveau, vous obtiendrez du code Graphviz complet et exécutable.
Étape 1 — Construire le diagramme de contexte (Niveau 0)
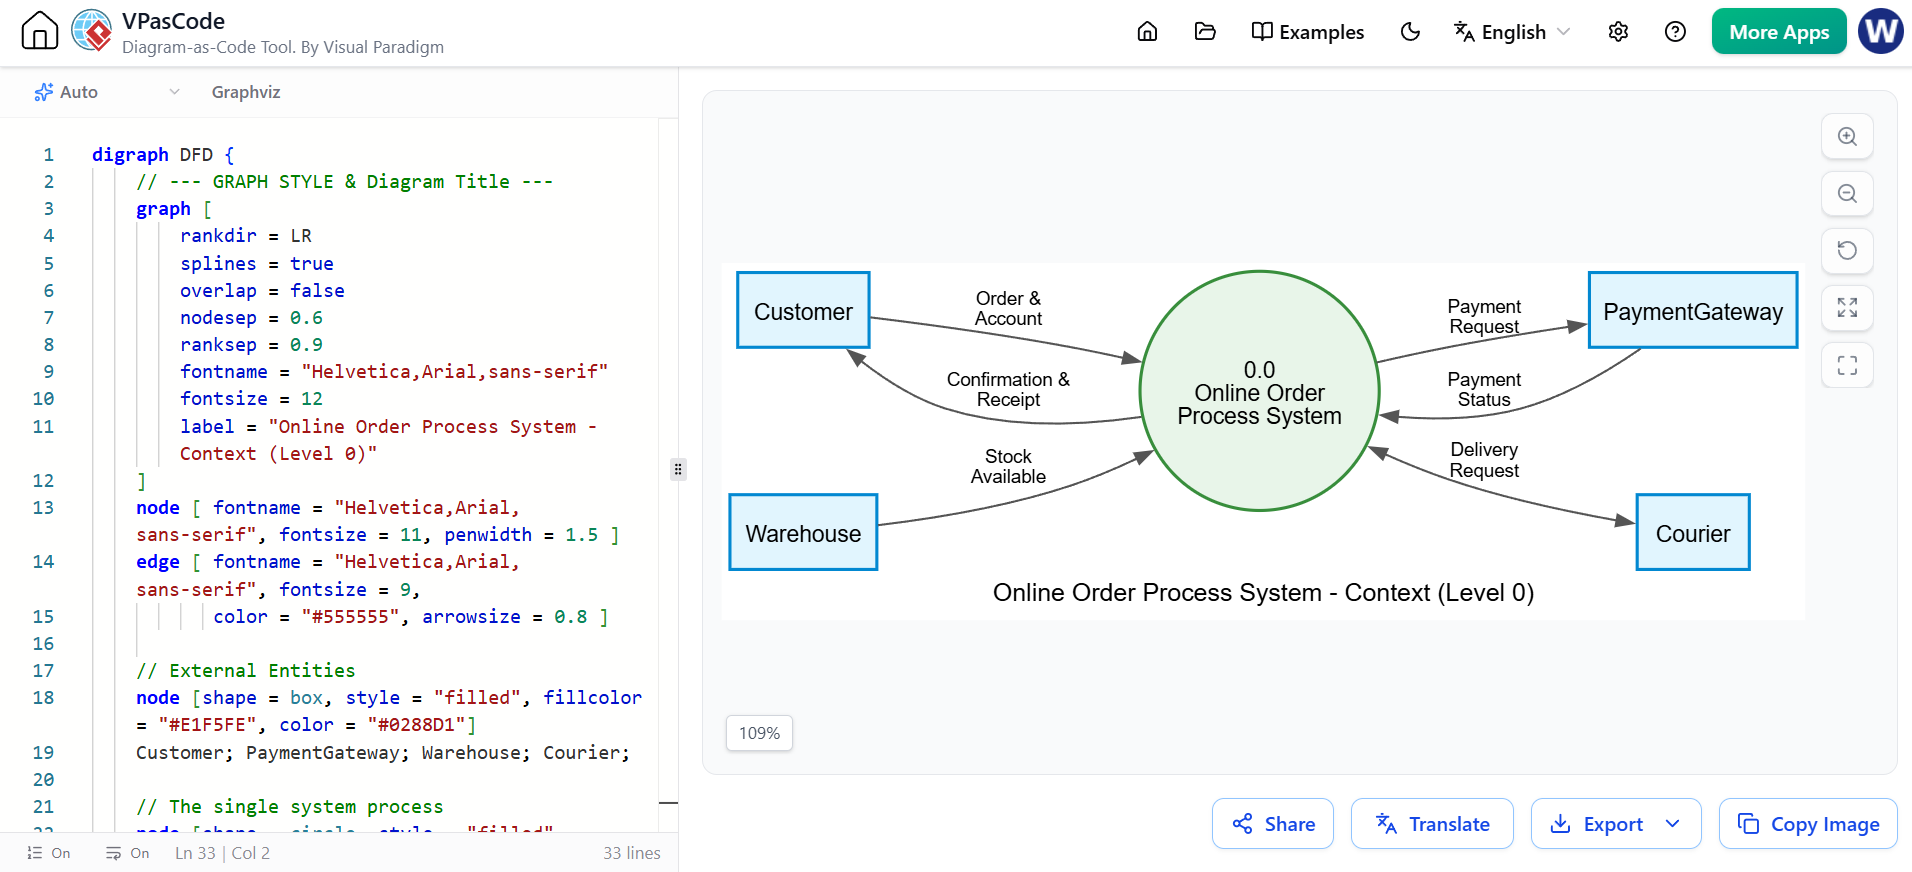
Commencez par l’ensemble du système en tant que un seul processus et identifiez chaque interaction avec le monde extérieur. Aucun magasin de données, aucun détail interne.
digraph DFD {
    // --- STYLE DU GRAPHIQUE & Titre du diagramme ---
    graph [
        rankdir = LR
        splines = true
        overlap = false
        nodesep = 0.6
        ranksep = 0.9
        fontname = "Helvetica,Arial,sans-serif"
        fontsize = 12
        label = "Système de traitement des commandes en ligne - Contexte (Niveau 0)"
    ]
    node [ fontname = "Helvetica,Arial,sans-serif", fontsize = 11, penwidth = 1.5 ]
    edge [ fontname = "Helvetica,Arial,sans-serif", fontsize = 9,
           color = "#555555", arrowsize = 0.8 ]

    // Entités externes
    node [shape = box, style = "filled", fillcolor = "#E1F5FE", color = "#0288D1"]
    Client; Passerelle de paiement; Entrepôt; Coursier;

    // Le processus unique du système
    node [shape = circle, style = "filled", fillcolor = "#E8F5E9",
          color = "#388E3C", fixedsize = true, width = 1.6]
    Système [label="0.0nTraitement des commandesnSystème"];

    // Flux de données (bidirectionnels là où les données sont échangées dans les deux sens)
    Client -> Système [label="Commande &nCompte"];
    Système -> Client [label="Confirmation &nReçu"];
    Système -> Passerelle de paiement [label="Demande denPaiement"];
    Passerelle de paiement -> Système [label="Statut dunPaiement"];
    Entrepôt -> Système [label="StocknDisponible"];
    Système -> Coursier [label="Demande denLivraison", dir=both];
}Interprétation : Le diagramme de contexte répond à « quelles sont les limites de ce système, et avec qui communique-t-il ? » — il montre les entités externes et leurs flux, mais cache toute la structure interne. Nous voyons que le système reçoit des commandes de Client, facture via Passerelle de paiement, vérifie les stocks par rapport à Entrepôt, et confie l’exécution à Coursier.
Étape 2 — Décomposer en Niveau-1 (Processus majeurs)
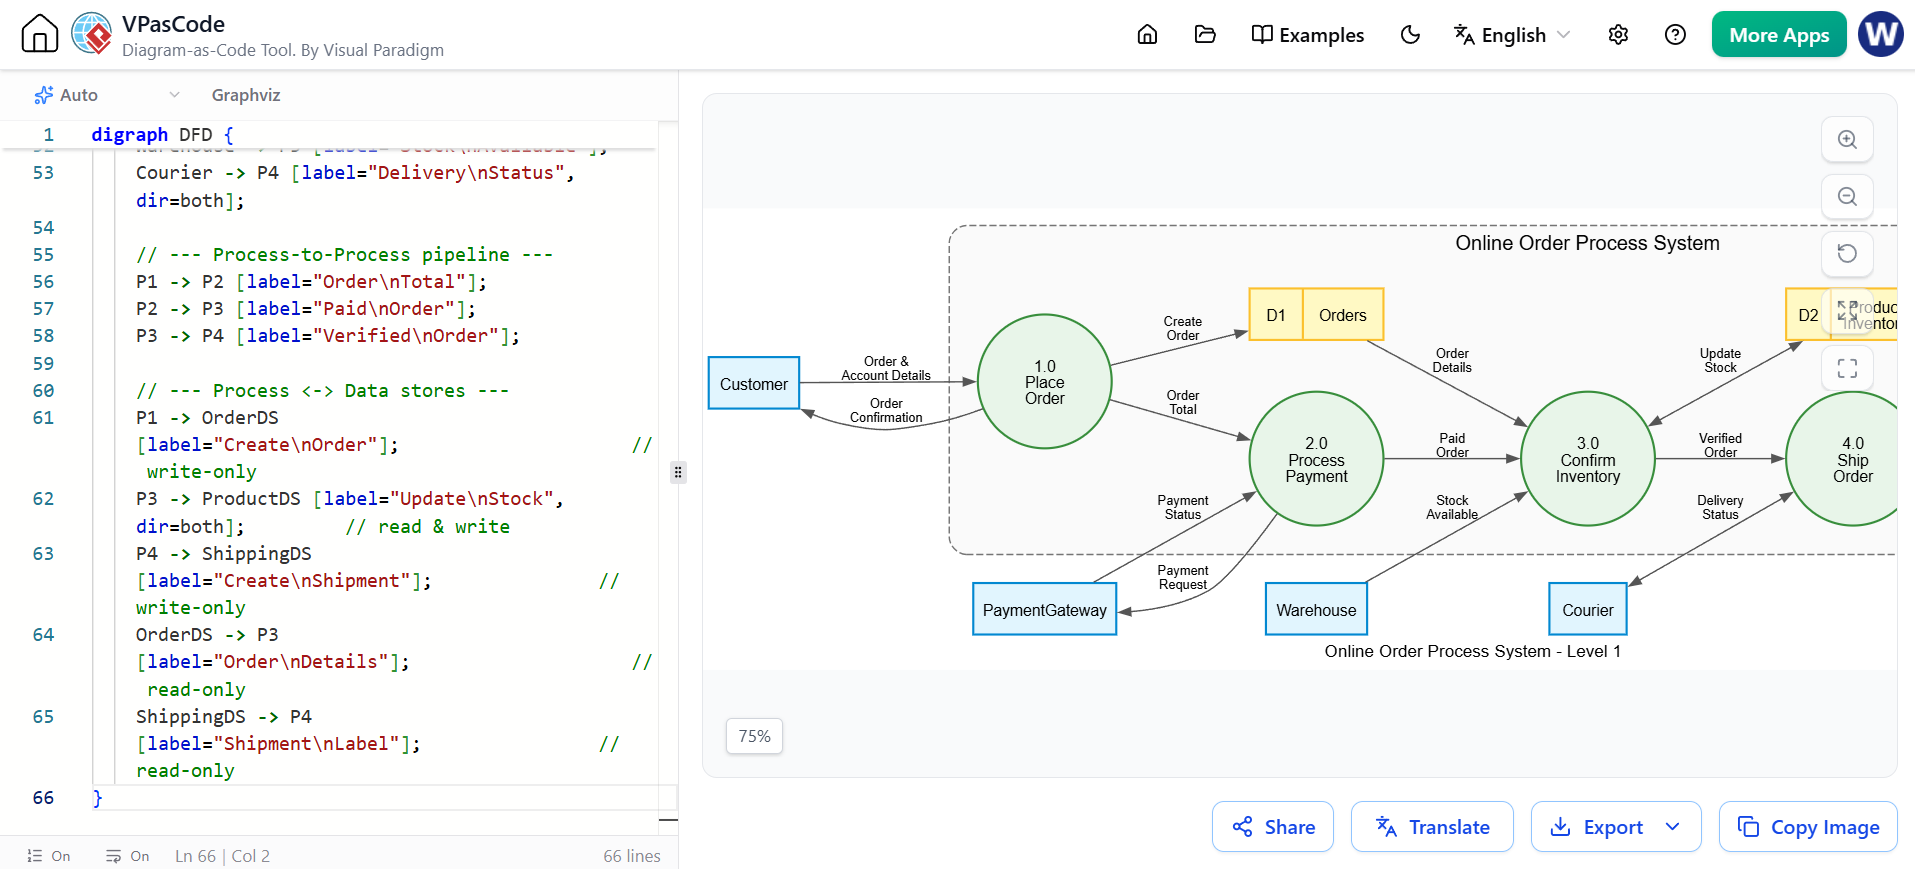
Décomposez le processus unique de contexte en fonctions clés et ajoutez des dépôts de données partagés. Enveloppez les processus + dépôts dans un périmètre de système arrondi en pointillés.
digraph DFD {
    // --- STYLE DU GRAPHIQUE ET TITRE DU DIAGRAMME ---
    graph [
        rankdir = LR
        splines = true
        overlap = false
        nodesep = 0.5
        ranksep = 0.8
        fontname = "Helvetica,Arial,sans-serif"
        fontsize = 12
        label = "Système de processus de commande en ligne - Niveau 1"
    ]
    node [ fontname = "Helvetica,Arial,sans-serif", fontsize = 11, penwidth = 1.5 ]
    edge [ fontname = "Helvetica,Arial,sans-serif", fontsize = 9,
           color = "#555555", arrowsize = 0.8 ]

    // Entités externes
    node [shape = box, style = "filled", fillcolor = "#E1F5FE", color = "#0288D1"]
    Client; Passerelle de paiement; Entrepôt; Coursier;

    // --- CONTENEUR DE LIMITES DU SYSTÈME ---
    subgraph cluster_SystemBoundary {
        label = "Système de processus de commande en ligne";
        fontname = "Helvetica,Arial,sans-serif"
        fontsize = 14
        color = "#757575"
        style = "dashed,rounded"
        bgcolor = "#FAFAFA"
        margin = 20

        // Processus (cercles verts)
        node [shape = circle, style = "filled", fillcolor = "#E8F5E9",
              color = "#388E3C", fixedsize = true, width = 1.3]
        P1 [label="1.0nPassernCommande"];
        P2 [label="2.0nTraiternPaiement"];
        P3 [label="3.0nConfirmernStock"];
        P4 [label="4.0nExpédiernCommande"];

        // Dépôts de données (enregistrements jaunes)
        node [shape = record, style = "filled", fillcolor = "#FFF9C4",
              color = "#FBC02D", fixedsize = false]
        OrderDS    [label="{ D1 | Commandes }"];
        ProductDS  [label="{ D2 | ProduitnStock }"];
        ShippingDS [label="{ D3 | Expéditions }"];
    }

    // --- FLUX DE DONNÉES : Entités externes ---
    Client -> P1 [label="Commande &nDétails du compte"];
    P1 -> Client [label="Confirmationnde commande"];
    P2 -> Passerelle de paiement [label="Demandende paiement"];
    Passerelle de paiement -> P2 [label="Statutnde paiement"];
    Entrepôt -> P3 [label="Stockndisponible"];
    Coursier -> P4 [label="Statutnde livraison", dir=both];

    // --- Pipeline de processus à processus ---
    P1 -> P2 [label="Totalnde la commande"];
    P2 -> P3 [label="Commandenpayée"];
    P3 -> P4 [label="Commandenvérifiée"];

    // --- Processus <-> Dépôts de données ---
    P1 -> OrderDS [label="CréernCommande"];                     // écriture seule
    P3 -> ProductDS [label="Mettre à journStock", dir=both];         // lecture et écriture
    P4 -> ShippingDS [label="CréernExpédition"];               // écriture seule
    OrderDS -> P3 [label="Détailsnde la commande"];                    // lecture seule
    ShippingDS -> P4 [label="Étiquettend'expédition"];                // lecture seule
}
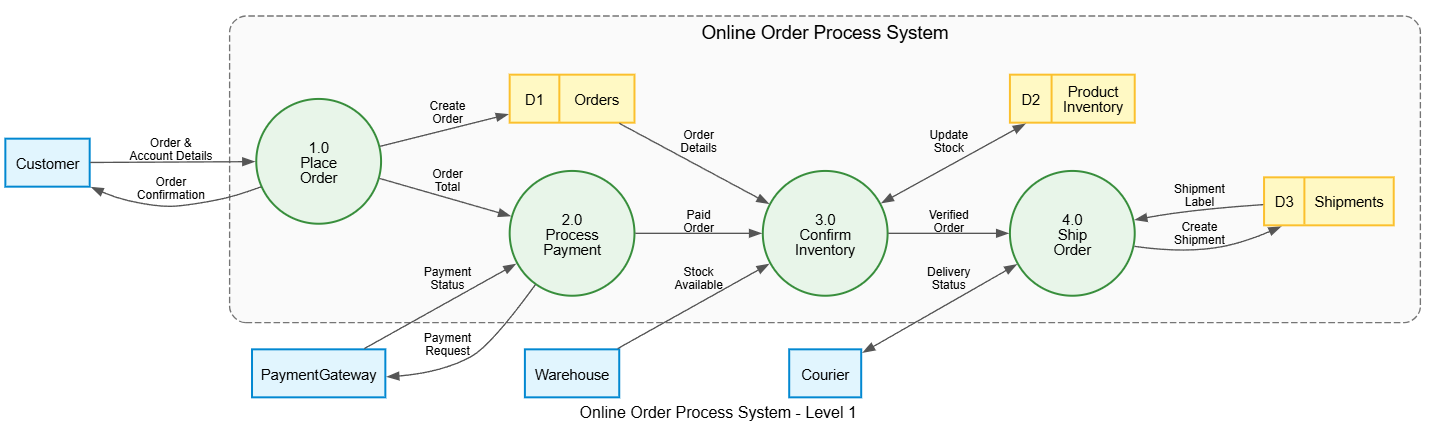 Interprétation :
- La chaîne linéaire
P1 → P2 → P3 → P4montre un pipeline ordonné: une commande est passée avant le paiement, avant la vérification du stock, avant l’expédition. - La Passerelle de paiement utilise deux flèches à sens unique (
Demande de paiementvers l’extérieur,Statut de paiementvers l’intérieur). - Dépôts de données agissent comme état :
P1écrit les commandes,P3lit et met à jour le stock (dir=both),P4écrit les expéditions. P3 → ProductDSutilisedir=both— une seule arête, pas deux — car le processus lit et met à jour l’inventaire.
Étape 3 — Approfondissement : Niveau-2 (Se concentrer sur un processus)
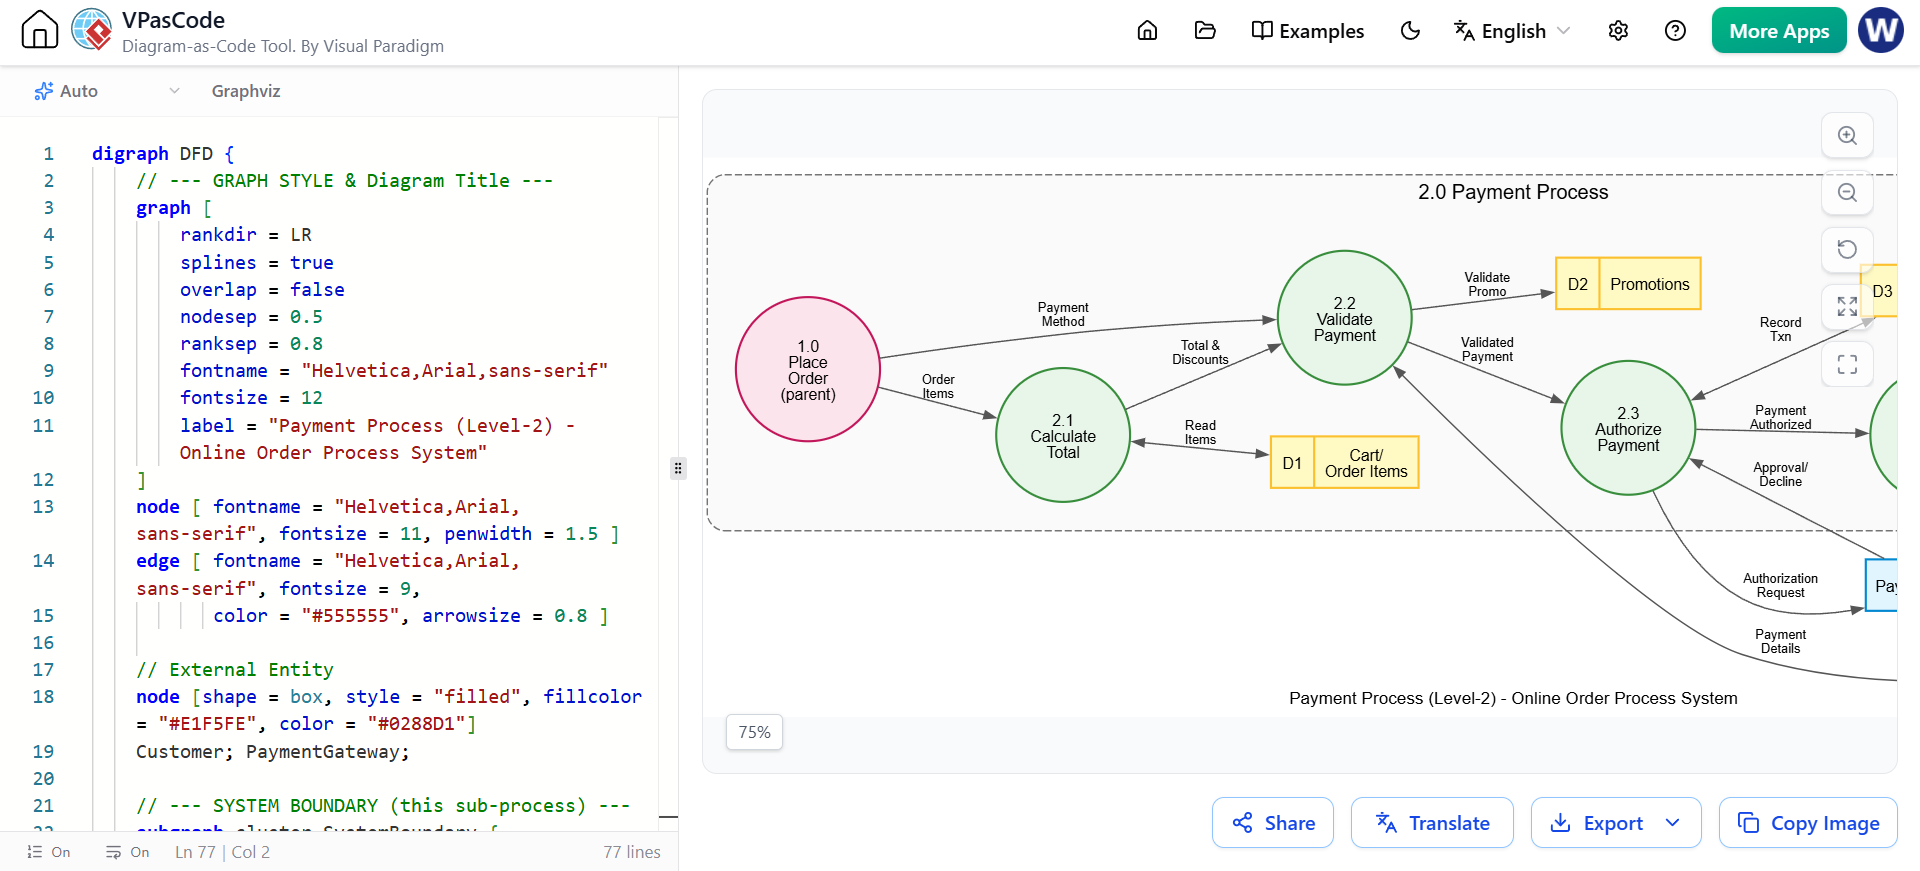
Choisissez un processus de niveau 1 et décomposez-le juste celui-là. Affichez processus parents à la frontière (rose) afin de conserver le contexte, ainsi que les sous-processus, les sous-stockages et les flux.
digraph DFD {
    // --- STYLE DU GRAPHIQUE & Titre du diagramme ---
    graph [
        rankdir = LR
        splines = true
        overlap = false
        nodesep = 0.5
        ranksep = 0.8
        fontname = "Helvetica,Arial,sans-serif"
        fontsize = 12
        label = "Processus de paiement (Niveau-2) - Système de traitement des commandes en ligne"
    ]
    node [ fontname = "Helvetica,Arial,sans-serif", fontsize = 11, penwidth = 1.5 ]
    edge [ fontname = "Helvetica,Arial,sans-serif", fontsize = 9,
           color = "#555555", arrowsize = 0.8 ]

    // Entité externe
    node [shape = box, style = "filled", fillcolor = "#E1F5FE", color = "#0288D1"]
    Customer; PaymentGateway;

    // --- FRONTIÈRE DU SYSTÈME (ce sous-processus)
    subgraph cluster_SystemBoundary {
        label = "2.0 Processus de paiement";
        fontname = "Helvetica,Arial,sans-serif"
        fontsize = 14
        color = "#757575"
        style = "dashed,rounded"
        bgcolor = "#FAFAFA"
        margin = 20

        // Sous-processus (cercles verts)
        node [shape = circle, style = "filled", fillcolor = "#E8F5E9",
              color = "#388E3C", fixedsize = true, width = 1.3]
        P21 [label="2.1nCalculernTotal"];
        P22 [label="2.2nValidernPaiement"];
        P23 [label="2.3nAutorisernPaiement"];
        P24 [label="2.4nConfirmernCommande"];

        // Sous-stockages de données (enregistrements jaunes)
        node [shape = record, style = "filled", fillcolor = "#FFF9C4",
              color = "#FBC02D", fixedsize = false]
        CartDS   [label="{ D1 | Panier/nArticles de commande }"];
        PromoDS  [label="{ D2 | Promotions }"];
        PaymentDS [label="{ D3 | PaiementnTransactions }"];
        OrderDS  [label="{ D4 | Commandes }"];

        // Processus parents (rose) - contexte du niveau supérieur
        node [shape = circle, style = "filled", fillcolor = "#FCE4EC",
              color = "#C2185B", fixedsize = true, width = 1.4]
        P1 [label="1.0nPassernCommanden(parent)"];
        P3 [label="3.0nConfirmernInventairen(parent)"];
    }

    // Flux des parents / client vers les sous-processus
    P1 -> P21 [label="Articlesnde commande"];
    P1 -> P22 [label="Méthodende paiement"];
    Customer -> P22 [label="Détailsnde paiement"];

    // Chaîne de sous-processus
    P21 -> P22 [label="Total &nRemises"];
    P22 -> P23 [label="PaiementnValidé"];
    P23 -> P24 [label="PaiementnAutorisé"];

    // Interaction avec la passerelle externe
    P23 -> PaymentGateway [label="Demandend'autorisation"];
    PaymentGateway -> P23 [label="Approbation/nRefus"];

    // Sortie vers les parents / client
    P24 -> P3 [label="CommandenPayée"];
    P24 -> Customer [label="Reçunde paiement"];

    // Accès aux stockages de données
    P21 -> CartDS [label="LirenArticles", dir=both];
    P22 -> PromoDS [label="ValidernPromo"];
    P23 -> PaymentDS [label="EnregistrernTxn", dir=both];
    P24 -> OrderDS [label="Mettre à journStatut"];
}
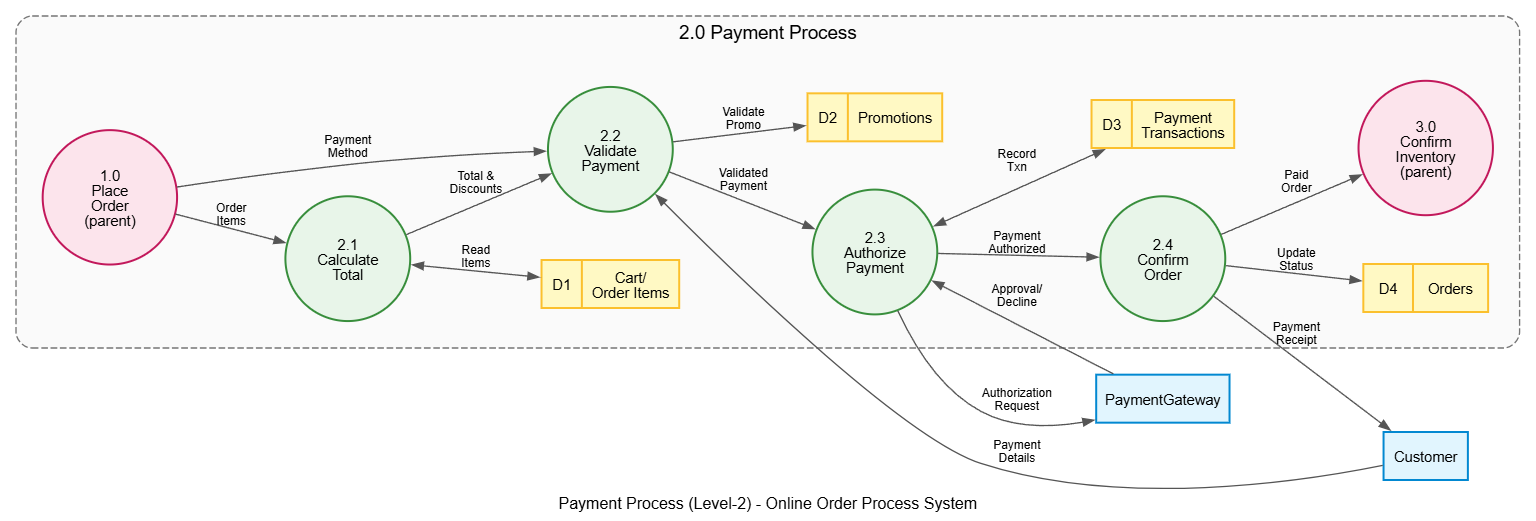 Interprétation (par rapport à Niveau-1):
- 2.1 Calculer le total est un calcul pur — lit les articles du panier, produit un montant, sans entrée/sortie externe au-delà des stockages.
- 2.3 Autoriser le paiement est le seul étape qui communique avec l’externe Passerelle de paiement — le mouvement d’argent est clairement isolé.
- Le
Commandesmagasin réapparaît car 2.4 met à jour le statut de la commande (initialement écrit par 1.0 au niveau 1). - La chaîne
2.1 → 2.2 → 2.3 → 2.4est un pipeline de validation séquentielle avant de transmettre à 3.0 (parent rose). - Processus parent 1.0 et 3.0 sont dessinés en rose à l’extérieur de la frontière pour ancrer l’origine et la fin des flux.
Étape 4 — Approfondir à nouveau : Niveau 3 (Répéter de manière récursive)
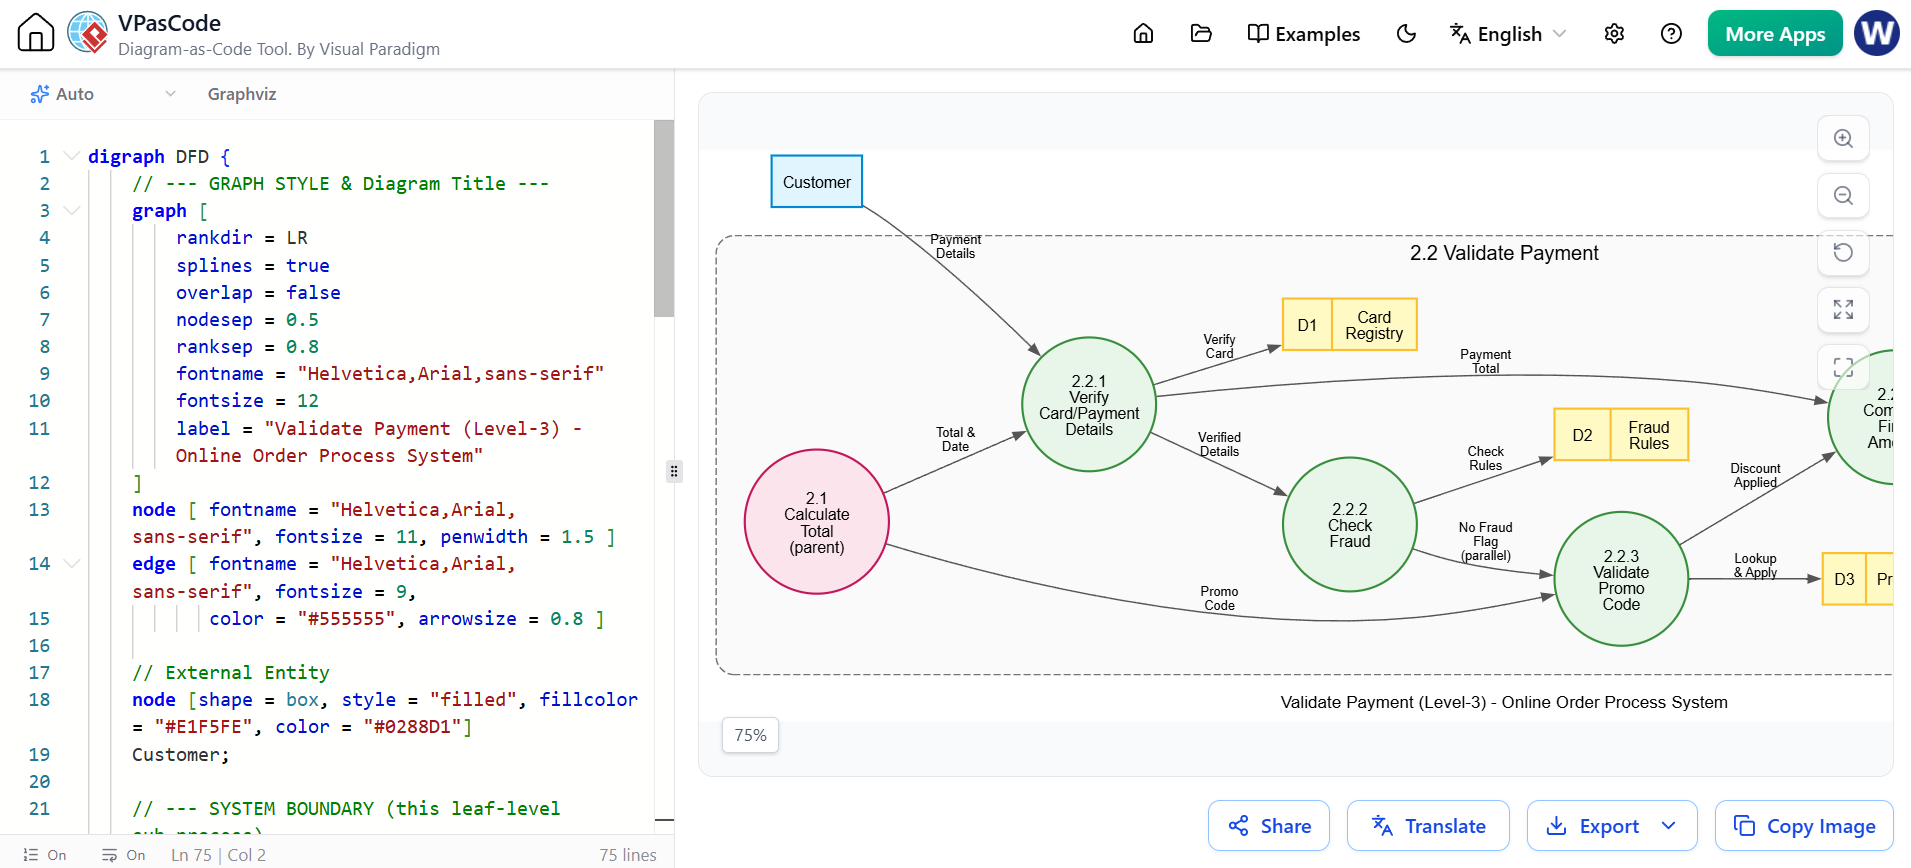
Répétez exactement la même technique sur tout sous-processus encore trop complexe. Nous zoomons sur 2.2 Valider le paiement.
digraph DFD {
    // --- STYLE DU GRAPHIQUE ET TITRE DU DIAGRAMME ---
    graph [
        rankdir = LR
        splines = true
        overlap = false
        nodesep = 0.5
        ranksep = 0.8
        fontname = "Helvetica,Arial,sans-serif"
        fontsize = 12
        label = "Valider le paiement (Niveau 3) - Système de traitement des commandes en ligne"
    ]
    node [ fontname = "Helvetica,Arial,sans-serif", fontsize = 11, penwidth = 1.5 ]
    edge [ fontname = "Helvetica,Arial,sans-serif", fontsize = 9,
           color = "#555555", arrowsize = 0.8 ]

    // Entité externe
    node [shape = box, style = "filled", fillcolor = "#E1F5FE", color = "#0288D1"]
    Client;

    // --- LIMITE DU SYSTÈME (ce sous-processus de niveau feuille) ---
    subgraph cluster_SystemBoundary {
        label = "2.2 Valider le paiement";
        fontname = "Helvetica,Arial,sans-serif"
        fontsize = 14
        color = "#757575"
        style = "dashed,rounded"
        bgcolor = "#FAFAFA"
        margin = 20

        // Processus de niveau feuille (cercles verts)
        node [shape = circle, style = "filled", fillcolor = "#E8F5E9",
              color = "#388E3C", fixedsize = true, width = 1.3]
        P221 [label="2.2.1nVérifiernDétailsnCarte/Paiement"];
        P222 [label="2.2.2nVérifiernFraude"];
        P223 [label="2.2.3nValidernCodenPromo"];
        P224 [label="2.2.4nCalculernMontantnFinal"];

        // Dépôts de données de niveau feuille (enregistrements jaunes)
        node [shape = record, style = "filled", fillcolor = "#FFF9C4",
              color = "#FBC02D", fixedsize = false]
        CardDS  [label="{ D1 | RegistrenCarte }"];
        FraudDS [label="{ D2 | RèglesnFraude }"];
        PromoDS [label="{ D3 | Promotions }"];
        CartDS  [label="{ D4 | Panier/nArticlesnCommande }"];

        // Processus parent (rose)
        node [shape = circle, style = "filled", fillcolor = "#FCE4EC",
              color = "#C2185B", fixedsize = true, width = 1.4]
        P21 [label="2.1nCalculernTotaln(parent)"];
        P23 [label="2.3nAutorisernPaiementn(parent)"];
    }

    // Entrées
    P21 -> P221 [label="Total &nDate"];
    Client -> P221 [label="DétailsnPaiement"];

    // Validation séquentielle, avec branche parallèle
    P221 -> P222 [label="DétailsnVérifiés"];
    P222 -> P223 [label="Pas denFlagnFrauden(parallèle)"];

    // Alimentation du calcul final
    P21 -> P223 [label="CodenPromo"];
    P221 -> P224 [label="TotalnPaiement"];
    P223 -> P224 [label="RemisenAppliquée"];

    // Sortie vers le parent
    P224 -> P23 [label="TotalnValidé &nRemis"];

    // Accès aux dépôts de données
    P221 -> CardDS [label="VérifiernCarte"];
    P222 -> FraudDS [label="VérifiernRègles"];
    P223 -> PromoDS [label="Recherchern& Appliquer"];
    P224 -> CartDS [label="LirenArticles", dir=both];
}
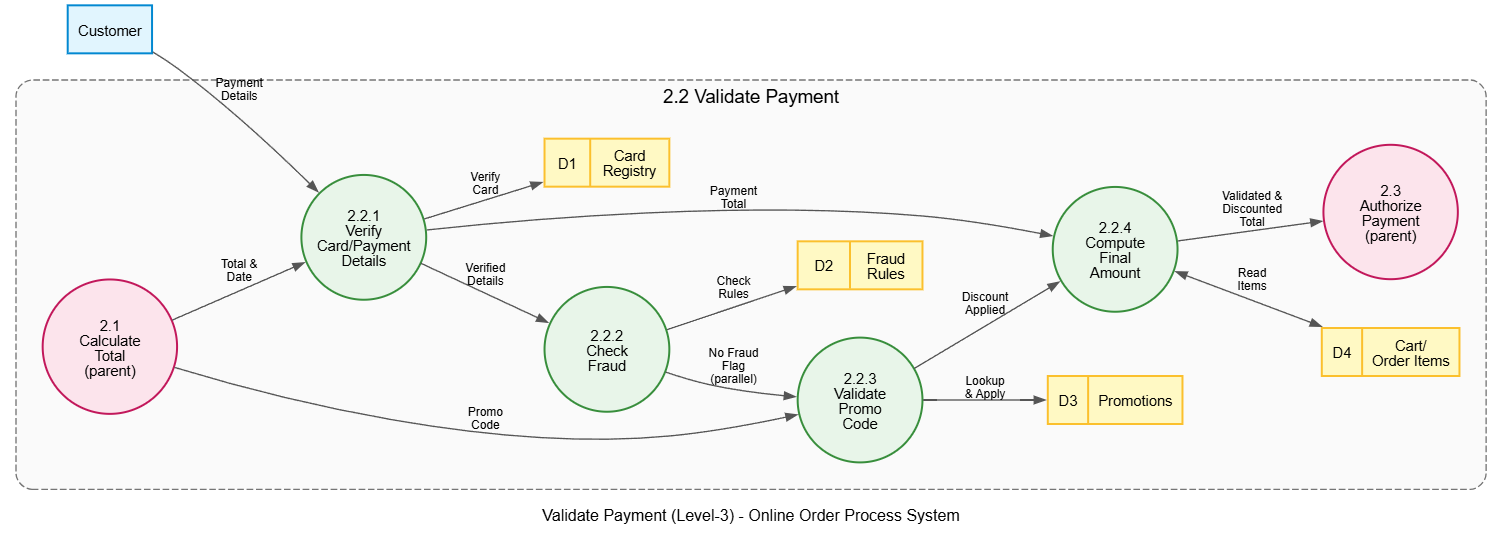 Interprétation :
- 2.2.1 Vérifier la carte est un porte — elle doit réussir avant que la vérification de la fraude ne commence.
- 2.2.2 (Fraude) et 2.2.3 (Promotion) s’exécutent en parallèle: les deux lisent les règles et les deux alimentent le calcul final. L’étiquette « (parallèle) » signale cela.
- 2.2.4 Calculer le montant final est un point de convergence — il combine
Total du paiement+Remiseen une seule sortie validée qui sort vers le parent 2.3. - Registre des cartes et Règles de fraude sont des magasins de niveau détaillé non visibles au niveau 2 — de nouveaux magasins émergent naturellement à mesure que vous décomposez.
Étape 5 — Arrêter lorsque les processus sont « primitifs »
Continuer la décomposition jusqu’à ce que chaque processus décrive un action unique, non ambiguë et implémentable. Il n’y a pas de profondeur fixe ; arrêtez-vous lorsqu’un processus se traduit clairement par une seule fonction ou une seule décision. Les niveaux 2.2.1 à 2.2.4 ci-dessus sont déjà primitifs.
6. Bonnes pratiques et pièges courants
✅ Bonnes pratiques
- Numérotez les processus de manière hiérarchique (
2.2.4) afin que tout diagramme soit auto-localisable dans l’arborescence. - Dessinez les processus parents à la frontière (rose) afin que les flux conservent leur contexte — ne jamais isoler une entrée ou une sortie.
- Utilisez une seule arête bidirectionnelle (
dir=both) pour les échanges bidirectionnels au lieu de deux flèches séparées. Réduit l’encombrement. - Gardez les libellés descriptifs mais courts (« Autoriser le paiement », et non « AP »).
- Décomposez un processus à la fois — chaque niveau est un diagramme à part ; ne regroupez pas plusieurs niveaux dans un seul.
- Équilibrez les diagrammes — les entrées/sorties à un niveau parent doivent être égales à la somme des entrées/sorties de ses enfants (règle d’équilibrage).
- Déclarez toujours les éléments — un modèle basé uniquement sur le style qui ne déclare aucun nœud ni arête produit un canevas vide. Chaque DFD doit style, puis déclarer, puis connecter.
- Nommez les dépôts de données de manière unique dans les diagrammes enfants, mais renumérotez-les localement (D1, D2…) pour l’autonomie.
❌ Pièges courants
- Processus orphelins — un processus sans entrée ni sortie. Tout processus transforme quelque chose.
- Équilibrage manquant — un flux apparaît au Niveau-1, mais aucun de ses enfants de Niveau-2 ne le produit ni ne le consomme.
- Détail prématuré — exposer des dépôts de données dans le diagramme de contexte de Niveau-0 (ils appartiennent uniquement aux niveaux inférieurs).
- Pensée orientée flux de contrôle — intégrer des boucles ou des symboles de décision dans un DFD ; réservez cela aux organigrammes. Les DFD montrent les données, pas l’ordre.
- Deux flèches parallèles pour ce qui devrait être un seul
dir=botharête — crée une surcharge de lignes en double. - Mauvaise direction d’accès au dépôt — étiqueter un dépôt comme en lecture seule alors qu’il est en réalité écrit (ou l’inverse).
- Modèle de style pris à tort pour un diagramme — oublier de déclarer les nœuds et les arêtes produit un graphe vide.
7. Liste de vérification descendante
Avant de présenter un diagramme, vérifiez :
- ✅ Chaque processus a ≥1 entrée et ≥1 sortie.
- ✅ Chaque étiquette de flux est un nom (« Détails de la commande »), pas un verbe.
- ✅ Chaque dépôt de données est lu et écrit à un moment donné (sauf s’il s’agit clairement de données de référence externes).
- ✅ Les limites de niveau s’équilibrent : les enfants consomment et produisent exactement ce que leur parent a échangé.
- ✅ Les entités externes n’apparaissent qu’aux bords, jamais à l’intérieur d’une limite.
- ✅
dir=bothest utilisé pour les échanges bidirectionnels ; les flèches unidirectionnelles sont utilisées dans les autres cas. - ✅ Les références aux processus parents en rose indiquent correctement le niveau en cours de décomposition.
- ✅ Le code déclare de véritables nœuds, arêtes et une frontière — ce n’est pas simplement une règle de style.
8. Résumé du processus de décomposition descendante
La décomposition DFD descendante est un voyage de l’abstraction au détail:
- Contexte (L0) — une seule boîte, toutes les frontières et entités externes.
- Système (L1) — les principaux processus, les entrepôts et le pipeline de données.
- Sous-diagrammes (L2, L3…) — zoomer récursivement sur un processus à la fois, en gardant le contexte parent visible et en numérotant les entrepôts locaux.
Chaque niveau répond à une question différente : L0 demande « quelle est l’empreinte du système ? », L1 demande « quels sont les principaux flux de données ? », L2+ demande « comment ces données sont-elles exactement transformées ? »
L’exemple du processus de commande en ligne illustre la chaîne complète dans un code Graphviz complet et exécutable — depuis un diagramme de contexte à 4 entités diagramme de contextejusqu’à une routine de validation en 4 étapes routine de validation (2.2.1 → 2.2.4). En utilisant la numérotation, en équilibrant les flux, en respectant une cohérence légende des couleurs (boîtes bleues, cercles verts, enregistrements jaunes, références parentales roses, frontière grise en pointillés), et toujours déclarer explicitement chaque nœud/arête, tout système complexe reste navigable et sans ambiguïté — et chaque diagramme s’affiche réellement.
9. Outils : Construire une décomposition descendante de DFD avec Visual Paradigm AI
Visual Paradigm AI intègre un chatbot d’IA directement dans l’outil de modélisation. Au lieu de dessiner manuellement chaque niveau, vous pouvez piloter toute la décomposition de manière conversationnelle, puis affiner le résultat. Voici comment l’utiliser pour exactement l’approche décrite dans ce guide.
9.1 Fonctions principales pour le travail sur les DFD
Le Chatbot VP AI est un assistant texte et code qui travaille avec vous par le dialogue. Pour la décomposition descendante de DFD, il peut :
| Fonctionnalité | Ce qu’il fait pour vous |
|---|---|
| Générer le code du diagramme | Produire du Graphviz (DOT) pour une description de processus donnée — un niveau à la fois |
| Analyser les images jointes | Lire une image DFD dessinée à la main ou existante que vous téléchargez et la transformer en modèles structurés |
| Affiner de manière itérative | Prendre vos commentaires (« zoomer sur 2.2 », « ajouter la branche de déclin ») et régénérer le diagramme |
| Expliquer les interprétations | Parcourir ce que signifie chaque entité, processus, stockage et flux |
| Valider la syntaxe | Vérifier que le DOT est structurellement valide avant de le rendre |
| Produire des sorties de stratégie/graphique | Générer des graphiques ou des cadres de soutien qui accompagnent le DFD (par exemple, une piste de nage ou un contexte organisationnel) |
📌 Remarque : Visual Paradigm prend en charge une gamme de notations de diagrammes. Privilégiez BPMN pour la modélisation de processus métier nécessitant des événements de début/fin, des passerelles et des couloirs ; utilisez les DFD basés sur Graphviz pour une modélisation stricte du flux de données comme illustré tout au long de ce guide.
9.2 Dialogue résolu — Décomposition du processus de commande en ligne
Voici une session de chat réaliste qui reflète les étapes que nous avons parcourues. Remarquez comment chaque invite zoom d’un niveau plus profond — exactement la méthodologie descendante.
Invite 1 — Démarrer le diagramme de contexte :
« Créez un diagramme de contexte (Niveau 0) pour un système de processus de commande en ligne. Entités externes : Client, Passerelle de paiement, Entrepôt, Coursier. »
L’IA VP répond avec un DFD de Niveau 0 — un processus central, quatre entités externes et leurs flux — que vous placez dans un diagramme.
Invite 2 — Ajouter le niveau de détail :
« Décomposez-le maintenant en un DFD de Niveau 1 avec les processus suivants : 1.0 Passer une commande, 2.0 Traiter le paiement, 3.0 Confirmer l’inventaire, 4.0 Expédier la commande. Ajoutez des magasins de données pour les Commandes, l’Inventaire des produits et les Expéditions. »
L’IA VP renvoie le diagramme de Niveau 1 avec les processus enchaînés séquentiellement, les magasins attachés et les flux des entités externes préservés — le pipeline que vous avez vu à l’étape 2 du guide.
Invite 3 — Zoom sur un processus :
« Zoom sur 2.0 Traiter le paiement. Créez un sous-diagramme de Niveau 2 avec 2.1 Calculer le total, 2.2 Valider le paiement, 2.3 Autoriser le paiement, 2.4 Confirmer la commande. Gardez 1.0 et 3.0 comme références parentes. »
L’IA VP produit le sous-diagramme de Niveau 2 : sous-processus, magasins locaux (D1–D4), l’interaction avec la passerelle de paiement et les références parentes roses pour 1.0 et 3.0 — correspondant à l’étape 3.
Invite 4 — Approfondir à nouveau :
« Approfondissez 2.2 Valider le paiement en un diagramme de Niveau 3 : 2.2.1 Vérifier la carte, 2.2.2 Vérifier la fraude, 2.2.3 Valider la promotion, 2.2.4 Calculer le montant final. Ajoutez des magasins pour le Registre des cartes, les Règles de fraude, les Promotions et les Articles du panier. »
L’IA VP génère le diagramme feuille de Niveau 3 avec le calcul en fan-in (2.2.4) et les branches parallèles de fraude/promotion — exactement l’étape 4.
Invite 5 — Ajouter la gestion des exceptions :
« Ajoutez le chemin d’échec : si 2.2.2 Vérifier la fraude signale la transaction, redirigez vers un processus d’avis d’annulation vers le Client. »
L’IA VP affine le diagramme avec une branche de refus et rééquilibre automatiquement les flux.
9.3 Modèles d’invites qui fonctionnent
Utilisez ces modèles pour obtenir des résultats fiables et conformes à la méthodologie :
| Objectif | Exemple de consigne |
|---|---|
| Décomposer d’un niveau de plus | « Zoom sur 3.0 Confirmer l’inventaire en tant que sous-diagramme de niveau 2.” |
| Spécifier la numérotation | « Utiliser des processus numérotés 2.1, 2.2, 2.3.” |
| Conserver le contexte parent | « Conserver 1.0 et 3.0 comme références parentes à la limite.” |
| Ajouter des dépôts de données | « Inclure les dépôts : D1 Articles du panier, D2 Promotions.” |
| Afficher le flux bidirectionnel | « Utiliser dir=both pour les lectures et écritures entre processus et dépôts.” |
| Équilibrer le niveau | « Assurez-vous que les entrées et les sorties correspondent au niveau parent. » |
| Ajouter un chemin d’échec | « Ajouter une branche d’exception lorsque le paiement est refusé.” |
| Limiter la profondeur | « Arrêtez-vous aux processus primitifs — des actions uniques et implémentables. » |
9.4 Téléchargement d’une image pour analyse
Si vous avez déjà un DFD dessiné à la main ou hérité et que vous souhaitez le numériser :
- Joignez l’image à la discussion (une capture d’écran, une photo ou une exportation d’un DFD existant).
- Demandez : « Analysez cette image de DFD et transformez-la en un modèle structuré que je peux modifier. »
- VP AI examine l’image (en lisant les formes, les étiquettes et les flèches) et reconstruit les entités, les processus, les stocks et les flux sous forme de diagramme modifiable.
📌 L’IA lit le contenu de l’image contenu — rectangles, cercles, enregistrements et leurs étiquettes — et les reproduit dans la notation appropriée. C’est un chemin rapide d’un croquis brut vers un modèle propre et en couches que vous pouvez ensuite décomposer davantage.
9.5 Itération avec le flux de travail des artefacts
VP AI stocke chaque diagramme généré en tant qu’« artefact » que vous pouvez consulter lors de l’affinement :
- « Affinez l’artefact de niveau 2 pour ajouter une branche de refus de fraude. » — cible un diagramme déjà généré spécifique plutôt que de régénérer à partir de zéro.
- « Régénérez le diagramme de contexte mais supprimez l’entité Entrepôt. » — remplace un artefact lorsque la portée change.
- “Comparez les artefacts de niveau 2 et de niveau 3 pour l’équilibrage.” — vérifie la parité du flux parent/enfant.
Comme les artefacts conservent l’état de la conversation, vous pouvez superposer des raffinements successifs sans perdre les décisions antérieures — l’essence de la décomposition descendante.
9.6 Liste de vérification du flux de travail recommandé
| Étape | Action |
|---|---|
| 1. Échafaudage | Demandez d’abord le diagramme de contexte (niveau 0). |
| 2. Établissez le niveau 1 | Demandez la décomposition des processus majeurs avec les magasins et une frontière. |
| 3. Approfondir | Zoom sur un processus à la fois ; conservez les références parent. |
| 4. Raffiner | Demandez les chemins d’exception, les corrections d’équilibrage et les corrections des magasins. |
| 5. Valider | Faites vérifier la syntaxe DOT par l’IA ; consultez la liste de vérification à la section 7. |
| 6. Documenter | Demandez le récit d’interprétation à joindre à côté de chaque niveau. |
9.7 Exemple de sortie — Demandez à l’IA VP de générer le code de niveau 1
Une réponse typique du chatbot pour le décomposition de l’étape 2 serait le DOT complet et exécutable que vous avez vu précédemment:
digraph DFD {
    graph [
        rankdir = LR, splines = true, overlap = false,
        nodesep = 0.5, ranksep = 0.8,
        fontname = "Helvetica,Arial,sans-serif", fontsize = 12,
        label = "Système de processus de commande en ligne - Niveau 1"
    ]
    node [ fontname = "Helvetica,Arial,sans-serif", fontsize = 11, penwidth = 1.5 ]
    edge [ fontname = "Helvetica,Arial,sans-serif", fontsize = 9,
           color = "#555555", arrowsize = 0.8 ]

    // Entités externes
    node [shape = box, style = "filled", fillcolor = "#E1F5FE", color = "#0288D1"]
    Client; Passerelle de paiement; Entrepôt; Coursier;

    subgraph cluster_SystemBoundary {
        label = "Système de processus de commande en ligne";
        fontname = "Helvetica,Arial,sans-serif"
        fontsize = 14
        color = "#757575"
        style = "dashed,rounded"
        bgcolor = "#FAFAFA"
        margin = 20

        node [shape = circle, style = "filled", fillcolor = "#E8F5E9",
              color = "#388E3C", fixedsize = true, width = 1.3]
        P1 [label="1.0nPassernCommande"];
        P2 [label="2.0nTraiternPaiement"];
        P3 [label="3.0nConfirmernStock"];
        P4 [label="4.0nExpédiernCommande"];

        node [shape = record, style = "filled", fillcolor = "#FFF9C4",
              color = "#FBC02D", fixedsize = false]
        OrderDS    [label="{ D1 | Commandes }"];
        ProductDS  [label="{ D2 | ProduitnStock }"];
        ShippingDS [label="{ D3 | Expéditions }"];
    }

    // Flux
    Client -> P1 [label="Commande &nDétails du compte"];
    P1 -> Client [label="Confirmationnde commande"];
    P2 -> Passerelle de paiement [label="Demandende paiement"];
    Passerelle de paiement -> P2 [label="Statutnde paiement"];
    Entrepôt -> P3 [label="Stockndisponible"];
    Coursier -> P4 [label="Statutnde livraison", dir=both];

    P1 -> P2 [label="Totalnde la commande"];
    P2 -> P3 [label="Commandenpayée"];
    P3 -> P4 [label="Commandenvérifiée"];

    P1 -> OrderDS [label="CréernCommande"];
    P3 -> ProductDS [label="Mettre à journle stock", dir=both];
    P4 -> ShippingDS [label="CréernExpédition"];
    OrderDS -> P3 [label="Détailsnde la commande"];
    ShippingDS -> P4 [label="Étiquettend'expédition"];
}
Collez cela dans un diagramme VP, et vous obtenez le modèle de niveau 1 entièrement structuré — prêt à être à nouveau décomposé avec le prochain prompt.
10. Résumé
La décomposition DFD de haut en bas est un voyage de l’abstraction au détail:
- Contexte (Niveau 0) — une seule boîte, toutes les limites et entités externes.
- Système (Niveau 1) — les principaux processus, les magasins et le pipeline de données.
- Sous-diagrammes (Niveau 2, Niveau 3…) — zoomer récursivement sur un processus à la fois, en gardant le contexte parent visible et les magasins locaux numérotés.
Chaque niveau répond à une question différente : Le N0 demande « quelle est l’empreinte du système ? », le N1 demande « quels sont les principaux flux de données ? », le N2+ demande « comment ces données sont-elles exactement transformées ? »
Avec Visual Paradigm AI, toute l’échelle est conversationnelle : demandez le Niveau 0, demandez la décomposition, zoomez sur un processus à la fois, demandez des branches d’exception, et téléchargez des images pour numériser les diagrammes existants. Combiné à une stricte numérotation, équilibrage des flux, une légende de couleurs cohérente, et une déclaration puis connexion complète code, tout grand système reste navigable, non ambigu — et chaque diagramme s’affiche réellement. 🚀
Cette publication est également disponible en Deutsch, English : liste des langues séparées par une virgule, Español : dernière langue.