


1. Einführung in Datenflussdiagramme (DFD)
Ein Datenflussdiagramm (DFD) ist eine grafische Darstellung davon, wie Daten fließen durch ein System — und zeigen, wo Daten entstehen, wie sie transformiert werden, wo sie gespeichert sind und wohin sie letztendlich gelangen. Im Gegensatz zu Flussdiagrammen (die sich auf Steuerfluss und Abfolgen konzentrieren), DFDs betonen Datenbewegung und -transformation ohne sich um Zeitpunkte oder die Ausführungsreihenfolge kümmern zu müssen.
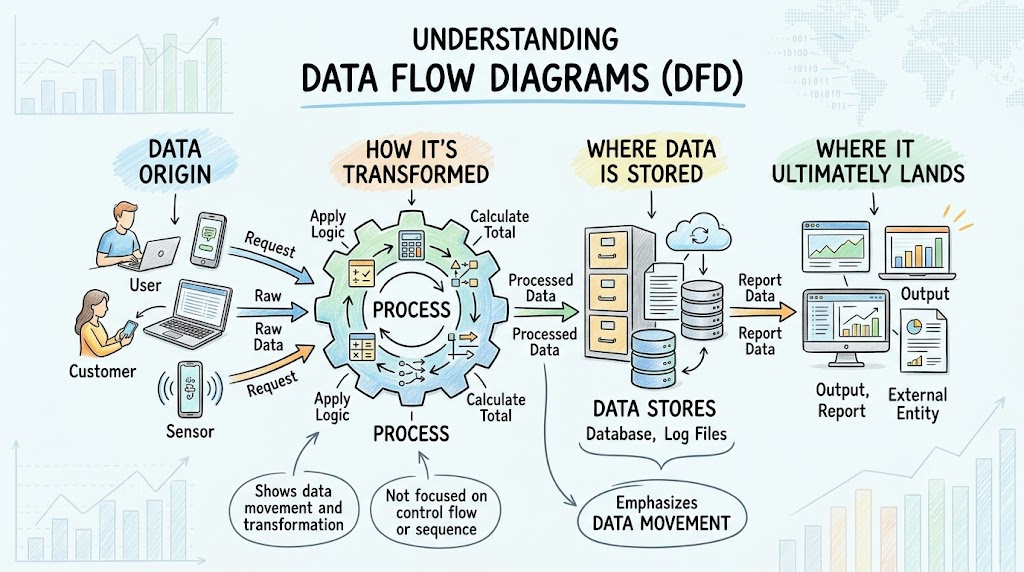
Warum DFDs verwenden DFDs?
- Ein bestehendes System analysieren oder Ein bestehendes System analysieren oder ein neues System entwerfenein neues System entwerfen
- Daten-Eingaben, -Ausgaben und -Speicher frühzeitig identifizieren
- Systemgrenzen und Datenanforderungen gegenüber den Beteiligten kommunizieren
- Komplexität von einer Übersichtsperspektive bis hin zu Implementierungsdetails zerlegen
2. Die vier Kernkomponenten eines DFD
Jedes DFD, auf jeder Ebene, besteht aus nur vier grundlegenden Elementen (Gane-Sarson-Notation):
| Komponente | Notation | Rolle | Beispiel |
|---|---|---|---|
| Externe Entität | Rechteck | Quelle oder Ziel von Daten außerhalb der Systemgrenze | Kunde, Zahlungs-Gateway |
| Prozess | Kreis | Transformiert eingehende Daten in ausgehende Daten | „Bestellung aufgeben“, „Zahlung autorisieren“ |
| Datenspeicher | Aufzeichnung / offenes Rechteck | Ein Ort, an dem Daten für die spätere Verwendung gespeichert werden | Bestellungen, Produktbestand |
| Datenfluss | Pfeil (beschriftet) | Die Bewegung von Daten zwischen den oben genannten Elementen | „Bestelldetails“, „Zahlungsstatus“ |
💡 Wichtige Regel: ein Prozess muss sowohl Eingangs- als auch Ausgangsflüsse haben. Ein Prozess mit nur Eingängen oder nur Ausgängen ist ein Modellierungsfehler — jede Transformation erzeugt ein Ergebnis.
3. DFD-Ebenen — Die Top-Down-Pyramide
Die Stärke der Top-Down-Zerlegung besteht darin, dass Sie mit Abstraktionen beginnen und hinzufügen Detail iterativ. Jede Ebene folgt einer standardisierten Nummerierungskonvention:
| Ebene | Name | Inhalt |
|---|---|---|
| Ebene 0 | Kontextdiagramm | Einzelner Prozess (das gesamte System), alle externen Entitäten und ihre Flüsse — keine Datenspeicher, keine internen Details |
| Ebene 1 | System-DFD | Das System wird in Hauptprozesse (1.0, 2.0, 3.0 …), interne Datenspeicher und Flüsse zerlegt |
| Ebene 2 | Teil-Diagramm | Ein einzelner Prozess der Ebene 1 wird in feinere Prozesse zerlegt (2.1, 2.2, 2.3 …) |
| Ebene 3 | Teil-Teil-Diagramm | Ein einzelner Prozess der Ebene 2 wird weiter zerlegt (2.2.1, 2.2.2, 2.2.3 …) |
Die Nummerierung zeigt Ihnen genau, wo Sie sich in der Hierarchie befinden — 2.2.4 gehört zu 2.2, das gehört zu 2.0. Diese Baumstruktur macht große Systeme überschaubar.
4. Der Hausstil (Farblegende)
Jedes Diagramm in diesem Leitfaden folgt einer einheitlichen visuellen Konvention. In Graphviz lautet die Vorgehensweise: zuerst formatieren, dann deklarieren, dann verbinden.
| Element | Form | Füllung | Rahmen | Zweck |
|---|---|---|---|---|
| Externe Entität | Box |
#E1F5FE |
#0288D1 |
Wer ist außerhalb |
| Prozess | Kreis |
#E8F5E9 |
#388E3C |
Was transformiert Daten |
| Datenspeicher | Eintrag |
#FFF9C4 |
#FBC02D |
Wo Daten ruhen |
| Übergeordneter Prozess (ref) | Kreis |
#FCE4EC |
#C2185B |
Kontext außerhalb des aktuellen Levels |
| Systemgrenze | gestrichelt, abgerundetCluster |
#FAFAFA / #757575 |
Grau | Grenze des aktuellen Diagramms |
| Datenfluss | Pfeil |
— | #555555 |
Bewegung von Daten |
⚠️ Wichtig — eine Stilvorlage ist KEIN Diagramm
Eine Graphviz-Datei, die nur Knoten-/Kantenstile definiert, aber niemals Knoten oder Kanten deklariert wird als leere Leinwand. Eine DFD benötigt drei Bestandteile in dieser Reihenfolge:
- Stilisiere den Graphen —
graph [...],node [...],edge [...]Attribute. - Deklarieren Sie die Elemente — externe Entitäten (Boxen), Prozesse (Kreise), Datenspeicher (Aufzeichnungen), umhüllt von einer gestrichelten
ClusterGrenze. - Zeichnen Sie die Flüsse — explizite
A -> B [label="..."]Kanten, unter Verwendung vondir=bothfür bidirektionale Austausche.
Vergleichen Sie diese beiden — beide werden beide validiert, aber nur das zweite erzeugt ein Bild:
❌ Nur Stil (erzeugt nichts):
digraph DFD {
    graph [rankdir = LR]
    node [shape = box, style = "filled", fillcolor = "#E1F5FE"]
    edge [color = "#555555", arrowsize = 0.8]
}
✅ Komplett (wird gerendert):
digraph DFD {
    graph [rankdir = LR]
    node [style = "filled", fillcolor = "#E1F5FE", shape = box]
    Customer;
    // ...plus Prozesse, Datenspeicher, Grenzen und Kanten
}
5. Der Top-Down-Zerlegungsprozess (Schritt für Schritt)
Der Online-Bestellprozesssystem demonstriert die Methodik. Auf jeder Ebene erhalten Sie vollständigen, ausführbaren Graphviz-Code.
Schritt 1 — Erstellen Sie das Kontextdiagramm (Ebene 0)
Beginnen Sie mit dem gesamten System als einen einzigen Prozess und identifizieren Sie jede Interaktion mit der Außenwelt. Keine Datenspeicher, keine internen Details.
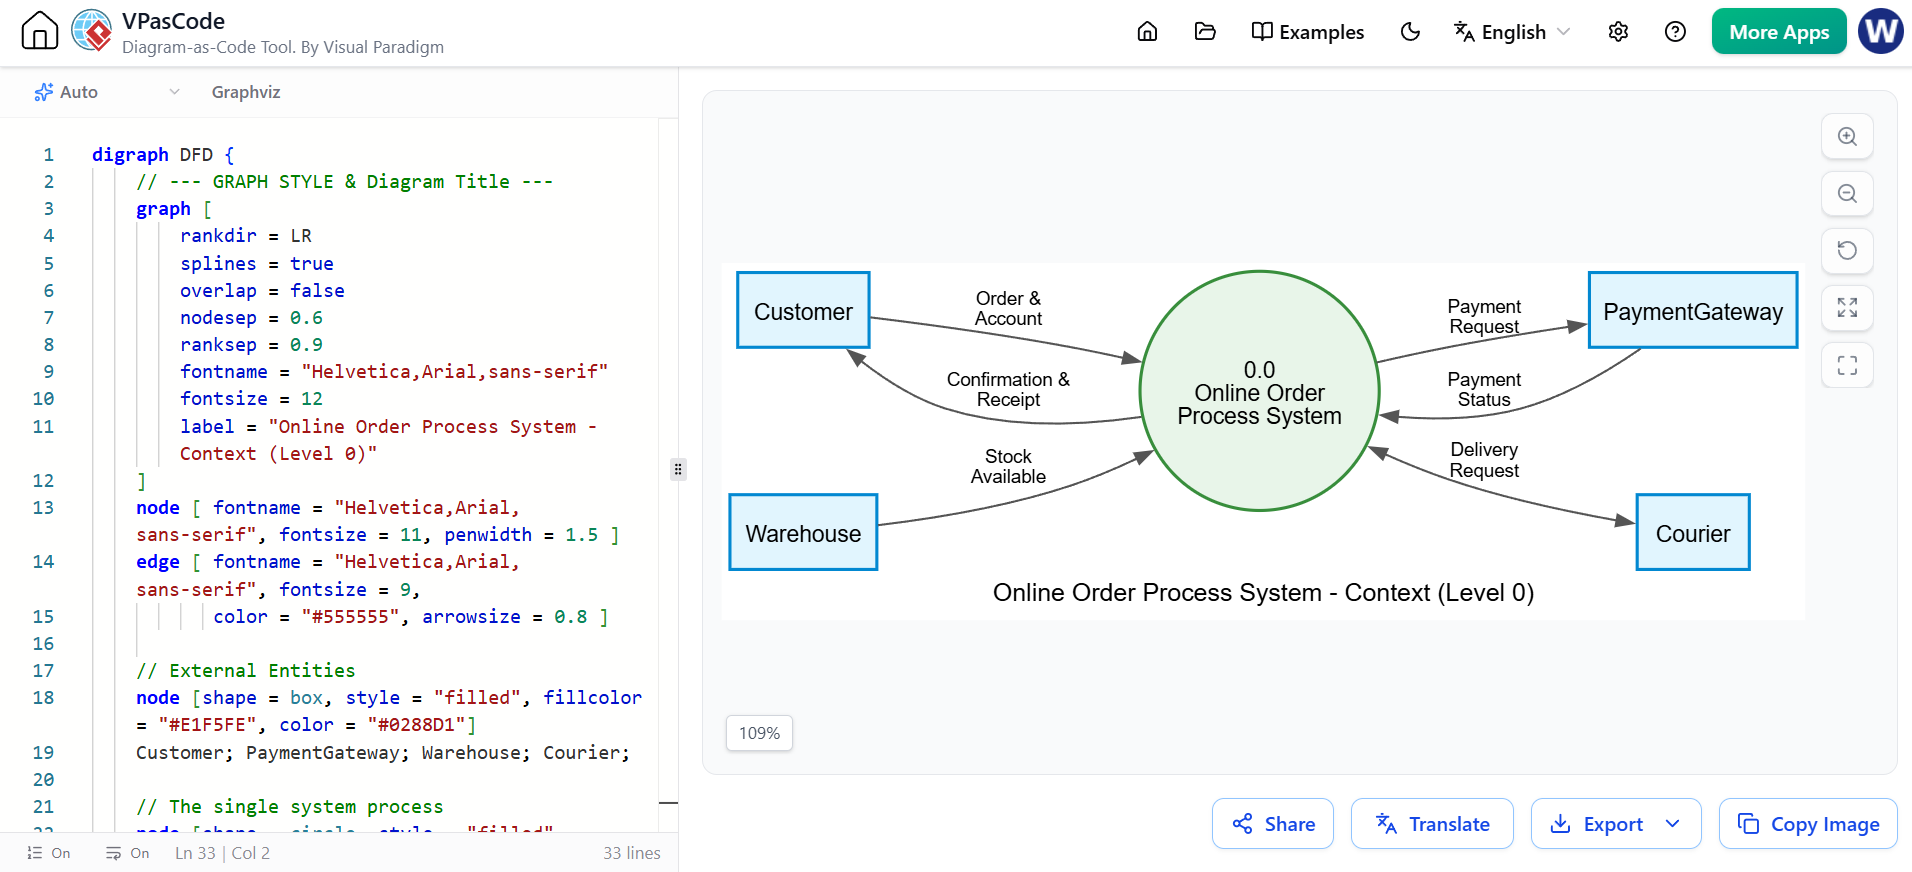
digraph DFD {
    // --- GRAPHSTIL & Diagrammtitel ---
    graph [
        rankdir = LR
        splines = true
        overlap = false
        nodesep = 0.6
        ranksep = 0.9
        fontname = "Helvetica,Arial,sans-serif"
        fontsize = 12
        label = "Online-Bestellprozesssystem - Kontext (Ebene 0)"
    ]
    node [ fontname = "Helvetica,Arial,sans-serif", fontsize = 11, penwidth = 1.5 ]
    edge [ fontname = "Helvetica,Arial,sans-serif", fontsize = 9,
           color = "#555555", arrowsize = 0.8 ]

    // Externe Entitäten
    node [shape = box, style = "filled", fillcolor = "#E1F5FE", color = "#0288D1"]
    Kunde; PaymentGateway; Lager; Kurier;

    // Der einzelne Systemprozess
    node [shape = circle, style = "filled", fillcolor = "#E8F5E9",
          color = "#388E3C", fixedsize = true, width = 1.6]
    System [label="0.0nOnline-BestellnProzesssystem"];

    // Datenflüsse (bidirektional, wo Daten in beide Richtungen ausgetauscht werden)
    Kunde -> System [label="Bestellung &nKonto"];
    System -> Kunde [label="Bestätigung &nQuittung"];
    System -> PaymentGateway [label="Zahlungsnanfrage"];
    PaymentGateway -> System [label="Zahlungsnstatus"];
    Lager -> System [label="Lagernvorrat"];
    System -> Kurier [label="Liefernanfrage", dir=both];
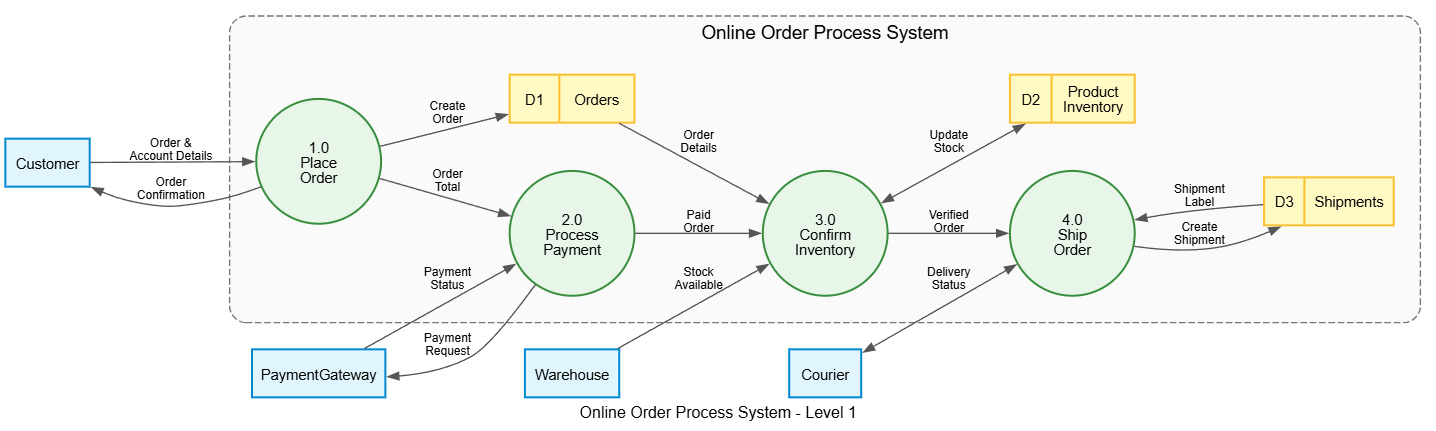
}Interpretation: Das Kontextdiagramm beantwortet „welche Grenzen hat dieses System und mit wem kommuniziert es?“ — es zeigt externe Entitäten und ihre Flüsse, verbirgt jedoch die gesamte interne Struktur. Wir sehen, dass das System Bestellungen von Kunden entgegennimmt, über PaymentGateway abrechnet, den Lagerbestand mit Lager abgleicht und die Erfüllung an Kurier.
Schritt 2 — Zerlegen in Ebene-1 (Hauptprozesse)
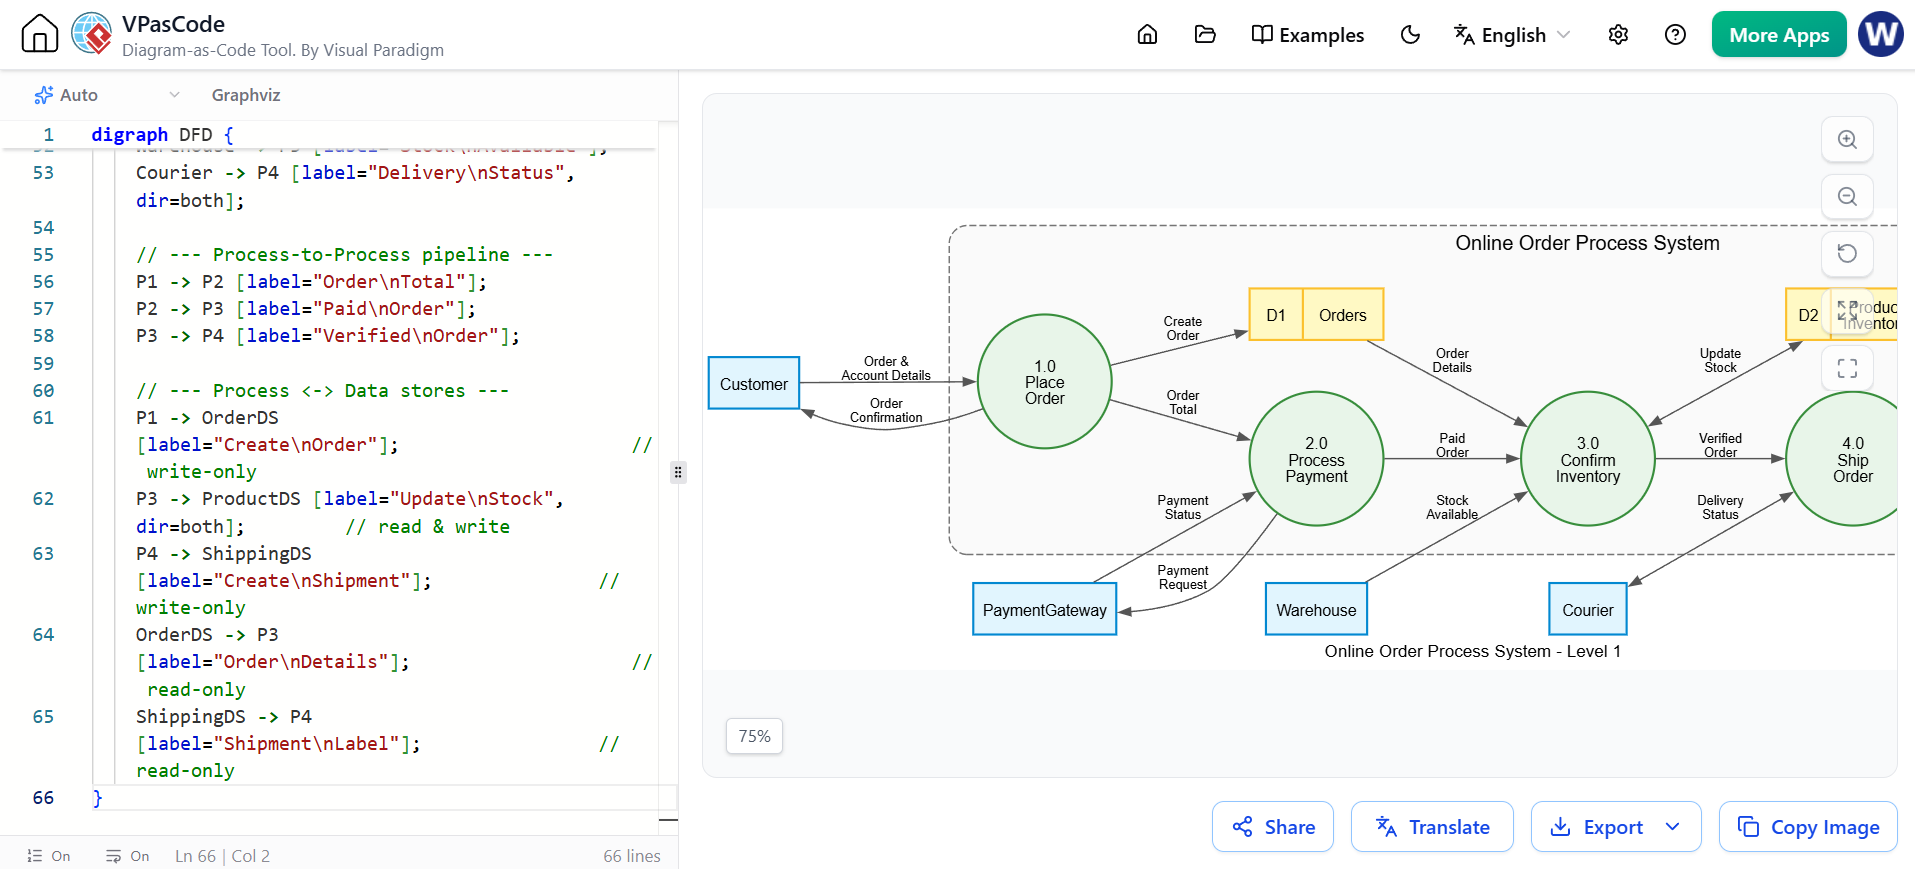
Zerlegen Sie den einzelnen Kontextprozess in die Schlüsselfunktionen und fügen Sie gemeinsame Datenspeicher hinzu. Umgeben Sie Prozesse + Speicher mit einer gestrichelten, abgerundeten Systemgrenze.
digraph DFD {
    // --- GRAPHSTIL & Diagrammtitel ---
    graph [
        rankdir = LR
        splines = true
        overlap = false
        nodesep = 0.5
        ranksep = 0.8
        fontname = "Helvetica,Arial,sans-serif"
        fontsize = 12
        label = "Online-Bestellprozesssystem - Ebene 1"
    ]
    node [ fontname = "Helvetica,Arial,sans-serif", fontsize = 11, penwidth = 1.5 ]
    edge [ fontname = "Helvetica,Arial,sans-serif", fontsize = 9,
           color = "#555555", arrowsize = 0.8 ]

    // Externe Entitäten
    node [shape = box, style = "filled", fillcolor = "#E1F5FE", color = "#0288D1"]
    Kunde; PaymentGateway; Lager; Kurier;

    // --- SYSTEMGRENZEN-CONTAINER ---
    subgraph cluster_SystemBoundary {
        label = "Online-Bestellprozesssystem";
        fontname = "Helvetica,Arial,sans-serif"
        fontsize = 14
        color = "#757575"
        style = "dashed,rounded"
        bgcolor = "#FAFAFA"
        margin = 20

        // Prozesse (grüne Kreise)
        node [shape = circle, style = "filled", fillcolor = "#E8F5E9",
              color = "#388E3C", fixedsize = true, width = 1.3]
        P1 [label="1.0nBestellungnAufgeben"];
        P2 [label="2.0nZahlungnVerarbeiten"];
        P3 [label="3.0nLagerbestandnBestätigen"];
        P4 [label="4.0nBestellungnVersenden"];

        // Datenspeicher (gelbe Datensätze)
        node [shape = record, style = "filled", fillcolor = "#FFF9C4",
              color = "#FBC02D", fixedsize = false]
        OrderDS    [label="{ D1 | Bestellungen }"];
        ProductDS  [label="{ D2 | ProduktnLagerbestand }"];
        ShippingDS [label="{ D3 | Sendungen }"];
    }

    // --- DATENFLOWS: Externe Entitäten ---
    Kunde -> P1 [label="Bestellung &nKontodetails"];
    P1 -> Kunde [label="BestellnBestätigung"];
    P2 -> PaymentGateway [label="Zahlungsnanfrage"];
    PaymentGateway -> P2 [label="Zahlungsnstatus"];
    Lager -> P3 [label="Lagerbestandnverfügbar"];
    Kurier -> P4 [label="Lieferstatus", dir=both];

    // --- Prozess-zu-Prozess-Pipeline ---
    P1 -> P2 [label="BestellnGesamtsumme"];
    P2 -> P3 [label="BezahltenBestellung"];
    P3 -> P4 [label="VerifiziertenBestellung"];

    // --- Prozess <-> Datenspeicher ---
    P1 -> OrderDS [label="Bestellungnerstellen"];                     // schreibgeschützt
    P3 -> ProductDS [label="Lagerbestandnaktualisieren", dir=both];         // lesen & schreiben
    P4 -> ShippingDS [label="Sendungnerstellen"];               // schreibgeschützt
    OrderDS -> P3 [label="Bestelldetails"];                    // lesegeschützt
    ShippingDS -> P4 [label="Sendungsnetikett"];                // lesegeschützt
}
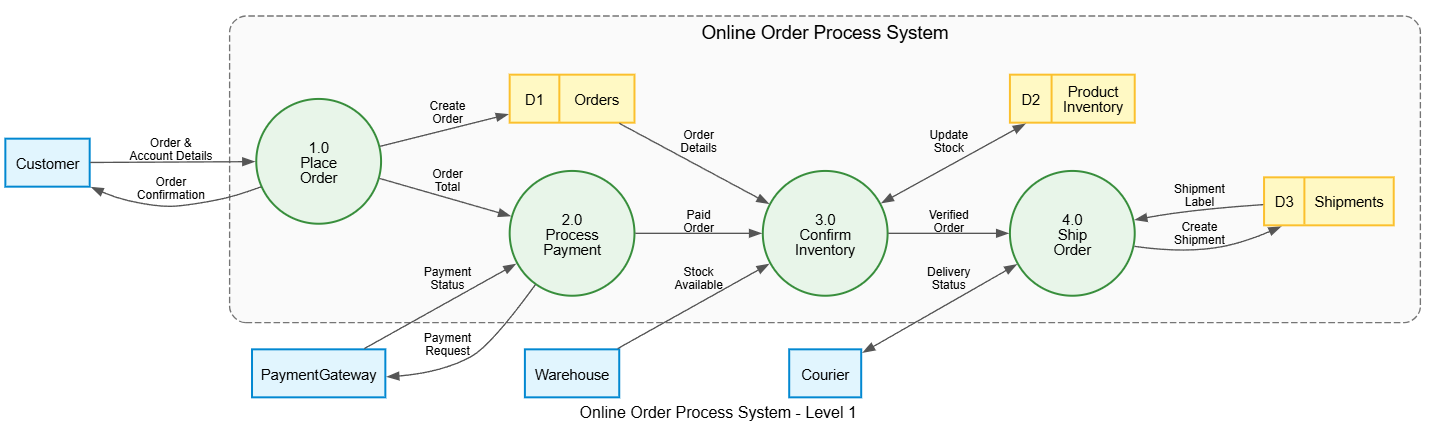 Interpretation:
- Die lineare Kette
P1 → P2 → P3 → P4zeigt einen geordneten Pipeline: Eine Bestellung wird vor der Zahlung, vor der Lagerbestandsprüfung und vor dem Versand aufgegeben. - Die Zahlungs-Gateway-Austausch verwendet zwei einseitige Pfeile (
Zahlungsanfragenach außen,Zahlungsstatusnach innen). - Datenspeicher fungieren als Zustand:
P1schreibt Bestellungen,P3liest & aktualisiert Lagerbestand (dir=both),P4schreibt Sendungen. P3 → ProductDSverwendetdir=both— eine Kante, nicht zwei — weil der Prozess sowohl Lagerbestände liest als auch aktualisiert.
Schritt 3 — Detaillierung: Ebene-2 (Fokus auf einen Prozess)
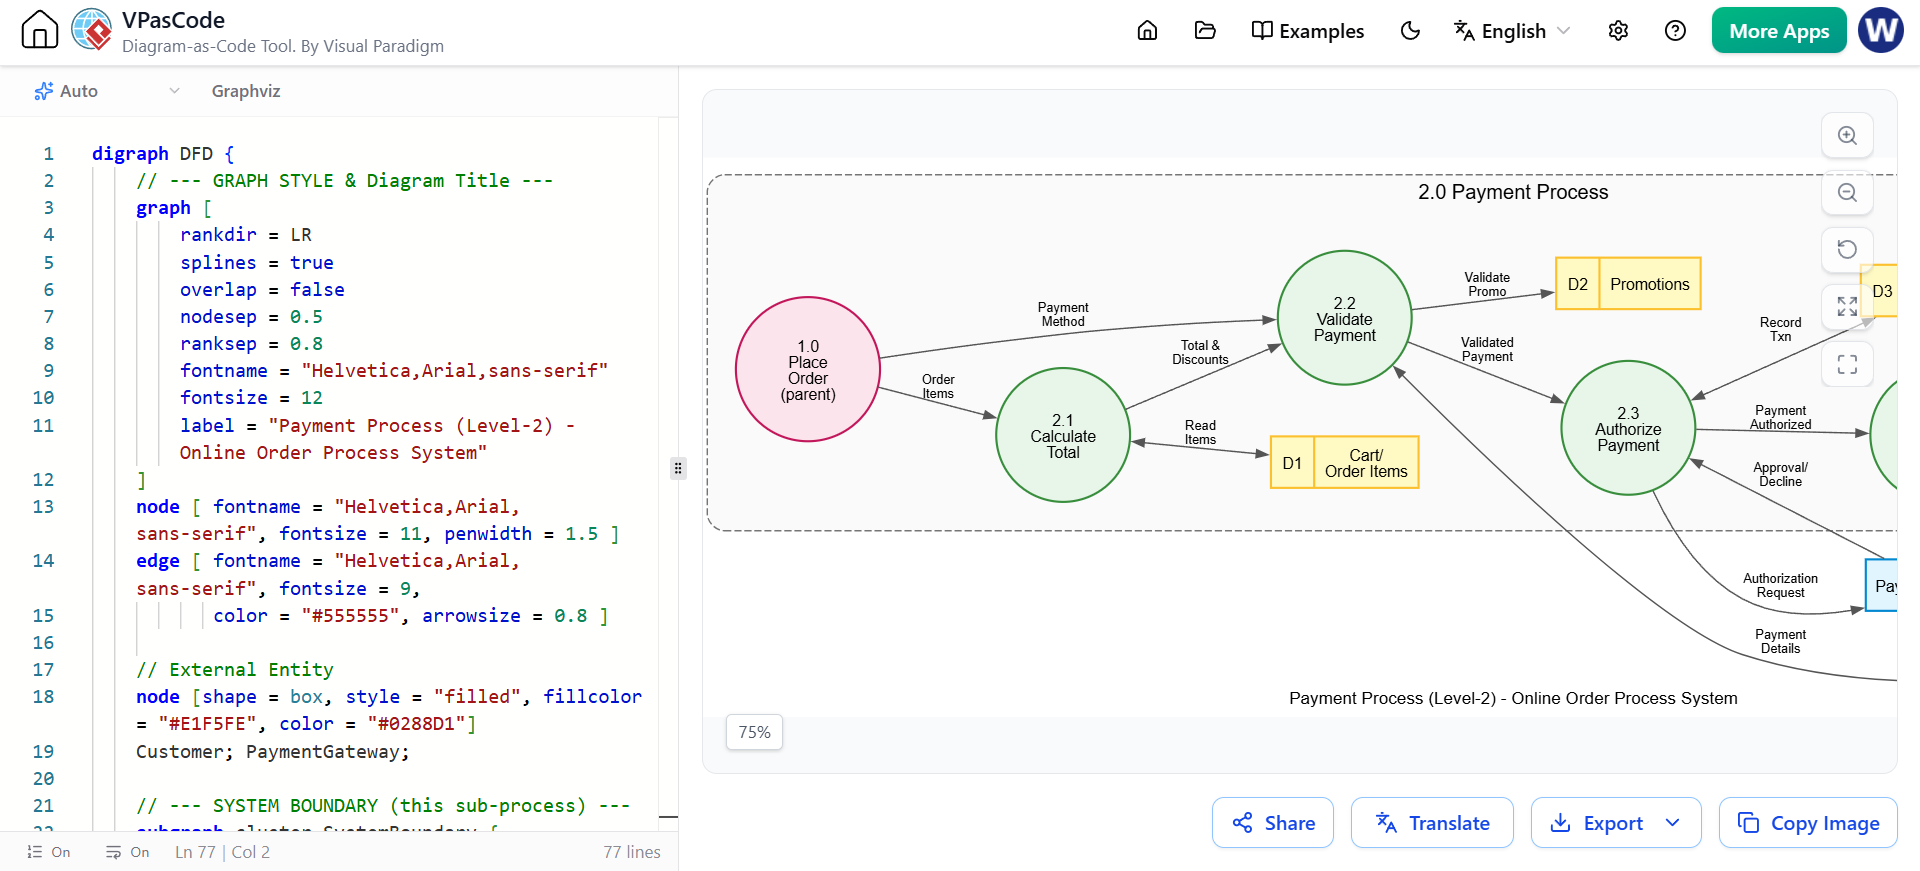
Wählen Sie einen Prozess der Ebene-1 und zerlegen Sie ihn nur diesen einen. Zeigen Sie übergeordnete Prozesse am Rand (rosa), damit Sie den Kontext behalten, sowie Teilprozesse, Teilspeicher und Flüsse.
digraph DFD {
    // --- GRAPHSTIL & Diagrammtitel ---
    graph [
        rankdir = LR
        splines = true
        overlap = false
        nodesep = 0.5
        ranksep = 0.8
        fontname = "Helvetica,Arial,sans-serif"
        fontsize = 12
        label = "Zahlungsprozess (Ebene-2) - Online-Bestellsystem"
    ]
    node [ fontname = "Helvetica,Arial,sans-serif", fontsize = 11, penwidth = 1.5 ]
    edge [ fontname = "Helvetica,Arial,sans-serif", fontsize = 9,
           color = "#555555", arrowsize = 0.8 ]

    // Externe Entität
    node [shape = box, style = "filled", fillcolor = "#E1F5FE", color = "#0288D1"]
    Kunde; PaymentGateway;

    // --- SYSTEMGRENZE (dieser Teilprozess) ---
    subgraph cluster_SystemBoundary {
        label = "2.0 Zahlungsprozess";
        fontname = "Helvetica,Arial,sans-serif"
        fontsize = 14
        color = "#757575"
        style = "dashed,rounded"
        bgcolor = "#FAFAFA"
        margin = 20

        // Teilprozesse (grüne Kreise)
        node [shape = circle, style = "filled", fillcolor = "#E8F5E9",
              color = "#388E3C", fixedsize = true, width = 1.3]
        P21 [label="2.1nBerechnennGesamt"];
        P22 [label="2.2nValidierennZahlung"];
        P23 [label="2.3nAutorisierennZahlung"];
        P24 [label="2.4nBestätigennBestellung"];

        // Teildatenspeicher (gelbe Datensätze)
        node [shape = record, style = "filled", fillcolor = "#FFF9C4",
              color = "#FBC02D", fixedsize = false]
        CartDS   [label="{ D1 | Warenkorb/nBestellpositionen }"];
        PromoDS  [label="{ D2 | Aktionen }"];
        PaymentDS [label="{ D3 | ZahlungsnTransaktionen }"];
        OrderDS  [label="{ D4 | Bestellungen }"];

        // Übergeordnete Prozesse (rosa) – Kontext aus höherer Ebene
        node [shape = circle, style = "filled", fillcolor = "#FCE4EC",
              color = "#C2185B", fixedsize = true, width = 1.4]
        P1 [label="1.0nBestellungnAufgebenn(übergeordnet)"];
        P3 [label="3.0nLagerbestandnBestätigenn(übergeordnet)"];
    }

    // Flüsse von übergeordneten Prozessen / Kunden in Teilprozesse
    P1 -> P21 [label="BestellnPositionen"];
    P1 -> P22 [label="Zahlungsnmethode"];
    Kunde -> P22 [label="Zahlungsndetails"];

    // Teilprozesskette
    P21 -> P22 [label="Gesamt &nRabatte"];
    P22 -> P23 [label="ValidiertenZahlung"];
    P23 -> P24 [label="Zahlungnautorisiert"];

    // Interaktion mit externem Gateway
    P23 -> PaymentGateway [label="Autorisierungsnanfrage"];
    PaymentGateway -> P23 [label="Genehmigung/nAblehnung"];

    // Ausgabe an übergeordnete Prozesse / Kunden
    P24 -> P3 [label="BezahltenBestellung"];
    P24 -> Kunde [label="Zahlungsnbeleg"];

    // Zugriffe auf Datenspeicher
    P21 -> CartDS [label="Positionennlesen", dir=both];
    P22 -> PromoDS [label="Aktionnvalidieren"];
    P23 -> PaymentDS [label="Transaktionnprotokollieren", dir=both];
    P24 -> OrderDS [label="Statusnaktualisieren"];
}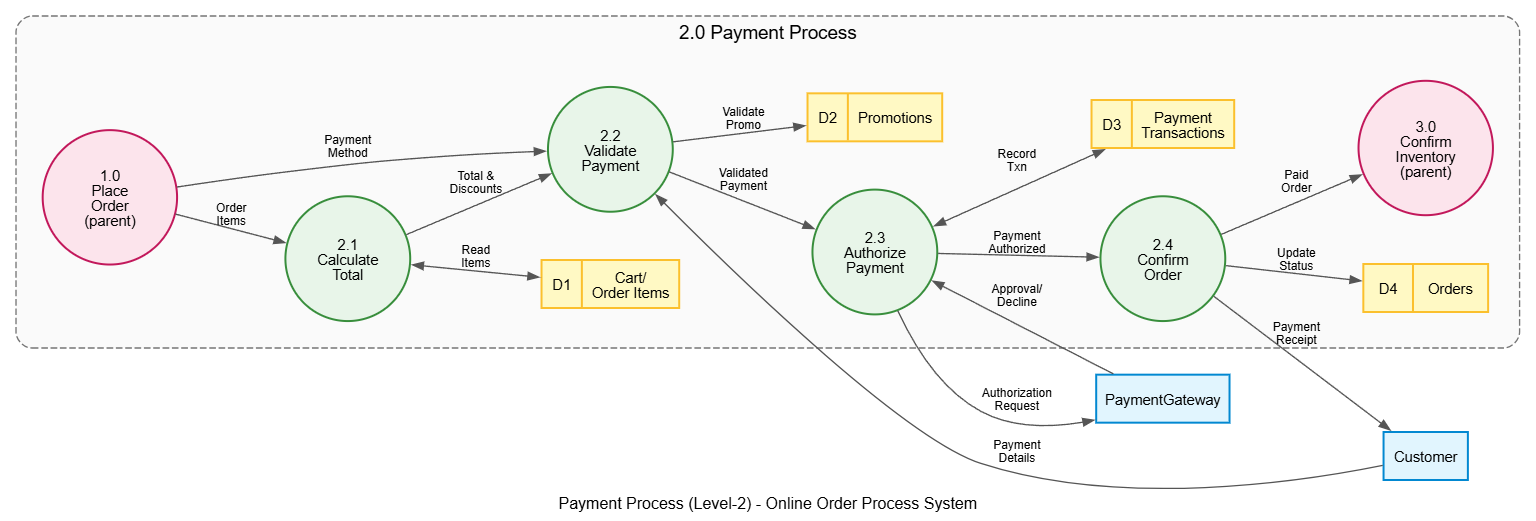 Interpretation (im Vergleich zu Ebene-1):
- 2.1 Gesamt berechnen ist ein reine Berechnung — liest Warenkorbeinträge, erzeugt eine Zahl, keine externe Ein-/Ausgabe außer über Speicher.
- 2.3 Zahlung autorisieren ist der einzige Schritt, der mit dem externen Zahlungsgateway — Geldbewegungen sind sauber isoliert.
- Die
BestellungenSpeicher erscheint erneut, weil 2.4 aktualisiert den Bestellstatus (ursprünglich geschrieben von 1.0 auf Ebene-1). - Die Kette
2.1 → 2.2 → 2.3 → 2.4ist ein sequenzieller Validierungspipeline bevor übergeben an 3.0 (rosa übergeordneter Prozess). - Übergeordnete Prozesse 1.0 & 3.0 sind in Rosa dargestellt außerhalb der Grenze, um zu verankern, wo die Flüsse beginnen und enden.
Schritt 4 — Nochmal ins Detail gehen: Ebene-3 (rekursiv wiederholen)
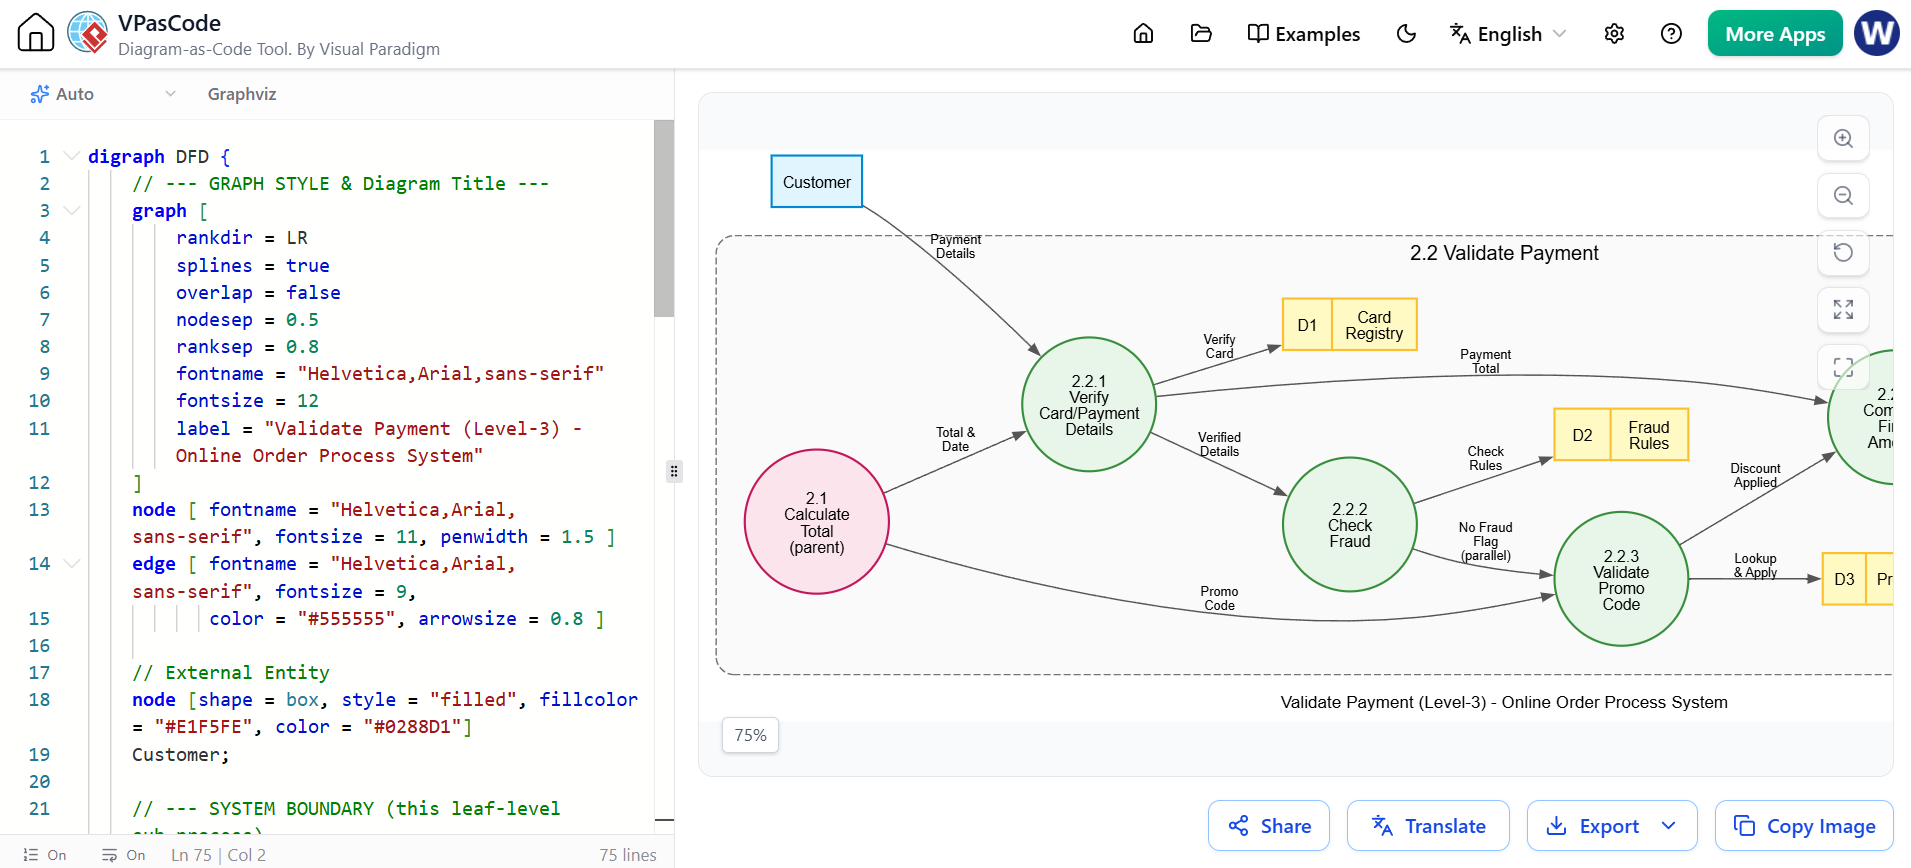
Wenden Sie dieselbe Technik auf jeden noch zu komplexen Teilprozess an. Wir zoomen in 2.2 Zahlung validieren.
digraph DFD {
    // --- GRAPH STYLE & Diagram Title ---
    graph [
        rankdir = LR
        splines = true
        overlap = false
        nodesep = 0.5
        ranksep = 0.8
        fontname = "Helvetica,Arial,sans-serif"
        fontsize = 12
        label = "Zahlung validieren (Ebene-3) - Online-Bestellprozesssystem"
    ]
    node [ fontname = "Helvetica,Arial,sans-serif", fontsize = 11, penwidth = 1.5 ]
    edge [ fontname = "Helvetica,Arial,sans-serif", fontsize = 9,
           color = "#555555", arrowsize = 0.8 ]

    // External Entity
    node [shape = box, style = "filled", fillcolor = "#E1F5FE", color = "#0288D1"]
    Customer;

    // --- SYSTEM BOUNDARY (this leaf-level sub-process) ---
    subgraph cluster_SystemBoundary {
        label = "2.2 Zahlung validieren";
        fontname = "Helvetica,Arial,sans-serif"
        fontsize = 14
        color = "#757575"
        style = "dashed,rounded"
        bgcolor = "#FAFAFA"
        margin = 20

        // Leaf processes (green circles)
        node [shape = circle, style = "filled", fillcolor = "#E8F5E9",
              color = "#388E3C", fixedsize = true, width = 1.3]
        P221 [label="2.2.1nKarte/ZahlungsnDetailsnüberprüfen"];
        P222 [label="2.2.2nBetrugnprüfen"];
        P223 [label="2.2.3nGutscheinncodenvalidieren"];
        P224 [label="2.2.4nEndbetragnberechnen"];

        // Leaf data stores (yellow records)
        node [shape = record, style = "filled", fillcolor = "#FFF9C4",
              color = "#FBC02D", fixedsize = false]
        CardDS  [label="{ D1 | KartenRegister }"];
        FraudDS [label="{ D2 | Betrugsnregeln }"];
        PromoDS [label="{ D3 | Aktionen }"];
        CartDS  [label="{ D4 | Warenkorb/nBestellpositionen }"];

        // Parent processes (pink)
        node [shape = circle, style = "filled", fillcolor = "#FCE4EC",
              color = "#C2185B", fixedsize = true, width = 1.4]
        P21 [label="2.1nGesamtnberechnenn(übergeordnet)"];
        P23 [label="2.3nZahlungnautorisiertn(übergeordnet)"];
    }

    // Inputs
    P21 -> P221 [label="Gesamt &nDatum"];
    Customer -> P221 [label="Zahlungsndetails"];

    // Sequential validation, with parallel branch
    P221 -> P222 [label="ÜberprüftenDetails"];
    P222 -> P223 [label="Kein BetrugsnFlagn(parallel)"];

    // Feed the final computation
    P21 -> P223 [label="Gutscheinncode"];
    P221 -> P224 [label="ZahlungnGesamt"];
    P223 -> P224 [label="Rabattnangewendet"];

    // Output to parent
    P224 -> P23 [label="Validierter &nrabattierternGesamt"];

    // Data store accesses
    P221 -> CardDS [label="Kartenüberprüfen"];
    P222 -> FraudDS [label="Regelnnprüfen"];
    P223 -> PromoDS [label="Nachschlagenn& Anwenden"];
    P224 -> CartDS [label="Positionennlesen", dir=both];
}
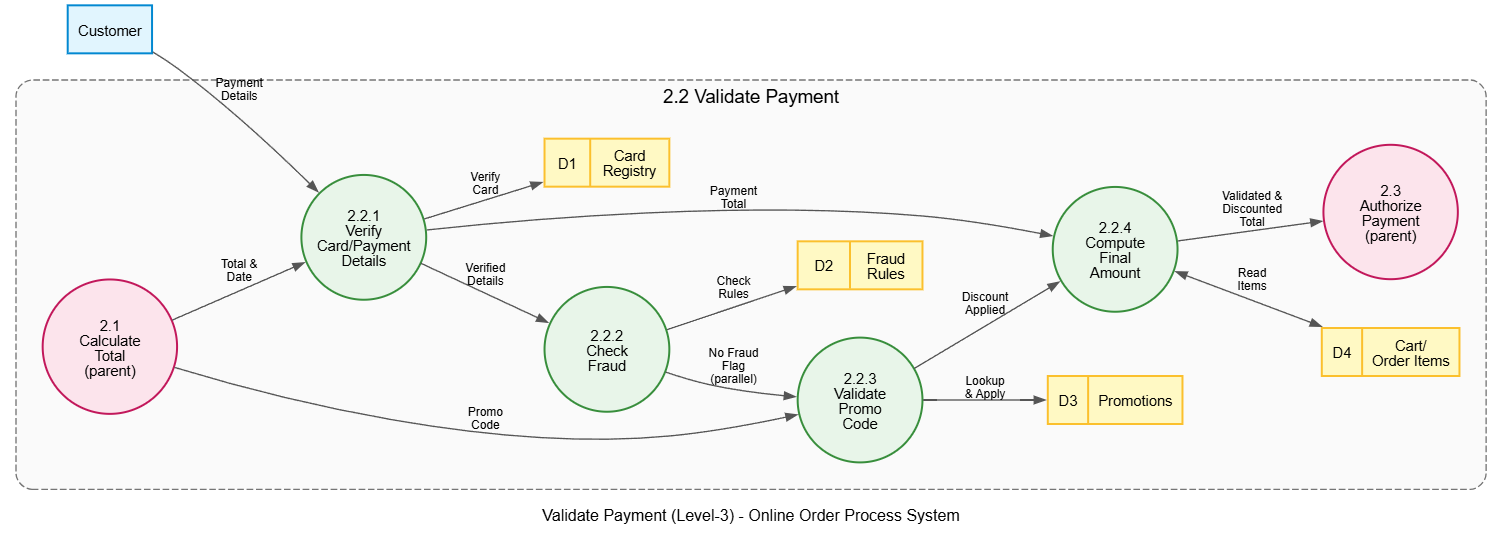 Interpretation:
- 2.2.1 Karte überprüfen ist ein Tor — es muss erfolgreich abgeschlossen sein, bevor die Betrugsprüfung beginnt.
- 2.2.2 (Betrug) und 2.2.3 (Promo) laufen in Parallelität: beide lesen Regeln und beide speisen die Endberechnung. Das Label „(parallel)” kennzeichnet dies.”
- 2.2.4 Endbetrag berechnen ist ein Fan-In Punkt — er verbindet
Zahlungssumme+Rabattzu einem einzigen validierten Ausgang, der zum übergeordneten Element führt 2.3. - Kartenregister und Betrugsregeln sind Detail-Level-Speicher, die auf Ebene 2 nicht sichtbar sind — neue Speicher entstehen natürlich, wenn Sie zerlegen.
Schritt 5 — Stoppen, wenn Prozesse „primitiv” sind”
Weiter zerlegen, bis jeder Prozess ein einzige, eindeutige, umsetzbare Aktion. Es gibt keine feste Tiefe; stoppen Sie, wenn ein Prozess eindeutig einer einzigen Funktion oder einer einzigen Entscheidung zugeordnet werden kann. Die oben genannten Ebenen 2.2.1–2.2.4 sind bereits primitiv.
6. Best Practices & häufige Fallstricke
✅ Best Practices
- Nummerieren Sie Prozesse hierarchisch (
2.2.4) damit jedes Diagramm im Baum selbst lokalisiert ist. - Zeichnen Sie übergeordnete Prozesse am Rand (rosa), damit Flüsse den Kontext behalten — versäumen Sie niemals, einen Eingabe-/Ausgabewert zu isolieren.
- Verwenden Sie eine einzige bidirektionale Kante (
dir=both) für Zwei-Wege-Austausche anstelle von zwei separaten Pfeilen. Reduziert Unordnung. - Halten Sie Beschriftungen beschreibend, aber kurz („Zahlung autorisieren“, nicht „AP“).
- Zerlegen Sie jeweils nur einen Prozess — jede Ebene ist ihr eigenes Diagramm; quetschen Sie nicht mehrere Ebenen in eines.
- Balancieren Sie die Diagramme — Eingaben/Ausgaben auf einer übergeordneten Ebene müssen den kombinierten Eingaben/Ausgaben ihrer Kinder entsprechen (Ausgleichsregel).
- Deklarieren Sie immer Elemente — eine Vorlage, die nur Stil definiert und keine Knoten oder Kanten deklariert, rendert eine leere Leinwand. Jedes DFD muss Stil definieren, dann deklarieren, dann verbinden.
- Benennen Sie Datenspeicher eindeutig innerhalb von Kind-Diagrammen, aber nummerieren Sie lokal neu (D1, D2 …) für Selbstständigkeit.
❌ Häufige Fallstricke
- Isolierte Prozesse — ein Prozess ohne Eingabe oder Ausgabe. Jeder Prozess transformiert etwas.
- Fehlende Ausgewogenheit — ein Fluss erscheint auf Ebene-1, aber keiner seiner Level-2-Kinder erzeugt oder verbraucht ihn.
- Vorzeitige Detaillierung — die Darstellung von Datenspeichern im Level-0-Kontextdiagramm (sie gehören nur auf niedrigeren Ebenen).
- Denken in Kontrollflüssen — Schleifen oder Entscheidungssymbole in ein DFD einzufügen; das gehört in Flussdiagramme. DFDs zeigen Daten, nicht die Reihenfolge.
- Zwei parallele Pfeile für das, was eigentlich eines sein sollte
dir=bothKante — erzeugt überflüssige Doppelstriche. - Falsche Zugriffsrichtung auf den Datenspeicher — einen Datenspeicher als schreibgeschützt markieren, obwohl er tatsächlich beschrieben wird (oder umgekehrt).
- Stilvorlage fälschlich als Diagramm interpretiert — das Vergessen der Deklaration von Knoten und Kanten führt zu einem leeren Graphen.
7. Checkliste zur Top-Down-Verifikation
Bevor Sie ein Diagramm präsentieren, prüfen Sie:
- ✅ Jeder Prozess hat ≥1 Eingabe und ≥1 Ausgabe.
- ✅ Jede Flussbeschriftung ist ein Substantiv („Bestelldetails“), kein Verb.
- ✅ Jeder Datenspeicher wird an irgendeinem Punkt gelesen und beschrieben (außer bei eindeutig externen Referenzdaten).
- ✅ Ebenengrenzen ausgleichen: Kinder verbrauchen und erzeugen genau das, was ihr Elternteil ausgetauscht hat.
- ✅ Externe Entitäten erscheinen nur an den Rändern, niemals innerhalb einer Grenze.
- ✅
dir=bothwird für zweiseitige Austausche verwendet; andernfalls werden einseitige Pfeile verwendet. - ✅ Rosa Verweise auf übergeordnete Prozesse zeigen korrekt das zu zerlegende Level an.
- ✅ Der Code definiert echte Knoten, Kanten und einen Rand — es ist nicht nur eine Stilregel.
8. Zusammenfassung des Top-Down-Zerlegungsprozesses
Die Top-Down-DFD-Zerlegung ist eine Reise von Abstraktion zu Details:
- Kontext (L0) — eine Box, alle Grenzen und externe Entitäten.
- System (L1) — Hauptprozesse, Speicher und die Datenpipeline.
- Teil-Diagramme (L2, L3…) — zoomen Sie rekursisch schrittweise in einen Prozess hinein, wobei der übergeordnete Kontext sichtbar bleibt und lokale Speicher nummeriert werden.
Jedes Level beantwortet eine andere Frage: L0 fragt: „Was ist der Fußabdruck des Systems?“, L1 fragt: „Was sind die Hauptdatenflüsse?“, L2+ fragt: „Wie wird diese Daten genau transformiert?”
Das Online-Bestellprozess Beispiel demonstriert die vollständige Kette in vollständigem, ausführbarem Graphviz-Code — von einem 4-Entitäten-Kontextdiagrammbis hin zu einer 4-Schritt-Validierungsroutine (2.2.1 → 2.2.4). Durch Nummerierung der Stämme, Ausbalancieren der Flüsse, unter Einhaltung einer konsistenten Farblegende (blaue Kästchen, grüne Kreise, gelbe Datensätze, rosa Verweise auf übergeordnete Elemente, gestrichelte graue Umrandung) und immer jeden Knoten/Kante explizit zu deklarierenbleibt jedes große System übersichtlich und eindeutig — und jedes Diagramm wird tatsächlich gerendert.
9. Werkzeuge: Erstellen einer DFD-Top-Down-Zerlegung mit Visual Paradigm AI
Visual Paradigm AI integriert einen KI-Chatbot direkt in das ModellierungswerkzeugAnstatt jede Ebene von Hand zu zeichnen, können Sie die gesamte Zerlegung dialogbasiert steuern und das Ergebnis anschließend verfeinern. So verwenden Sie es genau für den in diesem Leitfaden beschriebenen Ansatz.
9.1 Kernfunktionen für DFD-Arbeiten
Der VP AI Chatbot ist ein Text- und Code-Assistent , der dialogbasiert mit Ihnen zusammenarbeitet. Für die DFD-Top-Down-Zerlegung kann er:
| Fähigkeit | Was es für Sie tut |
|---|---|
| Diagrammcode generieren | Graphviz (DOT) für eine gegebene Prozessbeschreibung erzeugen — Ebene für Ebene |
| Angehängte Bilder analysieren | Ein von Ihnen hochgeladenes handgezeichnetes oder bestehendes DFD-Bild lesen und in strukturierte Modelle umwandeln |
| Iterativ verfeinern | Ihr Feedback („Zoom auf 2.2“, „Zweig ‚Rückgang‘ hinzufügen“) aufnehmen und das Diagramm neu generieren |
| Interpretationen erklären | Durchgehen, was jede Entität, jeder Prozess, jeder Speicher und jeder Fluss bedeutet |
| Syntax validieren | Prüfen, dass das DOT strukturell korrekt ist, bevor Sie es rendern |
| Strategie-/Diagrammausgabe erzeugen | Unterstützende Diagramme oder Rahmenwerke erzeugen, die das DFD begleiten (z. B. eine Swimlane oder einen Organisationskontext) |
📌 Hinweis: Visual Paradigm unterstützt eine Reihe von Diagrammnotationen. Bevorzugen Sie BPMN für die Geschäftsprozessmodellierung, die Start-/Endereignisse, Gateways und Schwimmbahnen erfordert; verwenden Sie Graphviz-basierte DFDs für eine strenge Datenflussmodellierung, wie sie in diesem Leitfaden durchgehend dargestellt wird.
9.2 Durchgeführtes Dialogbeispiel — Zerlegung des Online-Bestellprozesses
Hier ist eine realistische Chat-Sitzung, die den von uns durchgeführten Schritten entspricht. Beachten Sie, wie jeder Prompt eine Ebene tiefer zoomt — genau die Top-Down-Methodik.
Prompt 1 — Starten Sie das Kontextdiagramm:
„Erstellen Sie ein Kontextdiagramm (Ebene 0) für ein System zum Online-Bestellprozess. Externe Entitäten: Kunde, Payment-Gateway, Lager, Kurier.“
VP AI antwortet mit einem DFD der Ebene 0 — einem zentralen Prozess, vier externen Entitäten und deren Flüssen — den Sie in ein Diagramm einfügen.
Prompt 2 — Fügen Sie die Detailebene hinzu:
„Zerlegen Sie es nun in ein DFD der Ebene 1 mit den Prozessen: 1.0 Bestellung aufgeben, 2.0 Zahlung verarbeiten, 3.0 Lagerbestand bestätigen, 4.0 Bestellung versenden. Fügen Sie Datenspeicher für Bestellungen, Produktbestand und Sendungen hinzu.“
VP AI liefert zurück das Diagramm der Ebene 1 mit sequentiell verketteten Prozessen, angehängten Speichern und erhaltenen Flüssen externer Entitäten — die Pipeline, die Sie in Schritt 2 des Leitfadens gesehen haben.
Prompt 3 — Zoomen Sie in einen Prozess hinein:
„Zoomen Sie in 2.0 Zahlung verarbeiten. Erstellen Sie ein Teil-Diagramm der Ebene 2 mit 2.1 Gesamtbetrag berechnen, 2.2 Zahlung validieren, 2.3 Zahlung autorisieren, 2.4 Bestellung bestätigen. Behalten Sie 1.0 und 3.0 als Elternreferenzen bei.“
VP AI erzeugt das Teil-Diagramm der Ebene 2: Teilprozesse, lokale Speicher (D1–D4), die Payment-Gateway-Interaktion und rosa Elternreferenzen für 1.0 und 3.0 — passend zu Schritt 3.
Prompt 4 — Gehen Sie erneut tiefer:
„Gehen Sie in 2.2 Zahlung validieren als Diagramm der Ebene 3 hinein: 2.2.1 Karte überprüfen, 2.2.2 Betrug prüfen, 2.2.3 Promo validieren, 2.2.4 Endbetrag berechnen. Fügen Sie Speicher für Kartenregister, Betrugsregeln, Promotionen und Warenkorbelemente hinzu.“
VP AI generiert das Blatt-Diagramm der Ebene 3 mit der Fan-In-Berechnung (2.2.4) und den parallelen Betrugs-/Promo-Zweigen — genau Schritt 4.
Prompt 5 — Fügen Sie die Ausnahmebehandlung hinzu:
„Fügen Sie den Fehlerpfad hinzu: Wenn 2.2.2 Betrug prüfen die Transaktion markiert, leiten Sie sie an einen Prozess für Stornierungshinweis zurück zum Kunden weiter.“
VP AI verfeinert das Diagramm mit einer Ablehnungs-Zweig und gleicht die Flüsse automatisch neu aus.
9.3 Funktionsfähige Prompting-Muster
Verwenden Sie diese Muster, um zuverlässige Ergebnisse gemäß der Methodik zu erhalten:
| Ziel | Beispiel-Prompt |
|---|---|
| Eine Ebene tiefer zerlegen | „In „Zoomen3.0 Lagerbestand bestätigen als Level-2-Teil-Diagramm.” |
| Nummerierung angeben | „Nummerierte Prozesse verwenden „2.1, 2.2, 2.3.” |
| Elternkontext erhalten | „Behalten „1.0 und „3.0 als Elternreferenzen am Rand.” |
| Datenspeicher hinzufügen | „Speicher einschließen: „D1 Warenkorbartikel, D2 Aktionen.” |
| Zweiseitigen Fluss anzeigen | „Verwenden „dir=both für Prozess↔Speicher-Lese- und Schreibvorgänge.” |
| Balanciere das Level | „Stellen Sie sicher, dass die Eingaben und Ausgaben dem übergeordneten Level entsprechen.“ |
| Fügen Sie einen Fehlerpfad hinzu | „Fügen Sie einen Ausnahmepfad hinzu, wenn die Zahlung abgelehnt wird.” |
| Begrenzen Sie die Tiefe | „Stoppen Sie bei primitiven Prozessen — einzelne, umsetzbare Aktionen.“ |
9.4 Hochladen eines Bildes zur Analyse
Wenn Sie bereits eine handgezeichnete oder veraltete DFD haben und diese digitalisiert werden soll:
- Fügen Sie das Bild an an den Chat an (ein Screenshot, Foto oder Export einer bestehenden DFD).
- Fragen Sie: „Analysieren Sie dieses DFD-Bild und wandeln Sie es in ein strukturiertes Modell um, das ich bearbeiten kann.“
- VP AI untersucht das Bild (Lesen von Formen, Beschriftungen und Pfeilen) und rekonstruiert die Entitäten, Prozesse, Speicher und Flüsse als bearbeitbares Diagramm.
📌 Die KI liest den Inhalt des Bildes Inhalt — Rechtecke, Kreise, Datensätze und ihre Beschriftungen — und reproduziert sie in der korrekten Notation. Dies ist ein schneller Weg von einer groben Skizze zu einem sauberen, geschichteten Modell, das Sie anschließend weiter zerlegen können.
9.5 Iterieren mit dem Artefakt-Workflow
VP AI speichert jedes generierte Diagramm als ein Artefakt , auf das Sie während der Verfeinerung verweisen können:
- „Verfeinern Sie das Level-2-Artefakt, um einen Betrug-Abzweig hinzuzufügen.“ — zielt auf ein spezifisches, bereits generiertes Diagramm anstatt von Grund auf neu zu generieren.
- „Generieren Sie das Kontextdiagramm neu, aber entfernen Sie die Lager-Entität.“ — ersetzt ein Artefakt, wenn sich der Umfang ändert.
- “Vergleichen Sie die Level-2- und Level-3-Artefakte auf Ausgewogenheit.” — Kreuzprüfung der Parität des Eltern-/Kind-Flusses.
Da Artefakte den Zustand der Konversation speichern, können Sie Verfeinerungen nach Verfeinerungen schichten, ohne frühere Entscheidungen zu verlieren – das Wesen der Top-Down-Zerlegung.
9.6 Empfohlener Arbeitsablauf-Checklist
| Phase | Aktion |
|---|---|
| 1. Gerüst | Fordern Sie zunächst das Kontextdiagramm (Level 0) an. |
| 2. Legen Sie Level 1 fest | Fordern Sie die Zerlegung der Hauptprozesse mit Speichern und einer Grenze an. |
| 3. Tiefenanalyse durchführen | Zoomen Sie einen Prozess nach dem anderen; behalten Sie Elternreferenzen bei. |
| 4. Verfeinern | Fordern Sie Ausnahmepfade, Ausgleichskorrekturen und Speicherberichtigungen an. |
| 5. Validieren | Lassen Sie die KI die DOT-Syntax prüfen; überprüfen Sie die Checkliste in Abschnitt 7. |
| 6. Dokumentieren | Fordern Sie die Interpretationsnarrative an, die jedem Level beizufügen ist. |
9.7 Beispiel-Ausgabe — Fordern Sie VP AI auf, den Level-1-Code zu generieren
Eine typische Antwort des Chatbots für die Schritt-2-Zerlegung wäre das vollständige, ausführbare DOT, die Sie zuvor gesehen haben:
digraph DFD {
    graph [
        rankdir = LR, splines = true, overlap = false,
        nodesep = 0.5, ranksep = 0.8,
        fontname = "Helvetica,Arial,sans-serif", fontsize = 12,
        label = "Online-Bestellprozesssystem - Ebene 1"
    ]
    node [ fontname = "Helvetica,Arial,sans-serif", fontsize = 11, penwidth = 1.5 ]
    edge [ fontname = "Helvetica,Arial,sans-serif", fontsize = 9,
           color = "#555555", arrowsize = 0.8 ]

    // Externe Entitäten
    node [shape = box, style = "filled", fillcolor = "#E1F5FE", color = "#0288D1"]
    Kunde; PaymentGateway; Lager; Kurier;

    subgraph cluster_SystemBoundary {
        label = "Online-Bestellprozesssystem";
        fontname = "Helvetica,Arial,sans-serif"
        fontsize = 14
        color = "#757575"
        style = "dashed,rounded"
        bgcolor = "#FAFAFA"
        margin = 20

        node [shape = circle, style = "filled", fillcolor = "#E8F5E9",
              color = "#388E3C", fixedsize = true, width = 1.3]
        P1 [label="1.0nBestellungnAufgeben"];
        P2 [label="2.0nZahlungnVerarbeiten"];
        P3 [label="3.0nLagerbestandnBestätigen"];
        P4 [label="4.0nBestellungnVersenden"];

        node [shape = record, style = "filled", fillcolor = "#FFF9C4",
              color = "#FBC02D", fixedsize = false]
        OrderDS    [label="{ D1 | Bestellungen }"];
        ProductDS  [label="{ D2 | ProduktnLagerbestand }"];
        ShippingDS [label="{ D3 | Sendungen }"];
    }

    // Flüsse
    Kunde -> P1 [label="Bestellung &nKontodetails"];
    P1 -> Kunde [label="BestellnBestätigung"];
    P2 -> PaymentGateway [label="Zahlungsnanfrage"];
    PaymentGateway -> P2 [label="Zahlungsnstatus"];
    Lager -> P3 [label="Lagernvorrat verfügbar"];
    Kurier -> P4 [label="Lieferstatus", dir=both];

    P1 -> P2 [label="BestellnGesamtbetrag"];
    P2 -> P3 [label="BezahltenBestellung"];
    P3 -> P4 [label="VerifiziertenBestellung"];

    P1 -> OrderDS [label="Bestellungnerstellen"];
    P3 -> ProductDS [label="Lagerbestandnaktualisieren", dir=both];
    P4 -> ShippingDS [label="Sendungnerstellen"];
    OrderDS -> P3 [label="Bestelldetails"];
    ShippingDS -> P4 [label="Sendungsnetikett"];
}
Fügen Sie dies in ein VP-Diagramm ein, und Sie haben das vollständig strukturierte Modell der Ebene 1 – bereit, mit dem nächsten Prompt erneut dekomponiert zu werden.
10. Zusammenfassung
Die Top-down-DFD-Dekomposition ist eine Reise von Abstraktion zu Details:
- Kontext (L0) — eine Box, alle Grenzen und externen Entitäten.
- System (L1) — Hauptprozesse, Speicher und die Datenpipeline.
- Teil-Diagramme (L2, L3…) — rekursiv in jeweils einen Prozess hineinzoomen, wobei der übergeordnete Kontext sichtbar bleibt und lokale Speicher nummeriert werden.
Jede Ebene beantwortet eine andere Frage: L0 fragt: „Was ist der Fußabdruck des Systems?“, L1 fragt: „Was sind die Hauptdatenflüsse?“, L2+ fragt: „Wie wird diese Daten genau transformiert?”
Mit Visual Paradigm AIist die gesamte Leiter konversationell: Prompt für Ebene 0, Aufforderung zur Dekomposition, schrittweises Hineinzoomen in einen Prozess, Anforderung von Ausnahmepfaden und Hochladen von Bildern zur Digitalisierung bestehender Diagramme. Kombiniert mit strikter Nummerierung, Flussausgleich, einer konsistenten Farblegendeund vollständiger Zuerst deklarieren, dann verbinden Code, jedes große System bleibt übersichtlich, eindeutig – und jedes Diagramm wird tatsächlich gerendert. 🚀