


1. معرفی نمودارهای جریان داده (DFDs)
A نمودار جریان داده (DFD) نمایش گرافیکی نحوه جریان داده در یک سیستم است — که محل منشأ داده، نحوه تبدیل آن، مکان ذخیرهسازی و محل نهایی ورود داده را نشان میدهد.جریان از طریق یک سیستم — نشان دادن اینکه داده از کجا منشأ میگیرد، چگونه تبدیل میشود، در کجا ذخیره میشود و در نهایت به کجا میرسد. برخلاف نمودارهای جریان (که بر روی جریان کنترل و توالی تمرکز دارند)،جریان کنترل و توالی)،DFDs بر رویحرکت و تبدیل داده بدون نگرانی در مورد زمانبندی یا ترتیب اجرای عملیات.
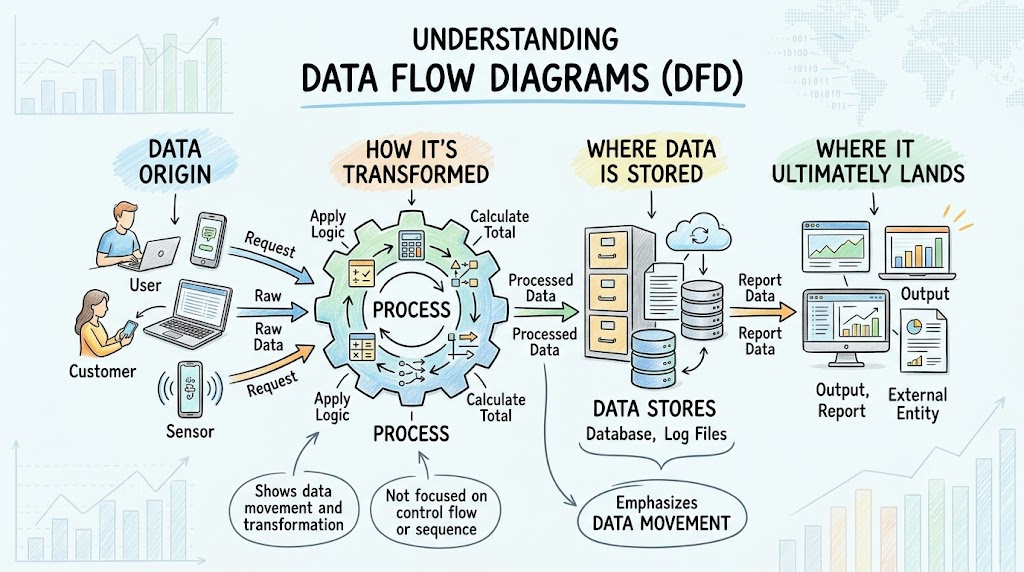
چرا ازDFDs?
- تحلیل یک سیستم موجود یا طراحییکی دیگر
- ورودیها، خروجیها و ذخیرهسازی دادهها را به زودی شناسایی کنید
- مرزهای سیستم و نیازهای دادهای را با ذینفعان ارتباط دهید
- پیچیدگی را از دید کلی به سطح جزئیات اجرا تجزیه کنید
2. چهار جزء اصلی یک نمودار جریان داده
هر نمودار جریان داده، در هر سطحی، فقط ازچهارعنصر اصلی (نمادگذاری گِن و سارسون):
| اجزاء | نمادگذاری | نقش | مثال |
|---|---|---|---|
| عنصر خارجی | مستطیل | منبع یا مقصد دادههاخارجاز مرز سیستم | مشتری، درگاه پرداخت |
| فرآیند | دایره | وارد شدن دادهها را به دادههای خروجی تبدیل میکند | «سفارش دادن»، «تأیید پرداخت» |
| ذخیرهسازی داده | ثبت / مستطیل باز | مکانی که دادهها برای استفاده بعدی نگهداری میشوند | سفارشات، موجودی کالا |
| جریان داده | پیکان (برچسبدار) | حرکت داده بین موارد فوق | «جزئیات سفارش»، «وضعیت پرداخت» |
💡 قوانین کلیدی:یک فرآیندبایدهم جریان ورودی و هم خروجی داشته باشد. فرآیندی که فقط ورودی یا فقط خروجی داشته باشد، خطای مدلسازی است — هر تبدیلی نتیجهای تولید میکند.
3. سطحهای DFD — هرم صعودی به پایین
توانایی تجزیه صعودی به پایین این است که شما شروع میکنیدمجردو اضافه کنیدجزئیاتبه صورت تکراری. هر سطح دارای یک قاعده استاندارد برای شمارهگذاری است:
| سطح | نام | محتوا |
|---|---|---|
| سطح 0 | نمودار متن | فرآیند تکی (کل سیستم)، تمام موجودیتهای خارجی و جریانهای آنها — بدون ذخیرهسازی دادهها، بدون جزئیات داخلی |
| سطح 1 | نمودار جریان داده سیستم | سیستم به فرآیندهای اصلی (1.0، 2.0، 3.0…)، ذخیرهسازیهای داده داخلی و جریانها تجزیه شده است |
| سطح 2 | نمودار فرعی | یک فرآیند سطح 1 به فرآیندهای دقیقتر تجزیه شده است (2.1، 2.2، 2.3…) |
| سطح 3 | نمودار فرعی فرعی | یک فرآیند سطح 2 به صورت بیشتر تجزیه شده است (2.2.1، 2.2.2، 2.2.3…) |
شمارهگذاری به شما به طور دقیق میگوید که در کجا در سلسله مراتب قرار دارید —2.2.4متعلق به است2.2, که متعلق به است2.0. این ساختار درختی سیستمهای بزرگ را قابل دسترسی نگه میدارد.
4. سبک خانه ( légende رنگ)
هر دیاگرام در این راهنما از یک قاعده بصری یکنواخت پیروی میکند. در Graphviz، دستورالعمل این است: اول سبک را تعیین کن، سپس تعریف کن، سپس به هم وصل کن.
| عنصر | شکل | پر کردن | حاشیه | هدف |
|---|---|---|---|---|
| عنصر خارجی | جعبه |
#E1F5FE |
#0288D1 |
کی از بیرون است |
| فرآیند | دایره |
#E8F5E9 |
#388E3C |
چه چیز دادهها را تبدیل میکند |
| ذخیرهسازی داده | ضبط |
#FFF9C4 |
#FBC02D |
جایی که دادهها استراحت میکنند |
| فرآیند والد (اشاره) | دایره |
#FCE4EC |
#C2185B |
زمینه خارج از سطح فعلی |
| مرز سیستم | خطچین، گردگروه |
#FAFAFA / #757575 |
خاکستری | حصار دیاگرام فعلی |
| جریان داده | پیکان |
— | #555555 |
حرکت داده |
⚠️ مهم — الگوی سبک یک دیاگرام نیست
یک فایل گرافیز که فقط سبک گره/یال را تعریف میکند اماهرگز هیچ گره یا یالی تعریف نمیکندبه عنوان یکبوم خالی. یک DFD سه ماده ضروری برای اینکه کار کند نیاز دارد:
- سبک دادن به گراف —
گراف [...],گره [...],یال [...]ویژگیها. - عناصر را اعلام کنید — موجودیتهای خارجی (مربعها)، فرآیندها (دایرهها)، ذخیرهسازی دادهها (ضبطها)، در یک مرز نقطهچین پیچیده شدهاند
گروهمرز. - جریانها را رسم کنید — صریح
A -> B [label="..."]لبهها، با استفاده ازdir=bothبرای مبادله دوطرفه.
این دو را مقایسه کنید — هر دو اعتبارسنجی به خوبی انجام میشود، اما تنها دومی یک تصویر تولید میکند:
❌ تنها سبک (هیچ چیزی را رندر نمیکند):
digraph DFD {
    graph [rankdir = LR]
    node [shape = box, style = "filled", fillcolor = "#E1F5FE"]
    edge [color = "#555555", arrowsize = 0.8]
}
✅ کامل (نمایش داده شده):
digraph DFD {
graph [rankdir = LR]
node [style = "filled", fillcolor = "#E1F5FE", shape = box]
مشتری;
// ...علاوه بر فرآیندها، ذخیرهسازی دادهها، مرز و لبهها
}
5. روشفرآیند تجزیه از بالا به پایین (مرحله به مرحله)
اینسیستم فرآیند سفارش آنلایناین روششناسی را نشان میدهد. در هر سطح، کد کامل و قابل اجرا برای Graphviz دریافت خواهید کرد.
مرحله 1 — ساخت نمودار متن (سطح 0)
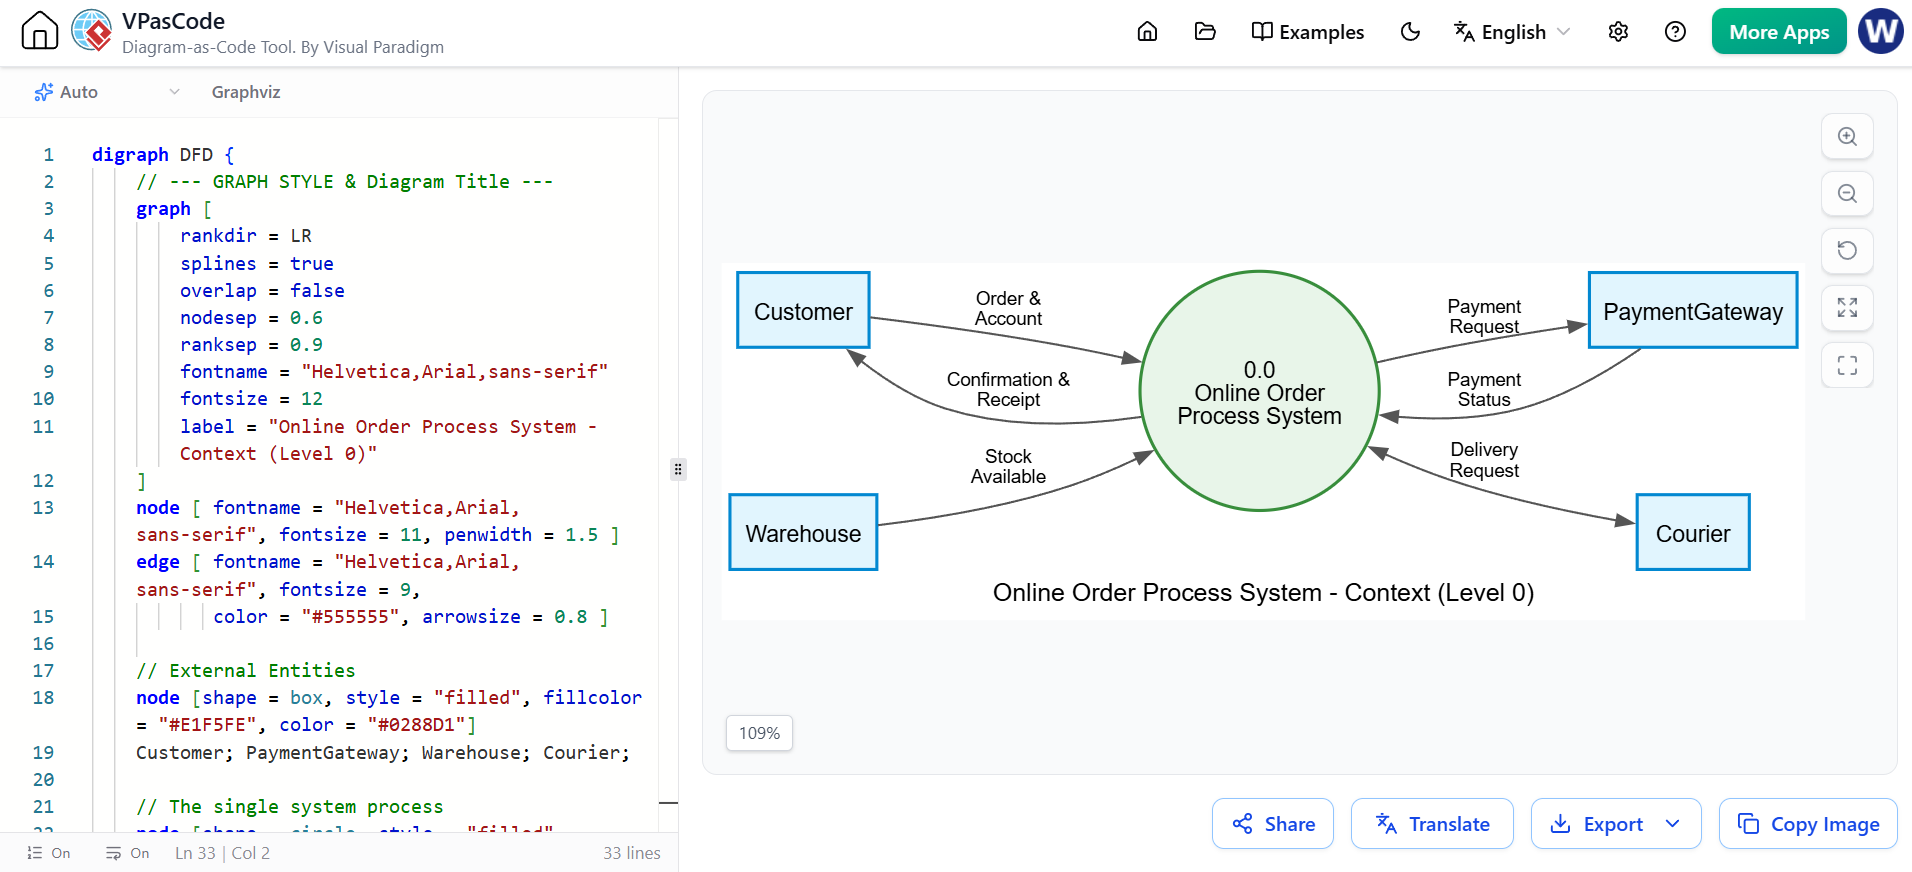
با کل سیستم به عنوانیک فرآیند واحدو هر تعامل با دنیای بیرونی را شناسایی کنید. هیچ ذخیرهسازی دادهای، هیچ جزئیات داخلی وجود ندارد.
digraph DFD {
// --- سبک گراف و عنوان نمودار ---
graph [
rankdir = LR
splines = true
overlap = false
nodesep = 0.6
ranksep = 0.9
fontname = "Helvetica,Arial,sans-serif"
fontsize = 12
label = "سیستم فرآیند سفارش آنلاین - محدوده (سطح 0)"
]
node [ fontname = "Helvetica,Arial,sans-serif", fontsize = 11, penwidth = 1.5 ]
edge [ fontname = "Helvetica,Arial,sans-serif", fontsize = 9,
color = "#555555", arrowsize = 0.8 ]
// موجودیتهای خارجی
node [shape = box, style = "filled", fillcolor = "#E1F5FE", color = "#0288D1"]
مشتری; درگاه پرداخت; انبار; پستچی;
// فرآیند واحد سیستم
node [shape = circle, style = "filled", fillcolor = "#E8F5E9",
color = "#388E3C", fixedsize = true, width = 1.6]
سیستم [label="0.0nسفارش آنلاینnسیستم فرآیند"];
// جریانهای داده (دوطرفه در جایی که دادهها در هر دو جهت مبادله میشوند)
مشتری -> سیستم [label="سفارش وnحساب"];
سیستم -> مشتری [label="تأییدیه وnرسید"];
سیستم -> درگاه پرداخت [label="درخواست پرداخت"];
درگاه پرداخت -> سیستم [label="وضعیت پرداخت"];
انبار -> سیستم [label="موجودی انبار"];
سیستم -> پستچی [label="درخواست تحویل", dir=both];
}
تفسیر:نمودار محدوده پاسخ میدهد به«مرزهای این سیستم چیستند و با چه کسانی ارتباط دارد؟»— نشان میدهدموجودیتهای خارجیو جریانهای آنها را نشان میدهد، اما تمام ساختار داخلی را پنهان میکند. ما میبینیم که سیستم سفارشات را ازمشتری، از طریقدرگاه پرداخت، موجودی را در برابرانباربررسی میکند و ارسال را بهپستچی.
مرحله ۲ — تجزیه به سطح-۱ (فرآیندهای اصلی)
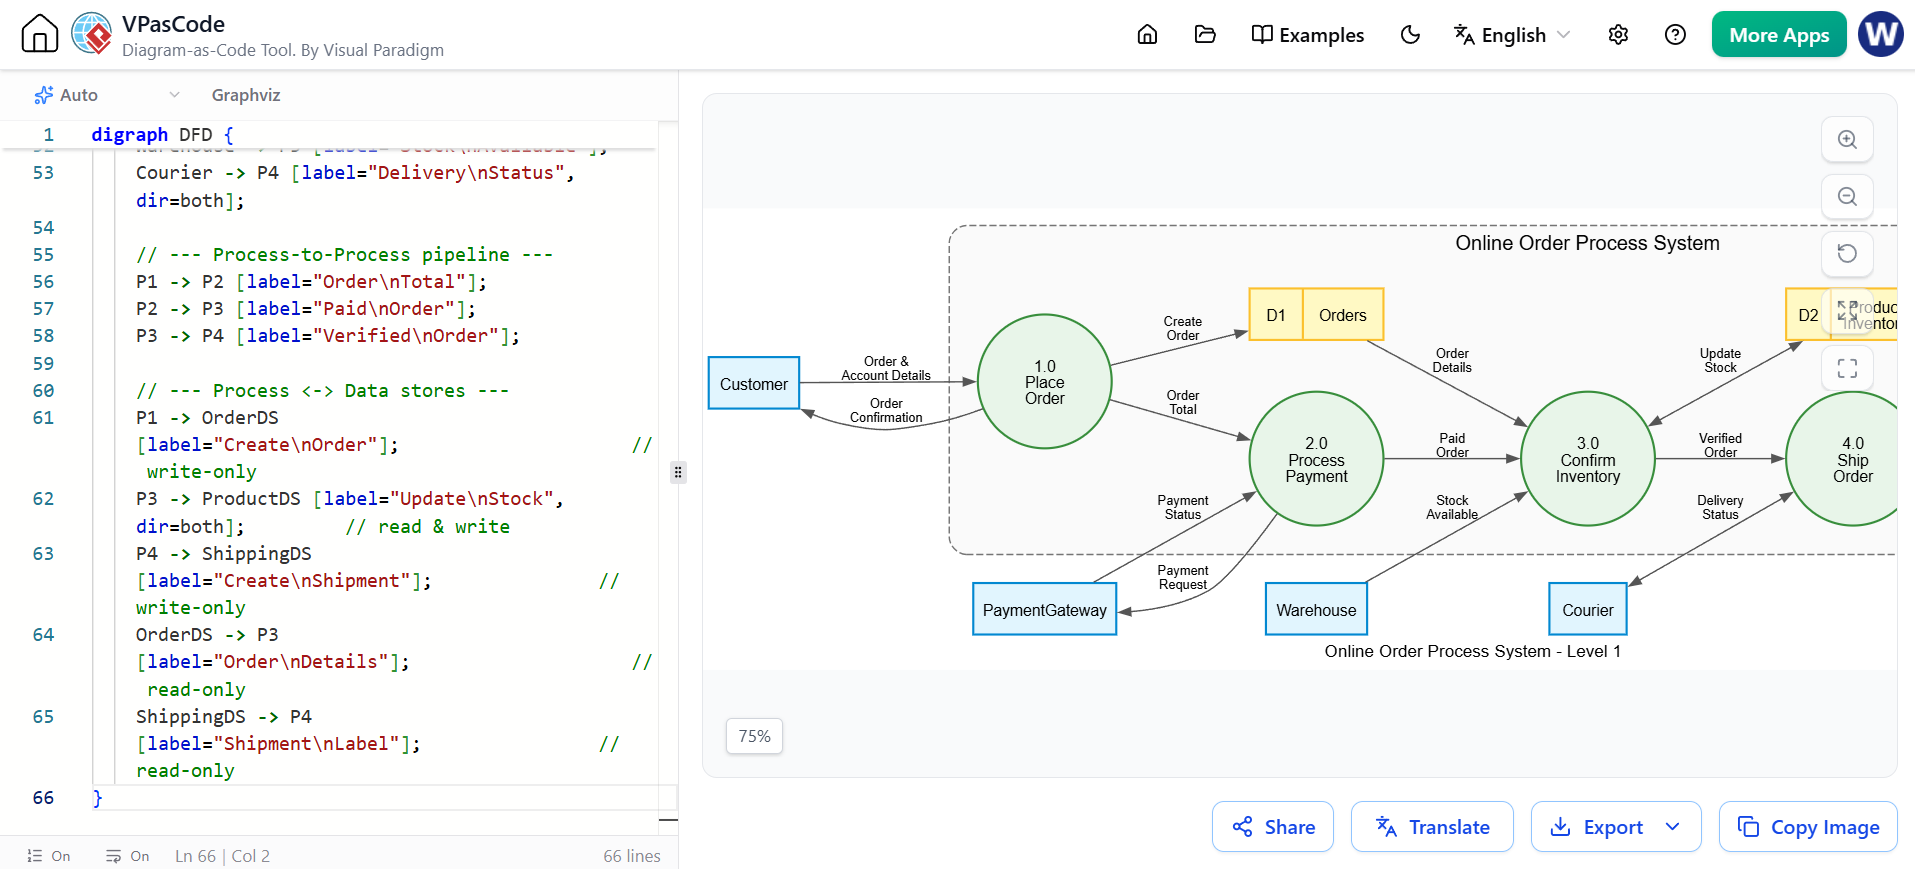
فرآیند متناظر با یک محتوا را به توابع کلیدی تقسیم کنید و ذخیرهسازیهای مشترک اضافه کنید. فرآیندها و ذخیرهسازیها را در یک مرز سیستم با خطچین و گوشههای گرد قرار دهید.مرز سیستم با خطچین و گوشههای گرد.
digraph DFD {
// --- سبک نمودار و عنوان نمودار ---
graph [
rankdir = LR
splines = true
overlap = false
nodesep = 0.5
ranksep = 0.8
fontname = "Helvetica,Arial,sans-serif"
fontsize = 12
label = "سیستم فرآیند سفارش آنلاین - سطح ۱"
]
node [ fontname = "Helvetica,Arial,sans-serif", fontsize = 11, penwidth = 1.5 ]
edge [ fontname = "Helvetica,Arial,sans-serif", fontsize = 9,
color = "#555555", arrowsize = 0.8 ]
// موجودیتهای خارجی
node [shape = box, style = "filled", fillcolor = "#E1F5FE", color = "#0288D1"]
مشتری; درگاه پرداخت; انبار; پستچی;
// --- حوزه مرز سیستم ---
subgraph cluster_SystemBoundary {
label = "سیستم فرآیند سفارش آنلاین";
fontname = "Helvetica,Arial,sans-serif"
fontsize = 14
color = "#757575"
style = "dashed,rounded"
bgcolor = "#FAFAFA"
margin = 20
// فرآیندها (دایرههای سبز)
node [shape = circle, style = "filled", fillcolor = "#E8F5E9",
color = "#388E3C", fixedsize = true, width = 1.3]
P1 [label="۱.۰nثبتnسفارش"];
P2 [label="۲.۰nپردازشnپرداخت"];
P3 [label="۳.۰nتأییدnموجودی"];
P4 [label="۴.۰nارسالnسفارش"];
// ذخیرهسازی دادهها (ضبطهای زرد)
node [shape = record, style = "filled", fillcolor = "#FFF9C4",
color = "#FBC02D", fixedsize = false]
OrderDS [label="{ D1 | سفارشها }"];
ProductDS [label="{ D2 | موجودیnمحصولات }"];
ShippingDS [label="{ D3 | ارسالها }"];
}
// --- جریان داده: موجودیتهای خارجی ---
مشتری -> P1 [label="سفارش وnجزئیات حساب"];
P1 -> مشتری [label="تأییدnسفارش"];
P2 -> درگاه پرداخت [label="درخواستnپرداخت"];
درگاه پرداخت -> P2 [label="وضعیتnپرداخت"];
انبار -> P3 [label="موجودیnانبار"];
پستچی -> P4 [label="وضعیتnتحویل", dir=both];
// --- خط لوله فرآیند به فرآیند ---
P1 -> P2 [label="جمعnسفارش"];
P2 -> P3 [label="سفارشnپرداخت شده"];
P3 -> P4 [label="سفارشnتأیید شده"];
// --- فرآیند به ذخیرهسازی دادهها ---
P1 -> OrderDS [label="ایجادnسفارش"]; // فقط نوشتن
P3 -> ProductDS [label="بهروزرسانیnموجودی", dir=both]; // خواندن و نوشتن
P4 -> ShippingDS [label="ایجادnارسال"]; // فقط نوشتن
OrderDS -> P3 [label="جزئیاتnسفارش"]; // فقط خواندن
ShippingDS -> P4 [label="برچسبnارسال"]; // فقط خواندن
}
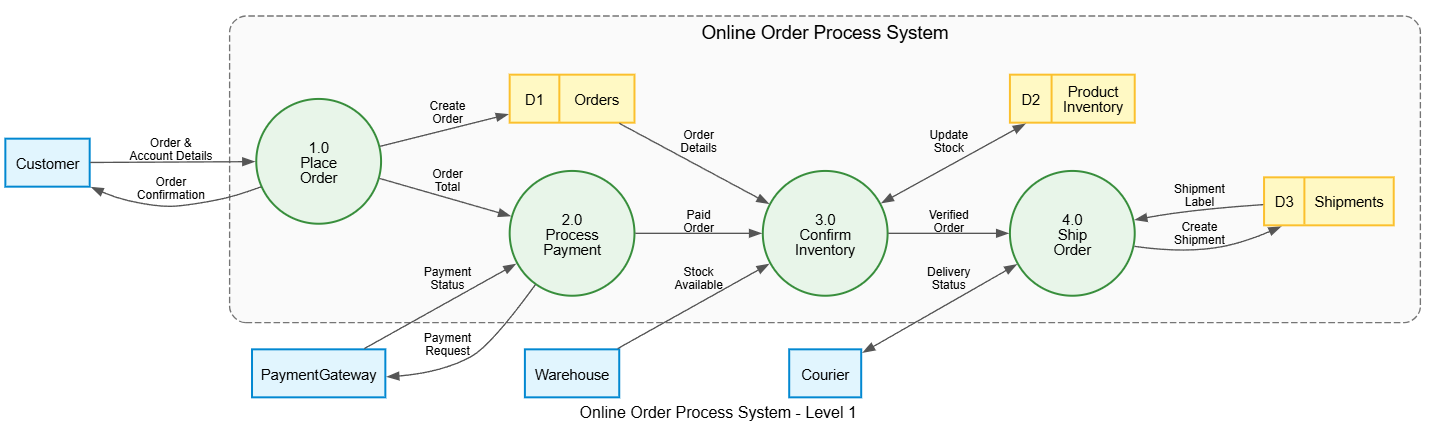 تفسیر:
- زنجیره خطی
P1 → P2 → P3 → P4نشاندهنده یک خط لوله مرتبشده: سفارش قبل از پرداخت، قبل از بررسی موجودی، و قبل از ارسال ثبت میشود. - این درگاه پرداختتبادل از دو فلش یکطرفه استفاده میکند (
درخواست پرداختخارجی،وضعیت پرداختداخلی). - ذخیرهسازی دادههابه عنوان وضعیت عمل میکنند:
P1نوشتنسفارشات،P3خواندن و بهروزرسانی موجودی (dir=دوطرفه),P4نوشتنارسالها. P3 → ذخیرهسازی محصولاتاز استفاده میکندdir=both— یک لبه، نه دو لبه — زیرا فرآیند هم دادهها را میخواند و هم موجودی را بهروز میکند.
مرحله ۳ — کاهش سطح: سطح-۲ (تمرکز بر یک فرآیند)
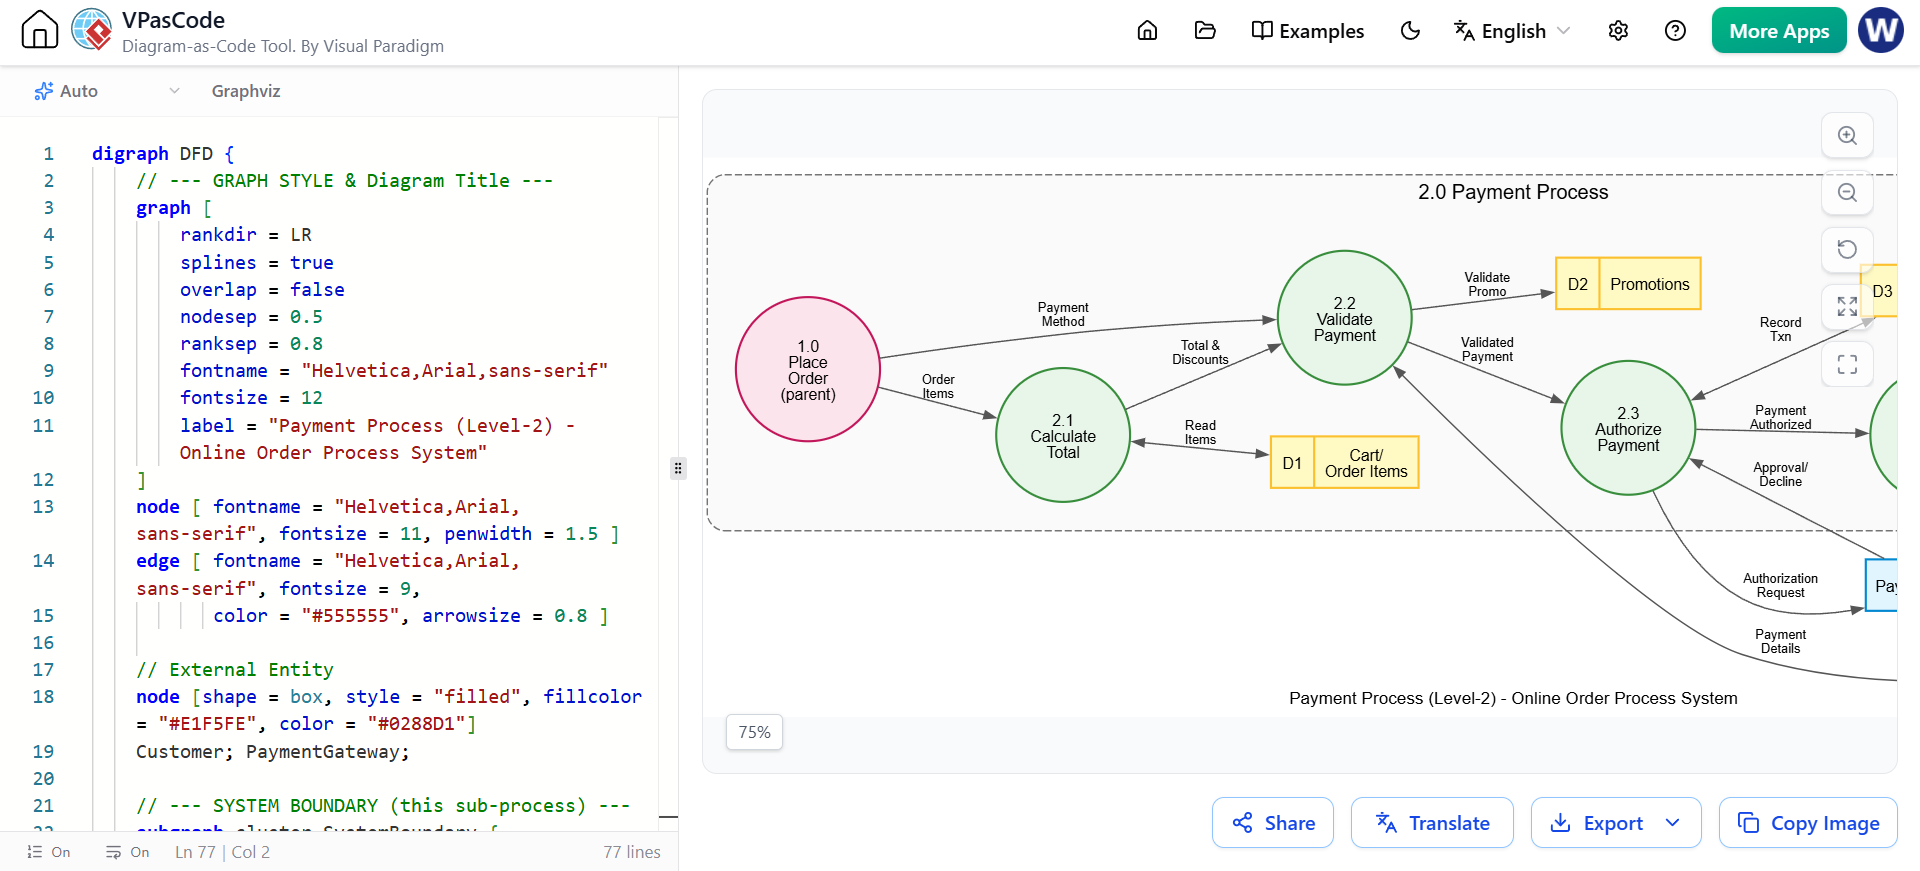
یک فرآیند سطح-۱ انتخاب کنید و آن را تجزیه کنیدفقط آن یکی. نشان دهیدفرآیندهای والد در مرز (صورتی) تا اینکه زمینه حفظ شود، همراه با زیرفرآیندها، زیرذخایرها و جریانها.
digraph DFD {
// --- سبک گراف و عنوان نمودار ---
graph [
rankdir = LR
splines = true
overlap = false
nodesep = 0.5
ranksep = 0.8
fontname = "Helvetica,Arial,sans-serif"
fontsize = 12
label = "فرآیند پرداخت (سطح-۲) - سیستم فرآیند سفارش آنلاین"
]
node [ fontname = "Helvetica,Arial,sans-serif", fontsize = 11, penwidth = 1.5 ]
edge [ fontname = "Helvetica,Arial,sans-serif", fontsize = 9,
color = "#555555", arrowsize = 0.8 ]
// موجودی خارجی
node [shape = box, style = "filled", fillcolor = "#E1F5FE", color = "#0288D1"]
مشتری; درگاه پرداخت;
// --- مرز سیستم (این زیرفرآیند) ---
subgraph cluster_SystemBoundary {
label = "۲.۰ فرآیند پرداخت";
fontname = "Helvetica,Arial,sans-serif"
fontsize = 14
color = "#757575"
style = "dashed,rounded"
bgcolor = "#FAFAFA"
margin = 20
// زیرفرآیندها (دایرههای سبز)
node [shape = circle, style = "filled", fillcolor = "#E8F5E9",
color = "#388E3C", fixedsize = true, width = 1.3]
P21 [label="۲.۱nمحاسبهnمجموع"];
P22 [label="۲.۲nاعتبارسنجیnپرداخت"];
P23 [label="۲.۳nمجاز کردنnپرداخت"];
P24 [label="۲.۴nتأییدnسفارش"];
// ذخایر دادههای زیر (ضبطهای زرد)
node [shape = record, style = "filled", fillcolor = "#FFF9C4",
color = "#FBC02D", fixedsize = false]
سبدخریدDS [label="{ D1 | سبد خرید/nموارد سفارش }"];
تخفیفDS [label="{ D2 | تخفیفها }"];
پرداختDS [label="{ D3 | تراکنشهایnپرداخت }"];
سفارشDS [label="{ D4 | سفارشها }"];
// فرآیندهای والد (صورتی) - زمینه از سطح بالاتر
node [shape = circle, style = "filled", fillcolor = "#FCE4EC",
color = "#C2185B", fixedsize = true, width = 1.4]
P1 [label="۱.۰nثبتnسفارشn(والد)"];
P3 [label="۳.۰nتأییدnموجودیn(والد)"];
}
// جریان از والدین / مشتری به زیرفرآیندها
P1 -> P21 [label="مواردnسفارش"];
P1 -> P22 [label="روشnپرداخت"];
مشتری -> P22 [label="جزئیاتnپرداخت"];
// زنجیره زیرفرآیندها
P21 -> P22 [label="مجموع وnتخفیفها"];
P22 -> P23 [label="پرداختnاعتبارسنجی شده"];
P23 -> P24 [label="پرداختnمجاز شده"];
// تعامل با درگاه خارجی
P23 -> PaymentGateway [label="درخواستnمجازسازی"];
PaymentGateway -> P23 [label="تایید/nرد"];
// خروجی به والدین / مشتری
P24 -> P3 [label="سفارشnپرداخت شده"];
P24 -> مشتری [label="رسیدnپرداخت"];
// دسترسی به ذخایر داده
P21 -> سبدخریدDS [label="خواندنnموارد", dir=both];
P22 -> تخفیفDS [label="اعتبارسنجیnتخفیف"];
P23 -> پرداختDS [label="ثبتnتراکنش", dir=both];
P24 -> سفارشDS [label="بهروزرسانیnوضعیت"];
}
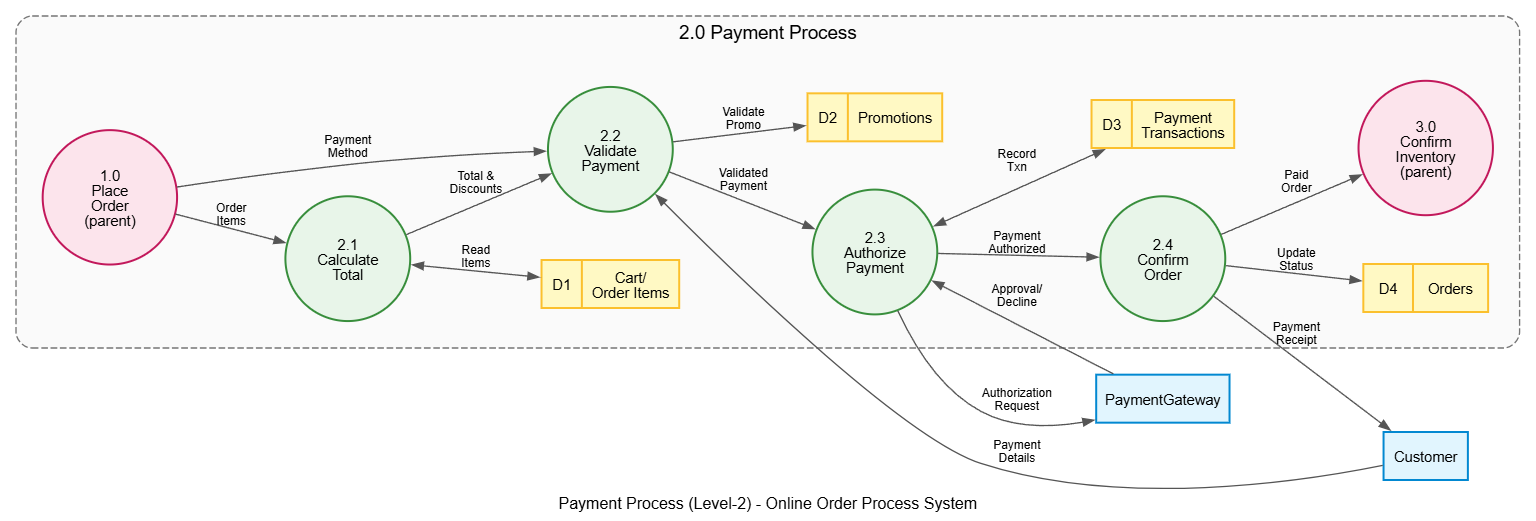 تفسیر (در مقابل سطح-۱):
- 2.1 محاسبه مجموع یک محاسبه خالص — موارد سبد خرید را میخواند، یک عدد تولید میکند، هیچ ورودی/خروجی خارجی فراتر از ذخیرهسازیها وجود ندارد.
- 2.3 تأیید پرداخت تنها تنها مرحلهای که با بیرونیها صحبت میکند درگاه پرداخت — حرکت پول به طور شفاف از سایر بخشها جدا شده است.
- فروشگاه
سفارشاتذخیرهسازی دوباره ظاهر میشود زیرا 2.4 وضعیت سفارش را بهروز میکند (اولین بار توسط 1.0 در سطح 1 نوشته شده است). - زنجیره
2.1 → 2.2 → 2.3 → 2.4یک خط لوله اعتبارسنجی توالیای قبل از انتقال به 3.0 (والد صورتی). - فرآیندهای والد 1.0 و 3.0 به رنگ صورتی رسم میشوند خارج از مرز برای تثبیت مبدأ و پایان جریانها.
مرحله ۴ — دوباره به سطح پایینتر برویم: سطح-۳ (تکرار بازگشتی)
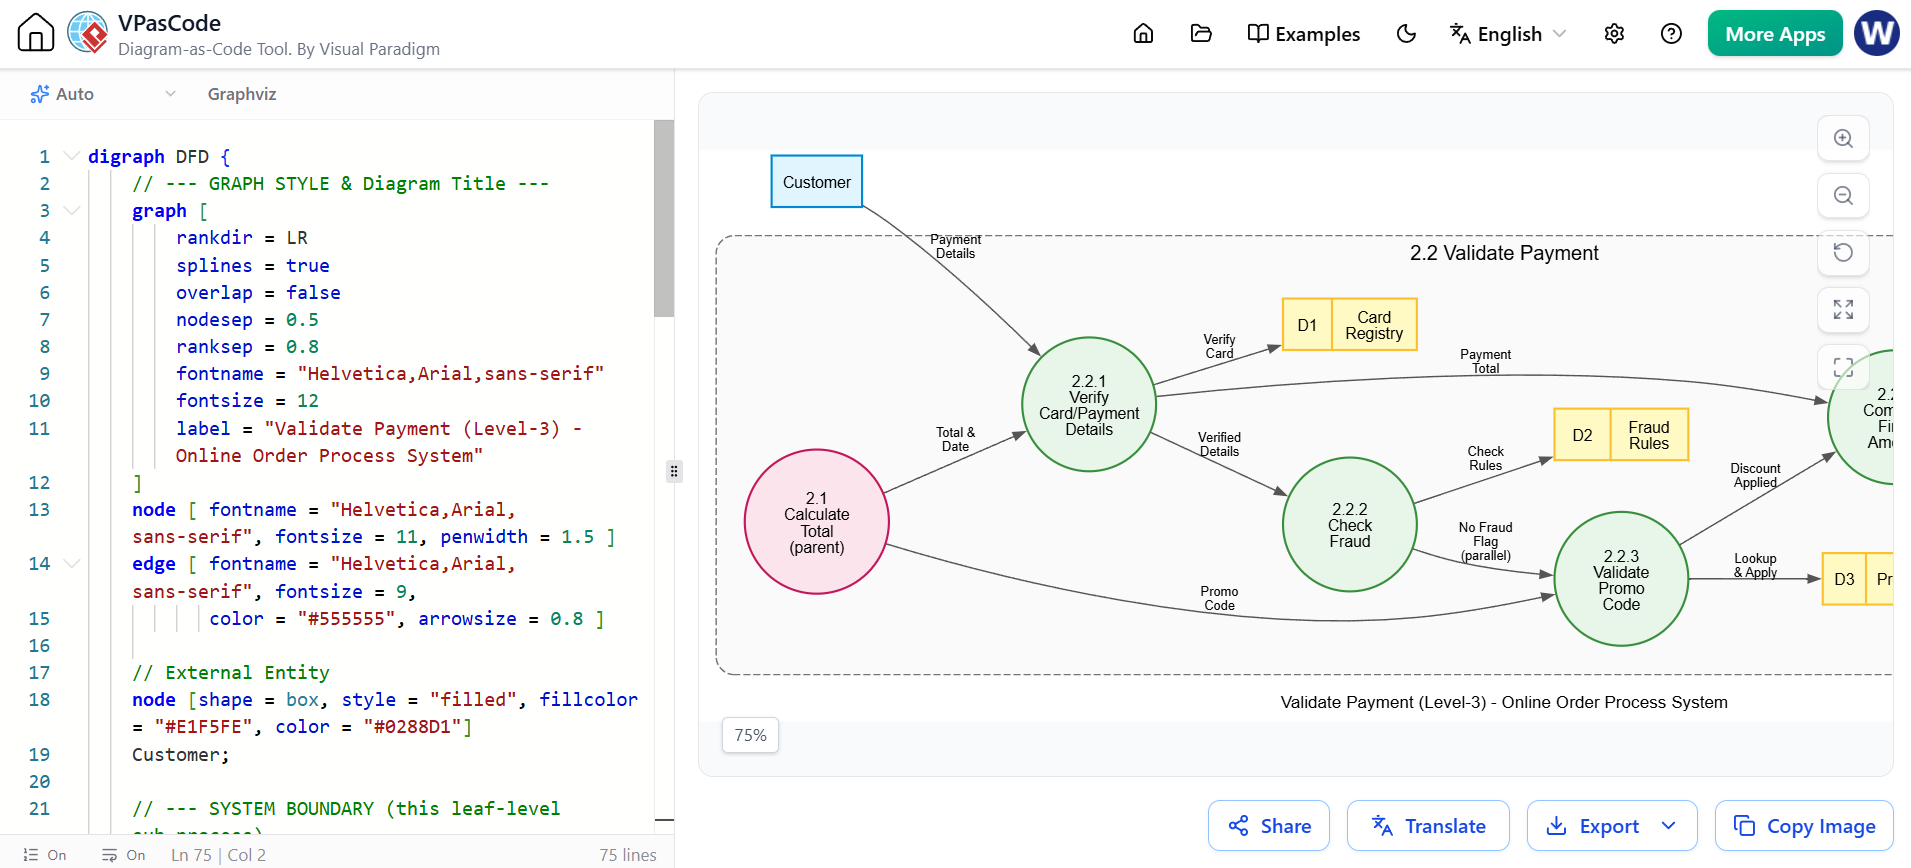
روش دقیقاً همان را روی هر زیرفرآیندی که هنوز بیش از حد پیچیده است تکرار کنید. ما به سمت ۲.۲ اعتبارسنجی پرداخت.
digraph DFD {
// --- سبک نمودار و عنوان نمودار ---
graph [
rankdir = LR
splines = true
overlap = false
nodesep = 0.5
ranksep = 0.8
fontname = "Helvetica,Arial,sans-serif"
fontsize = 12
label = "اعتبارسنجی پرداخت (سطح-۳) - سیستم فرآیند سفارش آنلاین"
]
node [ fontname = "Helvetica,Arial,sans-serif", fontsize = 11, penwidth = 1.5 ]
edge [ fontname = "Helvetica,Arial,sans-serif", fontsize = 9,
color = "#555555", arrowsize = 0.8 ]
// موجودی خارجی
node [shape = box, style = "filled", fillcolor = "#E1F5FE", color = "#0288D1"]
مشتری;
// --- مرز سیستم (این زیرفرآیند سطح برگ) ---
subgraph cluster_SystemBoundary {
label = "۲.۲ اعتبارسنجی پرداخت";
fontname = "Helvetica,Arial,sans-serif"
fontsize = 14
color = "#757575"
style = "dashed,rounded"
bgcolor = "#FAFAFA"
margin = 20
// فرآیندهای برگ (دایرههای سبز)
node [shape = circle, style = "filled", fillcolor = "#E8F5E9",
color = "#388E3C", fixedsize = true, width = 1.3]
P221 [label="۲.۲.۱nتأییدnجزئیات کارت/پرداخت"];
P222 [label="۲.۲.۲nبررسیnکلاهک"];
P223 [label="۲.۲.۳nتأییدnکد تخفیف"];
P224 [label="۲.۲.۴nمحاسبهnمبلغ نهایی"];
// ذخیرهسازی دادههای برگ (ضبطهای زرد)
node [shape = record, style = "filled", fillcolor = "#FFF9C4",
color = "#FBC02D", fixedsize = false]
CardDS [label="{ D1 | ثبتنام کارت }"];
FraudDS [label="{ D2 | قوانین کلاهک }"];
PromoDS [label="{ D3 | تخفیفها }"];
CartDS [label="{ D4 | سبد خرید/nموارد سفارش }"];
// فرآیندهای والد (صورتی)
node [shape = circle, style = "filled", fillcolor = "#FCE4EC",
color = "#C2185B", fixedsize = true, width = 1.4]
P21 [label="۲.۱nمحاسبهnمجموعn(والد)"];
P23 [label="۲.۳nمجاز کردنnپرداختn(والد)"];
}
// ورودیها
P21 -> P221 [label="مجموع وnتاریخ"];
مشتری -> P221 [label="جزئیات پرداخت"];
// اعتبارسنجی توالیای، با شاخه موازی
P221 -> P222 [label="جزئیات تأیید شده"];
P222 -> P223 [label="برچسب کلاهک نداردn(موازی)"];
// تغذیه محاسبه نهایی
P21 -> P223 [label="کد تخفیف"];
P221 -> P224 [label="مجموع پرداخت"];
P223 -> P224 [label="تخفیف اعمال شده"];
// خروجی به والد
P224 -> P23 [label="تأیید شده وnتخفیف داده شدهnمجموع"];
// دسترسی به ذخیرهسازی دادهها
P221 -> CardDS [label="تأییدnکارت"];
P222 -> FraudDS [label="بررسیnقوانین"];
P223 -> PromoDS [label="جستجو وnاعمال"];
P224 -> CartDS [label="خواندنnموارد", dir=both];
}
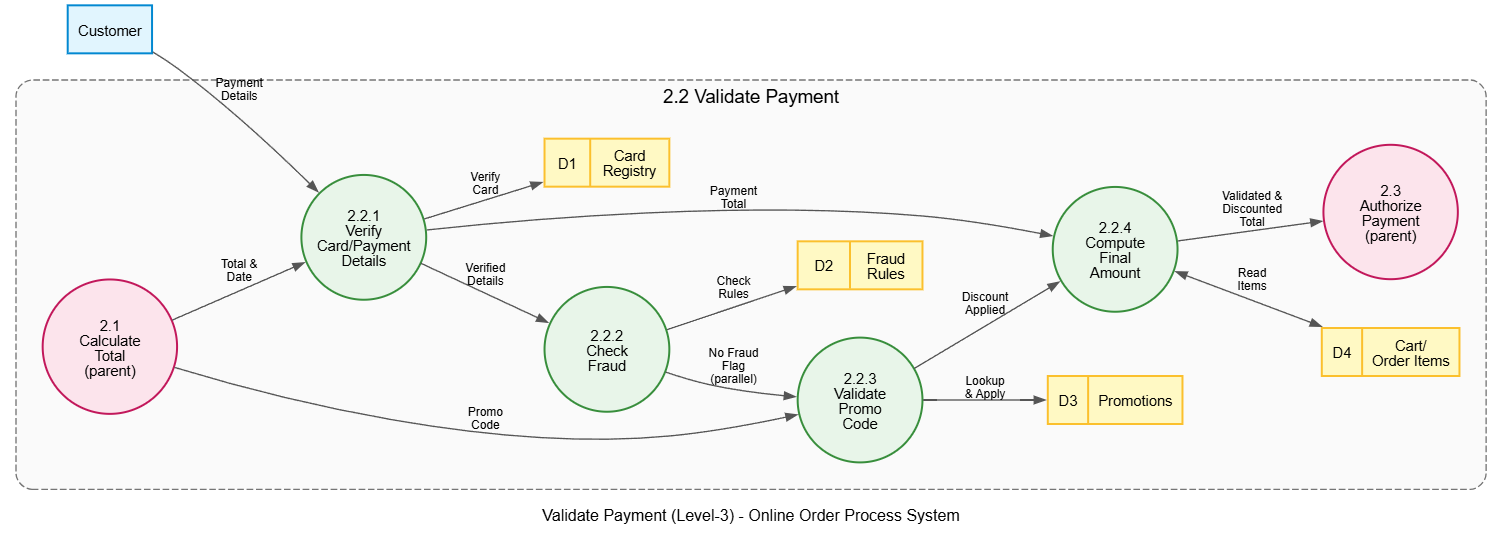 تفسیر:
- 2.2.1 تأیید کارتیک استگیت— باید موفق باشد قبل از شروع بررسی تقلب.
- 2.2.2 (تقلب)و2.2.3 (تبلیغات)در حال اجرا درموازی: هر دو قوانین خواندن را دارند و هر دو به محاسبه نهایی تغذیه میکنند. برچسب «(موازی)» این مورد را مشخص میکند.
- 2.2.4 محاسبه مبلغ نهایییک استگیرنده چندگانهنقطه — اینبه هم میپیوندد
جمع کل پرداخت+تخفیفبه یک خروجی تأییدشده که به والد خروج دارد2.3. - ثبت کارتوقوانین تقلبذخیرهسازیهای سطح جزئیات هستند که در سطح ۲ دیده نمیشوند — ذخیرهسازیهای جدید به طور طبیعی هنگامی که شما تجزیه میکنید، ظاهر میشوند.
مرحله ۵ — متوقف شوید وقتی فرآیندها «ابتدایی» باشند
ادامه دهید تا هر فرآیند یک را توصیف کنداقدام تکنگ، بیامبهام و قابل اجرا. عمق ثابتی وجود ندارد؛ زمانی متوقف شوید که یک فرآیند به طور شفاف به یک عملکرد یا یک تصمیم مربوط شود. سطوح ۲.۲.۱ تا ۲.۲.۴ بالا از پیش ابتدایی هستند.
۶. بهترین روشها و اشکالات رایج
✅ بهترین روشها
- فرآیندها را به صورت سلسله مراتبی شمارهگذاری کنید (
2.2.4) به این ترتیب هر دیاگرام در درخت خودش قابل شناسایی است. - فرآیندهای والد را در مرز رسم کنید (صورتی) تا جریانها متناسب با زمینه باقی بمانند — هرگز ورودی/خروجی را بیخانواده نکنید.
- یک لبه دوطرفه استفاده کنید (
dir=هردو) برای تبادلات دوطرفه به جای دو پیکان جداگانه. از شلوغی جلوگیری میکند. - برچسبها را توصیفی اما کوتاه نگه دارید («مجاز کردن پرداخت»، نه «AP»).
- یک فرآیند را در هر زمان تجزیه کنید — هر سطح یک دیاگرام مستقل است؛ چندین سطح را در یک دیاگرام جمع نکنید.
- دیاگرامها را متعادل کنید — ورودیها/خروجیهای در سطح والد باید برابر با مجموع ورودیها/خروجیهای فرزندان آن باشد (قوانین متعادلسازی).
- عنصرها را همیشه اعلام کنید — الگویی که فقط سبکدهی میکند و هیچ گره یا لبهای اعلام نمیکند، یک پوسته خالی را نمایش میدهد. هر DFD باید سبک، سپس اعلام، سپس اتصال.
- ذخیرهگاههای داده را به صورت منحصر به فرد نامگذاری کنید در دیاگرامهای فرزند، اما شمارهگذاری مجدد به صورت محلی (D1، D2…) برای خودکفا بودن.
❌ اشتباهات رایج
- فرآیندهای بیپدر — فرآیندی که هیچ ورودی یا خروجی ندارد. هر فرآیند چیزی را تبدیل میکند.
- عدم متعادلسازی — جریانی در سطح ۱ ظاهر میشود اما هیچیک از فرزندان سطح ۲ آن تولید یا مصرف آن را انجام نمیدهند.
- جزئیات زودهنگام — نمایش ذخیرهسازی دادهها در نمودار متناظر سطح ۰ (آنها فقط در سطوح پایینتر جایگاه دارند).
- تفکر جریان کنترل — قرار دادن حلقهها یا نمادهای تصمیمگیری در یک DFD؛ آن را برای نمودارهای جریان نگه دارید. DFDها دادهها را نشان میدهند، نه ترتیب.
- دو پیکان موازی برای آنچه باید یکی باشد
dir=bothلبه — باعث بینظمی خطوط تکراری میشود. - جهت دسترسی به ذخیرهسازی اشتباه — برچسب زدن به یک ذخیرهسازی به عنوان فقط خواندنی وقتی در واقع نوشته میشود (یا برعکس).
- الگوی سبک به جای یک نمودار اشتباه گرفته شده است — فراموش کردن اعلام گرهها و لبهها باعث ایجاد یک نمودار خالی میشود.
۷. لیست بررسی تفکیکی از بالا به پایین
قبل از ارائه یک نمودار، بررسی کنید:
- ✅ هر فرآیند حداقل یک ورودی و حداقل یک خروجی دارد.
- ✅ هر برچسب جریان یک اسم (جزئیات سفارش)، نه یک فعل.
- ✅ هر ذخیرهسازی داده در نقطهای خوانده میشودو در نقطهای نوشته میشود (مگر اینکه دادههای مرجع خارجی به طور واضح مشخص شده باشند).
- ✅ مرزهای سطحتعادل: فرزندان دقیقاً همان چیزی را مصرف و تولید میکنند که والدشان مبادله کرده است.
- ✅ موجودیتهای خارجی فقط در لبهها دیده میشوند، هرگز در داخل یک مرز.
- ✅
dir=دوطرفهبرای مبادلات دوطرفه استفاده میشود؛ در غیر این صورت پیکانهای یکطرفه. - ✅ ارجاعات فرآیند والد صورتی به درستی سطحی را نشان میدهد که در حال تجزیه است.
- ✅ کد گرههای واقعی، لبهها و یک مرز را تعریف میکند — این فقط یک قاعده سبک نیست.
8. خلاصه فرآیند تجزیه به سمت پایین
تجزیه DFD به سمت پایین یک سفر از مجرد شدن به جزئیات:
- زمینه (سطح 0) — یک جعبه، تمام مرزها و موجودیتهای خارجی.
- سیستم (سطح 1) — فرآیندهای اصلی، ذخیرهسازیها و مسیر دادهها.
- زیرنمودارها (سطح 2، سطح 3…) — به صورت بازگشتی به یک فرآیند در هر بار زوم کنید، به طوری که زمینه والد قابل مشاهده باشد و ذخیرهسازیهای محلی شمارهگذاری شوند.
هر سطح به سؤال متفاوتی پاسخ میدهد: سطح 0 میپرسد «سایز سیستم چیست؟»، سطح 1 میپرسد «جریانهای اصلی داده چیستند؟»، سطح 2 و بالاتر میپرسد «دقیقاً این داده چگونه تبدیل میشود؟»
این فرآیند سفارش آنلاین این مثال زنجیره کامل را در کد کامل و قابل اجرای Graphviz — از یک نمودار چهار موجودیتی نمودار زمینه، تا یک روال چهار مرحلهای روال اعتبارسنجی (2.2.1 → 2.2.4). با کاهش اعداد, تعادل جریانها، با رعایت یک légende رنگ (جعبههای آبی، دایرههای سبز، رکوردهای زرد، ارجاعات والد صورتی، مرز خاکستری نقطهچین)، و همیشه تعریف هر گره/یال به صورت صریح، هر سیستم بزرگ قابل دسترسی و بدون ابهام باقی میماند — و هر دیاگرام واقعاً رندر میشود.
۹. ابزارها: ساخت تجزیه بالا به پایین DFD با Visual Paradigm AI
Visual Paradigm AI یک را قرار میدهدربات گفتگوی هوش مصنوعی مستقیماً درون ابزار مدلسازی، به جای نقاشی دستی هر سطح، میتوانید کل فرآیند تجزیه را به صورت گفتگویی انجام دهید، سپس نتیجه را بهینه کنید. اینجا نحوه استفاده از آن برای دقیقاً روش این راهنما آورده شده است.
۹.۱ قابلیتهای اصلی برای کار با DFD
اینربات گفتگوی VP AIیک استکمککننده متن و کدکه از طریق گفتگو با شما همکاری میکند. برای تجزیه بالا به پایین DFD، میتواند:
| قابلیت | چه کاری برای شما انجام میدهد |
|---|---|
| تولید کد دیاگرام | تولید Graphviz (DOT) برای توصیف فرآیند داده شده — یک سطح در هر بار |
| تحلیل تصاویر پیوست شده | یک تصویر DFD دستنویس یا موجود را که آپلود میکنید بخوانید و آن را به مدلهای ساختاریافته تبدیل کنید |
| به صورت تکراری بهبود بخشید | بازخورد خود («بزرگنمایی به سطح 2.2»، «شاخه کاهش را اضافه کن») را بگیرید و نمودار را دوباره تولید کنید |
| تفسیرها را توضیح دهید | از اینکه هر موجودیت، فرآیند، ذخیرهسازی و جریان چه معنی دارد، مرور کنید |
| ساختار دستوری را تأیید کنید | مطمئن شوید که DOT قبل از رندر شدن ساختاری سالم باشد |
| خروجی استراتژی/نمودار تولید کنید | نمودارهای یا چارچوبهای پشتیبانیکنندهای که همراه DFD هستند (مثلاً یک نمودار شناور یا زمینه سازمانی) تولید کنید |
📌 توجه: Visual Paradigm از مجموعهای از نمادگذاریهای نموداری پشتیبانی میکند. ترجیح دهید BPMN برای مدلسازی فرآیندهای کسبوکار که نیاز به رویدادهای شروع/پایان، گیتویها و نوارهای شناور دارند؛ از نمودارهای DFD مبتنی بر Graphviz برای مدلسازی دقیق جریان دادهها مانند آنچه در این راهنما نشان داده شده است.
9.2 گفتوگوی کاربردی — تجزیه فرآیند سفارش آنلاین
اینجا یک جلسه گفتوگوی واقعبینانه وجود دارد که مراحلی که پیشتر طی کردیم را تکرار میکند. توجه کنید که هر پرامپت یک سطح عمیقتر را بزرگنمایی میکند — دقیقاً روش بالا به پایین.
پرامپت 1 — شروع نمودار متناظر:
«یک نمودار متناظر (سطح 0) برای سیستم فرآیند سفارش آنلاین ایجاد کنید. موجودیتهای خارجی: مشتری، درگاه پرداخت، انبار، پستچی»
VP AI پاسخ میدهدبا یک نمودار جریان داده سطح ۰ — یک فرآیند مرکزی، چهار موجودیت خارجی و جریانهای آنها — که شما آن را در یک نمودار قرار میدهید.
پرامپت ۲ — جزئیات بیشتر اضافه کنید:
«اکنون آن را به یک نمودار جریان داده سطح ۱ با فرآیندهای زیر تجزیه کنید: ۱.۰ سفارش دادن، ۲.۰ پردازش پرداخت، ۳.۰ تأیید موجودی، ۴.۰ ارسال سفارش. ذخیرههای داده برای سفارشات، موجودی کالا و ارسالها را اضافه کنید.»
VP AI بازمیگرددنمودار سطح ۱ با فرآیندهای زنجیرهای به ترتیب، ذخیرهها متصل شده و جریانهای موجودیتهای خارجی حفظ شده — خط لولهای که در مرحله ۲ راهنما دیدید.
پرامپت ۳ — به یک فرآیند نزدیکتر ببینید:
«به فرآیند ۲.۰ پردازش پرداخت نزدیکتر ببینید. یک نمودار فرعی سطح ۲ با فرآیندهای ۲.۱ محاسبه مجموع، ۲.۲ اعتبارسنجی پرداخت، ۲.۳ تأیید پرداخت، ۲.۴ تأیید سفارش ایجاد کنید. ۱.۰ و ۳.۰ را به عنوان مرجع والد حفظ کنید.»
VP AI تولید میکندنمودار فرعی سطح ۲: زیرفرآیندها، ذخیرههای محلی (D1–D4)، تعامل با دروازه پرداخت و مراجع والد صورتی برای ۱.۰ و ۳.۰ — مطابق مرحله ۳.
پرامپت ۴ — دوباره به سطح پایینتر بروید:
«به ۲.۲ اعتبارسنجی پرداخت به عنوان نمودار سطح ۳ نزدیکتر ببینید: ۲.۲.۱ تأیید کارت، ۲.۲.۲ بررسی کلاهبرداری، ۲.۲.۳ اعتبارسنجی تخفیف، ۲.۲.۴ محاسبه مبلغ نهایی. ذخیرههایی برای ثبت کارت، قوانین کلاهبرداری، تخفیفها و موارد سبد خرید اضافه کنید.»
VP AI تولید میکندنمودار برگ سطح ۳ با محاسبه ورودی (۲.۲.۴) و شاخههای موازی کلاهبرداری/تخفیف — دقیقاً مرحله ۴.
پرامپت ۵ — مدیریت خطاهای اضافه کنید:
«مسیر خطایی اضافه کنید: اگر ۲.۲.۲ بررسی کلاهبرداری معامله را علامت بزند، مسیر را به فرآیند اطلاعیه لغو برگردان به مشتری هدایت کنید.»
VP AI بهبود مییابدنمودار را با شاخه رد شدن و بازتوزیع خودکار جریانها بهبود میدهد.
۹.۳ الگوهای پرامپتگذاری که کار میکنند
این الگوها را برای دستیابی به نتایج قابل اعتماد و مطابق با روششناسی استفاده کنید:
| هدف | نمونه پیشنهاد |
|---|---|
| یک سطح عمیقتر تجزیه کنید | «بزرگنمایی کنید در ۳.۰ تأیید موجودیبه عنوان یک نمودار فرعی سطح ۲.» |
| شمارهگذاری را مشخص کنید | «از فرآیندهای شمارهدار استفاده کنید 2.1, 2.2, 2.3.” |
| زمینه والد را حفظ کنید | «حفظ کنید 1.0 و 3.0 به عنوان مراجع والد در مرز.» |
| افزودن ذخیرههای داده | «شامل ذخیرهها: D1 آیتمهای سبد خرید, D2 تبلیغات.” |
| نمایش جریان دوطرفه | «استفاده از dir=bothبرای خواندن و نوشتن فرآیند ↔ ذخیرهها.» |
| تعادل سطح | «مطمئن شوید ورودیها و خروجیها با سطح والد هماهنگ هستند.» |
| افزودن مسیر شکست | «شاخه استثنا را اضافه کنید هنگامی که پرداخت رد میشود.” |
| عمق را محدود کنید | «تا فرآیندهای اولیه متوقف شوید — اقدامات تکی و قابل اجرا.» |
9.4 آپلود کردن یک تصویر برای تحلیل
اگر قبلاً یک DFD دستکشیده یا قدیمی دارید و میخواهید آن را دیجیتالی کنید:
- تصویر را به چت پیوست کنیدبه چت (یک عکس از صفحه نمایش، عکس یا خروجی یک DFD موجود).
- پرسش: «این تصویر DFD را تحلیل کن و آن را به یک مدل ساختاریافته تبدیل کن که بتوانم آن را ویرایش کنم.»
- هوش مصنوعی VP تصویر را بررسی میکند (خواندن اشکال، برچسبها و فلشها) و موجودیتها، فرآیندها، ذخیرهسازیها و جریانها را به عنوان یک نمودار ویرایشپذیر بازسازی میکند.
📌 هوش مصنوعی محتوای تصویر را میخواند محتوا — مستطیلها، دایرهها، رکوردها و برچسبهای آنها — و آنها را با نمادگذاری صحیح بازتولید میکند. این مسیری سریع از یک طرح خام به یک مدل تمیز و لایهای است که سپس میتوانید آن را بیشتر تجزیه کنید.
۹.۵ تکرار با جریان کار آیتمهای تولیدشده
هوش مصنوعی VP هر نمودار تولیدشده را به عنوان یک آیتم تولیدشده که میتوانید در طول بهبود به آن ارجاع دهید:
- «آیتم تولیدشده سطح ۲ را بهبود بخشید تا شاخهای برای تعلیق کلاهبرداری اضافه شود.» — به یک نمودار خاصی که قبلاً تولید شده است به جای تولید مجدد از صفر.
- «نمودار متناظر را دوباره تولید کن اما موجودیت انبار را حذف کن.» — هنگامی که دامنه تغییر میکند، یک آیتم تولیدشده را جایگزین میکند.
- « سطوح ۲ و ۳ سند را برای تعادل بودن مقایسه کنید. »— بررسی میکند که جریان والد/فرزند یکسان باشد.
از آنجا که سندها وضعیت گفتگو را حفظ میکنند، میتوانید بدون از دست دادن تصمیمات قبلی، به تدریج به بهبود و تکمیل بپردازید — این همان اصل تجزیه از بالا به پایین است.
9.6 لیست کنترلی روش کار پیشنهادی
| مرحله | اقدام |
|---|---|
| 1. ساختار | اولین پیشنهاد را برای نمودار متن (سطح ۰) ارائه دهید. |
| 2. سطح ۱ را ایجاد کنید | درخواست کنید تا تجزیه فرآیند اصلی با ذخیرهسازی و مرز مشخص شود. |
| 3. پایینتر بروید | هر بار یک فرآیند را بزرگنمایی کنید؛ ارجاعات والد را حفظ کنید. |
| 4. بهبود بخشیدن | مسیرهای استثنا، اصلاحات تعادل و اصلاحات ذخیرهسازی را درخواست کنید. |
| 5. اعتبارسنجی کنید | AI را بخواهید که سینتکس DOT را بررسی کند؛ بررسی لیست بررسی در بخش 7. |
| 6. سند | درخواست کنید که روایت تفسیری را به هر سطح پیوست کنید. |
9.7 خروجی نمونه — از VP AI بخواهید کد سطح 1 را تولید کند
پاسخ معمولی از چتبات برایمرحله 2: تجزیهخواهد بودDOT کامل و قابل اجرا که قبلاً دیده بودید:
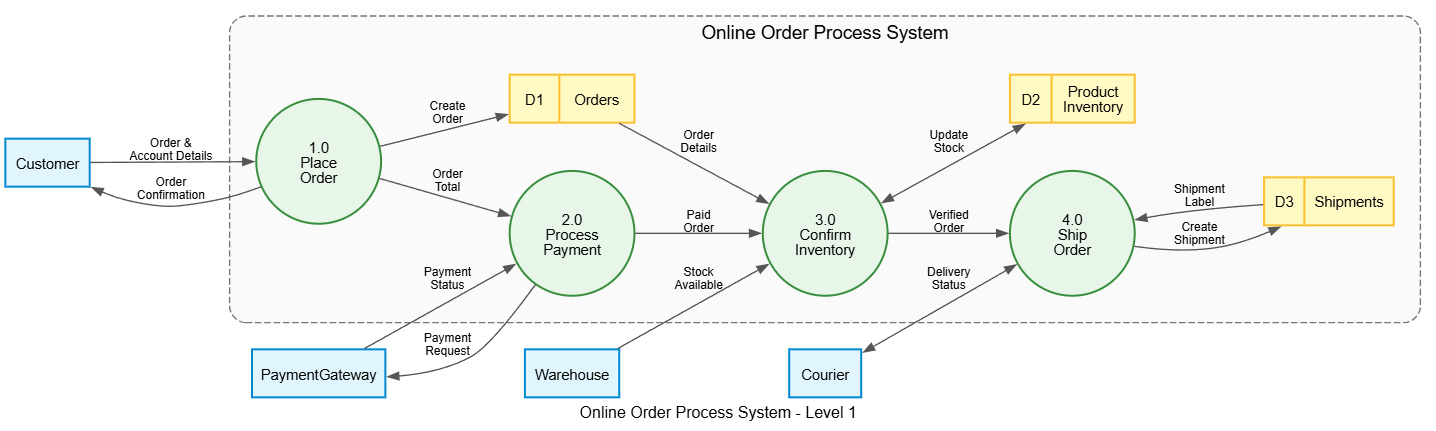
digraph DFD {
graph [
rankdir = LR, splines = true, overlap = false,
nodesep = 0.5, ranksep = 0.8,
fontname = "Helvetica,Arial,sans-serif", fontsize = 12,
label = "سیستم فرآیند سفارش آنلاین - سطح 1"
]
node [ fontname = "Helvetica,Arial,sans-serif", fontsize = 11, penwidth = 1.5 ]
edge [ fontname = "Helvetica,Arial,sans-serif", fontsize = 9,
color = "#555555", arrowsize = 0.8 ]
// موجودیتهای خارجی
node [shape = box, style = "filled", fillcolor = "#E1F5FE", color = "#0288D1"]
مشتری; درگاه پرداخت; انبار; پستچی;
subgraph cluster_SystemBoundary {
label = "سیستم فرآیند سفارش آنلاین";
fontname = "Helvetica,Arial,sans-serif"
fontsize = 14
color = "#757575"
style = "dashed,rounded"
bgcolor = "#FAFAFA"
margin = 20
node [shape = circle, style = "filled", fillcolor = "#E8F5E9",
color = "#388E3C", fixedsize = true, width = 1.3]
P1 [label="1.0nثبتnسفارش"];
P2 [label="2.0nپردازشnپرداخت"];
P3 [label="3.0nتأییدnموجودی"];
P4 [label="4.0nارسالnسفارش"];
node [shape = record, style = "filled", fillcolor = "#FFF9C4",
color = "#FBC02D", fixedsize = false]
OrderDS [label="{ D1 | سفارشات }"];
ProductDS [label="{ D2 | موجودیnمحصولات }"];
ShippingDS [label="{ D3 | ارسالها }"];
}
// جریانها
مشتری -> P1 [label="سفارش وnجزئیات حساب"];
P1 -> مشتری [label="تأییدnسفارش"];
P2 -> درگاه پرداخت [label="درخواستnپرداخت"];
درگاه پرداخت -> P2 [label="وضعیتnپرداخت"];
انبار -> P3 [label="موجودیnانبار"];
پستچی -> P4 [label="وضعیتnتحویل", dir=both];
P1 -> P2 [label="جمعnسفارش"];
P2 -> P3 [label="سفارشnپرداخت شده"];
P3 -> P4 [label="سفارشnتأیید شده"];
P1 -> OrderDS [label="ایجادnسفارش"];
P3 -> ProductDS [label="بهروزرسانیnموجودی", dir=both];
P4 -> ShippingDS [label="ایجادnارسال"];
OrderDS -> P3 [label="جزئیاتnسفارش"];
ShippingDS -> P4 [label="برچسبnارسال"];
}
آن را در یک نمودار VP چسبانید و مدل ساختاری کامل سطح 1 را دارید — آماده برای تجزیه مجدد با پیام بعدی.
10. خلاصه
تجزیه DFD از بالا به پایین یک سفر ازاز تعمیم به جزئیات:
- زمینه (سطح 0) — یک جعبه، تمام مرزها و موجودیتهای خارجی.
- سیستم (سطح 1) — فرآیندهای اصلی، ذخیرهسازیها و مسیر دادهها.
- زیرنگارهها (سطح 2، 3…) — به صورت بازگشتی به یک فرآیند در هر مرحله نزدیک شوید، زمینه والد را قابل مشاهده نگه دارید و ذخیرهسازیهای محلی شمارهگذاری شوند.
هر سطح به سؤال متفاوتی پاسخ میدهد: سطح 0 میپرسد «سیستم چه محدودهای دارد؟»، سطح 1 میپرسد «جریانهای اصلی داده چیستند؟»، سطح 2 و بالاتر میپرسد «دقیقاً این داده چگونه تبدیل میشود؟»
با Visual Paradigm AI، کل این سلسله مراتب مکالمهای است: برای سطح 0 پیشنهاد بدهید، از آن بخواهید تجزیه شود، یک فرآیند را در هر مرحله نزدیک کنید، شاخههای استثنا درخواست کنید و تصاویر را آپلود کنید تا نگارههای موجود را دیجیتالی کنید. همراه با شمارهگذاری دقیق شمارهگذاری, تعادل جریان، یک افسانه رنگی یکنواخت افسانه رنگیو کامل تعریف کن سپس به هم وصل کنکد، هر سیستم بزرگ قابل دسترسی و بدون ابهام باقی میماند — و هر دیاگرام واقعاً رندر میشود. 🚀
This post is also available in Deutsch, English, Español, Français, Bahasa Indonesia, 日本語, Polski, Portuguese, Ру́сский, Việt Nam, 简体中文 and 繁體中文.