


Introduction
Modélisation et notation des processus métier (BPMN)sert de langage universel pour la modélisation des processus, comblant le fossé entre les développeurs techniques et les parties prenantes métier. Cependant, à mesure que les flux de travail organisationnels deviennent plus complexes, les diagrammes peuvent rapidement devenir encombrés et illisibles. La solution réside dans une abstraction efficace grâce aux sous-processus. Un sous-processus est une activité composée qui encapsule un ensemble de tâches, de passerelles et d’événements en une unité unique et gérable. En divisant les processus complexes en niveaux hiérarchiques, les modélisateurs peuvent maintenir une clarté de haut niveau tout en préservant la logique détaillée pour des domaines d’intérêt spécifiques.
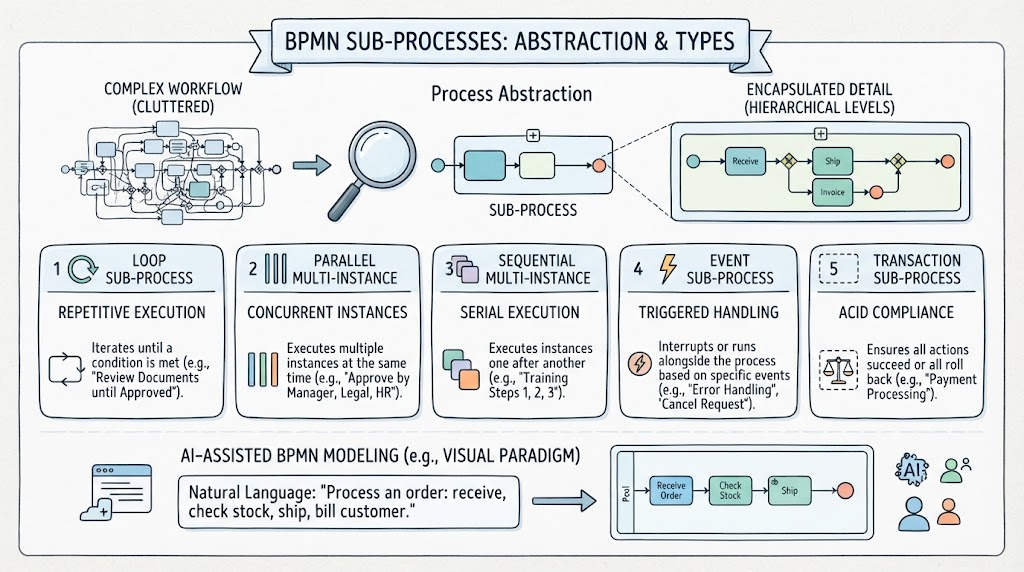
Comprendre les différents types de marqueurs de sous-processus est essentiel pour une modélisation précise. Chaque marqueur transmet des sémantiques comportementales spécifiques concernant la répétition, le parallélisme, la gestion des erreurs ou la flexibilité. Ce guide explore les cinq types principaux de sous-processus définis dansBPMN 2.0, fournissant des concepts clés et des exemples pratiques pour vous aider à sélectionner la bonne structure pour vos besoins métier. De plus, nous examinerons comment les outils modernesoutils assistés par l’IA, tels que Visual Paradigm, accélèrent la création de ces modèles sophistiqués en convertissant directement des récits en langage naturel en diagrammes BPMN conformes.
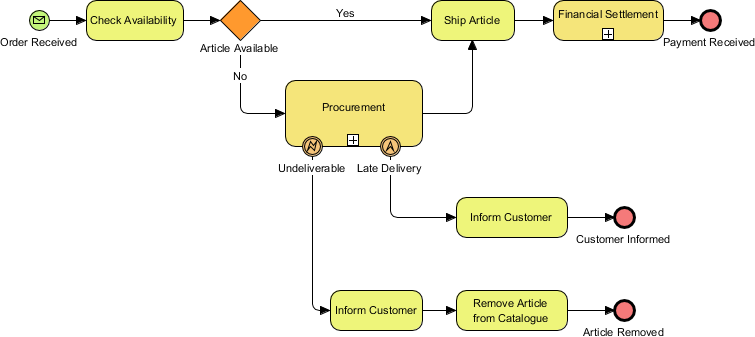
BPMN spécifie cinq types de marqueurs pour les sous-processus. Nous couvrirons chacun d’eux dans les sections ci-dessous.

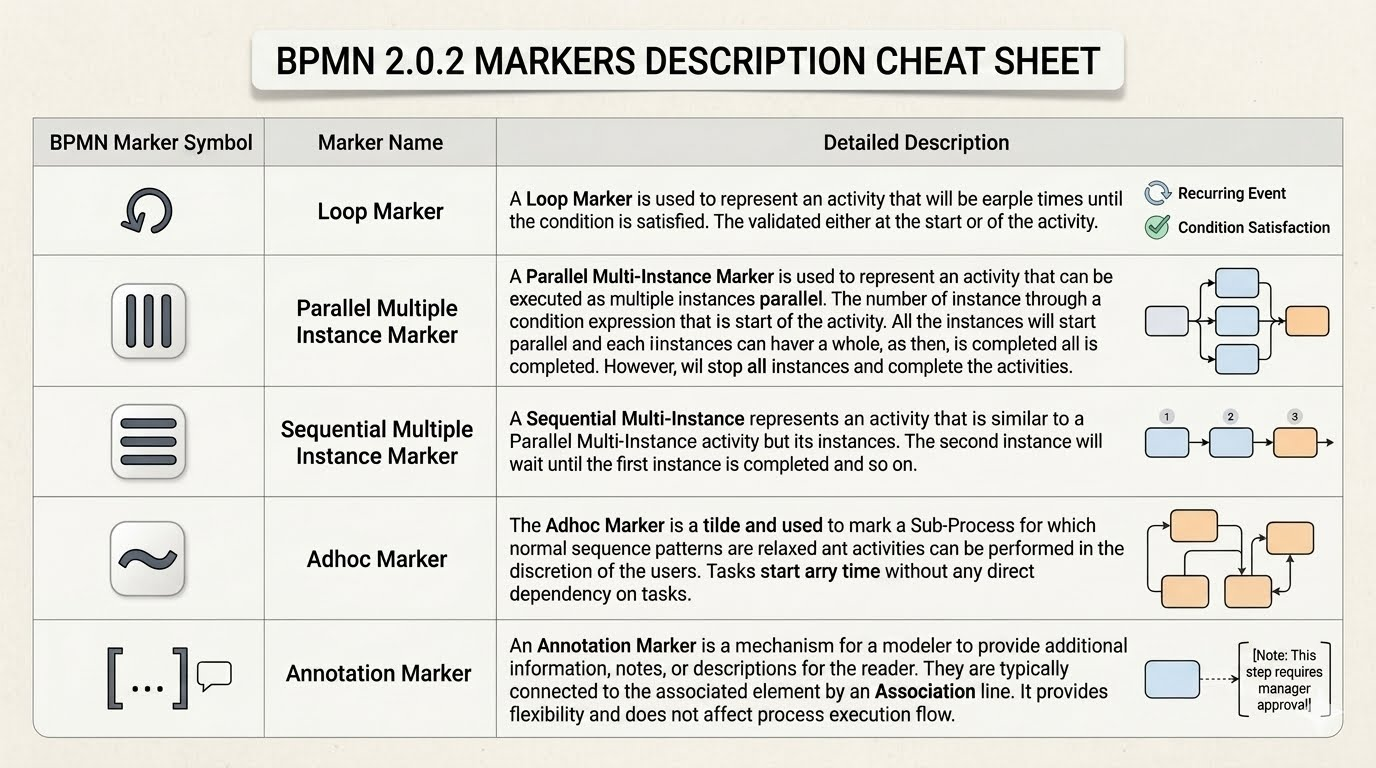
Types de marqueurs BPMN 2.0.2 : Un guide rapide
|
Symbole du marqueur
|
Nom du marqueur
|
Résumé comportemental
|
|---|---|---|
|
Boucle (Flèche circulaire)
|
Marqueur de boucle
|
Indique une répétition séquentielle d’une activité jusqu’à ce qu’une condition spécifique soit remplie. La condition est évaluée soit au début, soit à la fin de chaque itération.
|
|
Multi-instance parallèle (Trois barres verticales)
|
Marqueur d’instances multiples parallèles
|
Génère plusieurs instances identiques d’une activité qui s’exécutent simultanément. Toutes les instances doivent être terminées avant que le processus ne passe à l’étape suivante.
|
|
Multi-instance séquentiel (Trois barres horizontales)
|
Marqueur d’instances multiples séquentielles
|
Exécute plusieurs instances d’une activité les unes après les autres. Chaque instance attend que la précédente soit terminée avant de commencer, similaire à une boucle mais avec un nombre d’instances prédéfini.
|
|
Ad hoc (Tilde ~)
|
Marqueur ad hoc
|
Désigne un sous-processus flexible où les activités internes n’ont pas de séquence imposée. Les tâches peuvent être exécutées dans n’importe quel ordre, répétées ou ignorées selon la discrétion de l’utilisateur ou les conditions d’exécution.
|
|
Annotation ([…] avec icône de note)
|
Marqueur d’annotation
|
Fournit du texte supplémentaire, des notes ou des descriptions attachées via une ligne d’association. Ce marqueur ajoute du contexte pour les lecteurs sans modifier le flux de processus exécutable.
|
Sous-processus en boucle
Concepts clés
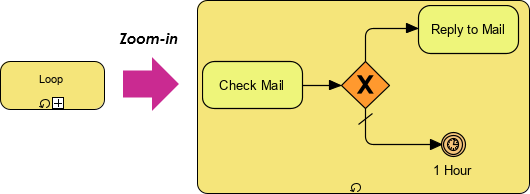
Unsous-processus avec un marqueur de boucle indique que l’activité se répète de manière séquentielle selon une condition définie. Contrairement aux modèles à instances multiples, les itérations de boucle se produisent l’une après l’autre ; la prochaine itération ne peut commencer que lorsque la précédente est terminée. Ce type est idéal lorsque les données ou l’état doivent être préservés et mis à jour à travers les itérations, ou lorsque des conditions exceptionnelles pourraient interrompre le cycle.
Exemple pratique : Gestion des e-mails
Considérons un processus « Vérifier les e-mails » où un employé consulte sa boîte de réception toutes les heures. Si de nouveaux e-mails existent, il y répond avant de revenir à l’état de vérification. Le marqueur de boucle modélise efficacement ce comportement cyclique. Comme le processus revient immédiatement après la réponse, il n’y a pas d’état d’attente si de nouveaux e-mails arrivent pendant la phase de réponse. Cela optimise le débit en assurant un traitement continu sans délais artificiels entre les cycles.
Sous-processus à instances multiples
Concepts clés
Alors que les boucles gèrent la répétition séquentielle, les sous-processus à instances multiples gèrent la concurrence. Ce marqueur indique que plusieurs instances du même sous-processus peuvent s’exécuter simultanément (en parallèle) ou séquentiellement. L’exécution parallèle est particulièrement précieuse pour améliorer l’efficacité lorsque des acteurs ou des ressources indépendants peuvent effectuer des tâches identiques en même temps.
Exemple pratique : Commande de pizza collaborative
Dans une communauté de colocation, des colocataires décidant d’une pizza pourraient passer un menu séquentiellement (une boucle), mais cela est inefficace. L’utilisation d’un sous-processus à instances multiples permet à tous les colocataires d’examiner le menu et de faire des sélections simultanément. Le processus attend que toutes les instances parallèles soient terminées avant de passer à l’étape de passation de commande. Cette distinction entre la boucle séquentielle et l’instanciation parallèle est cruciale pour représenter avec précision l’utilisation des ressources et la temporisation dans les modèles d’entreprise.
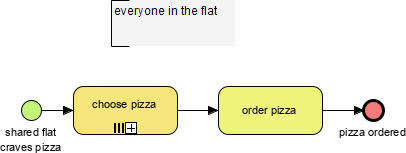
Un sous-processus avec un marqueur d’instances multiples indique que le sous-processus peut s’exécuter simultanément avec d’autres sous-processus identiques.
Sous-processus de compensation
Concepts clés
Les sous-processus de compensation sont des activités spécialisées conçues exclusivement pour annuler ou atténuer les effets d’une tâche précédemment terminée. Ils ne sont jamais déclenchés par des flux de séquence standards ; au contraire, ils sont activés uniquement par des événements de compensation via des associations. Cela les rend fondamentaux pour l’intégrité transactionnelle et la récupération d’erreurs dans les processus de longue durée.
Marqueurs combinés
Les marqueurs de compensation peuvent être combinés avec des marqueurs de boucle ou d’instances multiples. Lorsqu’ils sont combinés, les deux symboles apparaissent en parallèle à l’intérieur de la forme du sous-processus. Par exemple, une tâche de compensation manuelle peut devoir se répéter jusqu’à ce qu’elle réussisse (boucle + compensation) ou s’exécuter sur plusieurs enregistrements affectés simultanément (instances multiples + compensation). Ces combinaisons offrent un contrôle granulaire sur les stratégies de retour arrière.
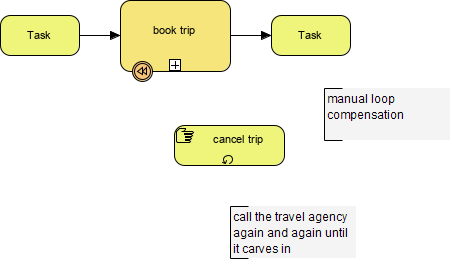
Un sous-processus avec un marqueur de compensation et un marqueur d’instances multiples indique que le sous-processus peut s’exécuter simultanément avec les actions de compensation et d’autres sous-processus à instances multiples.
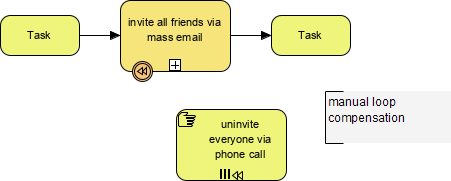
Sous-processus ad hoc
Concepts clés
Un ad hoc sous-processus représente des segments de flux de travail non structurés ou flexibles où l’ordre d’exécution n’est pas prédéterminé. Identifié par un marqueur tilde (~), ce type permet aux activités contenues d’être exécutées dans n’importe quel ordre, répétées plusieurs fois ou entièrement ignorées en fonction des décisions d’exécution. Il est le mieux adapté au travail de connaissance, à la gestion de cas ou à la résolution collaborative de problèmes où une séquence rigide entraverait l’efficacité.
Exemple pratique : Enquête sur un cas
Dans le cadre d’une enquête sur la fraude, les analystes peuvent devoir interroger des témoins, examiner des documents et effectuer des vérifications d’antécédents dans des séquences variables selon les preuves émergentes. Un sous-processus ad hoc s’adapte à cette fluidité, permettant à l’analyste de naviguer dynamiquement parmi les tâches disponibles plutôt que de suivre un chemin fixe.
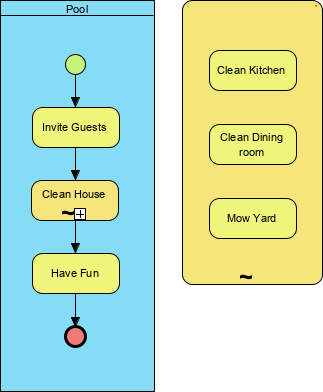
Accélération de la modélisation grâce à des outils assistés par l’IA
La création manuelle de sous-processus correctement structurés peut être chronophage. Les plateformes modernes comme Visual Paradigm exploitent le Traitement du Langage Naturel (TLN) pour transformer des récits en texte brut en modèles entièrement interactifs,diagrammes conformes à la norme BPMN 2.0. Plutôt que de produire des images statiques, ces outils génèrent de véritables modèles sémantiques où les couloirs, les passerelles et les types de sous-processus sont modifiables et réutilisables.
Les fonctionnalités clés incluent l’extraction automatique de rôles pour la génération de pools et de couloirs, le routage intelligent de la logique pour le placement des passerelles, et la traduction directe du texte vers le diagramme. Les utilisateurs peuvent accéder à ces fonctionnalités via des chatbots conversationnels alimentés par l’IA ou des menus dédiés à la génération de diagrammes, réduisant considérablement la barrière à l’entrée pour la modélisation hiérarchique complexe. En décrivant les rôles, la logique conditionnelle et les types de communication dans des récits structurés, les modélisateurs peuvent prototyper rapidement des structures de sous-processus et les affiner à l’aide de contrôles de validation intégrés.
Conclusion
Les sous-processus sont indispensables pour gérer la complexité dansla modélisation BPMN. Que vous ayez besoin de répétition séquentielle via des boucles, d’exécution concurrente via des marqueurs multi-instances, de sécurité transactionnelle avec compensation, ou de flexibilité opérationnelle via des structures ad hoc, le choix du bon marqueur garantit que votre diagramme reflète fidèlement la réalité des affaires. La maîtrise de ces cinq types permet une communication plus claire entre les parties prenantes et une automatisation des processus plus robuste. De plus,l’intégration d’outils assistés par l’IAdans votre pratique de modélisation simplifie la création de ces structures sophistiquées, permettant aux équipes de se concentrer sur l’optimisation des processus plutôt que sur la rédaction de diagrammes. À mesure que les environnements commerciaux continuent d’évoluer, la combinaison de normes BPMN rigoureuses avec une automatisation intelligente restera essentielle pour maintenir des opérations agiles et transparentes.
Ressources recommandées
- Du récit au diagramme : Comment le générateur BPMN par IA de Visual Paradigm transforme les flux de travail de modélisation de processus: Explique la méthodologie de conversion de descriptions textuelles structurées en diagrammes BPMN précis avec des couloirs et des passerelles appropriés.
- Guide complet de la BPMN 2.0 alimentée par l’IA avec Visual Paradigm : Apprendre par l’exemple: Fournit des tutoriels pratiques et des cas d’usage démontrant les capacités de modélisation de processus pilotées par l’IA au sein de l’écosystème Visual Paradigm.
- Comment le TLN alimenté par l’IA révolutionne la génération de texte vers BPMN pour la modélisation de processus d’entrepriseDétaille la technologie sous-jacente de TLN qui permet la compréhension sémantique des récits commerciaux pour la création automatisée de diagrammes.
- Aperçu des fonctionnalités des diagrammes et outils BPMN: Présente les fonctionnalités fondamentales de la modélisation BPMN, y compris les types de sous-processus, les règles de validation et les points d’intégration de l’IA.
- BPMN avec l’IA de Visual Paradigm : Un guide complet: Offre une guidance de bout en bout sur l’exploitation des assistants IA pour la conception itérative de processus et l’affinement des modèles.
- Maîtriser les types de flux BPMN : Un guide complet pour les utilisateurs de Visual Paradigm: Se concentre sur la distinction entre les flux de séquence, les flux de messages et les flux d’association dans des architectures de sous-processus complexes.
- Documentation du chatbot de diagrammes BPMN par IA: Décrit l’interface conversationnelle pour générer et itérer sur des modèles BPMN grâce à une interaction en langage naturel.
Cette publication est également disponible en Deutsch, English, Español, فارسی, English, Bahasa Indonesia, 日本語, Polski, Portuguese, Ру́сский, Việt Nam, 简体中文 : liste des langues séparées par une virgule, 繁體中文 : dernière langue.