


Dans le paysage de l’architecture d’entreprise, la clarté est la monnaie de l’efficacité. À mesure que les organisations se développent, leurs flux de travail opérationnels deviennent souvent des enchevêtrements complexes de dépendances, de points de décision et de transmissions. C’est ici queBusiness Process Model and Notation (BPMN) devient indispensable. Cependant, même les normes de modélisation les plus robustes font face à un défi :complexité. Lorsqu’un diagramme de processus contient des centaines d’éléments, il cesse d’être une carte pour devenir un labyrinthe.
Ce guide explore commentles sous-processus BPMNservent de mécanisme principal pour gérer cette complexité. En abstrayant les détails dans des conteneurs gérables, les modélisateurs peuvent maintenir une visibilité de haut niveau tout en préservant la logique granulaire. Nous examinerons les types structurels, les implications en matière de données et les stratégies de gouvernance nécessaires pour mettre en œuvre cette approche efficacement.
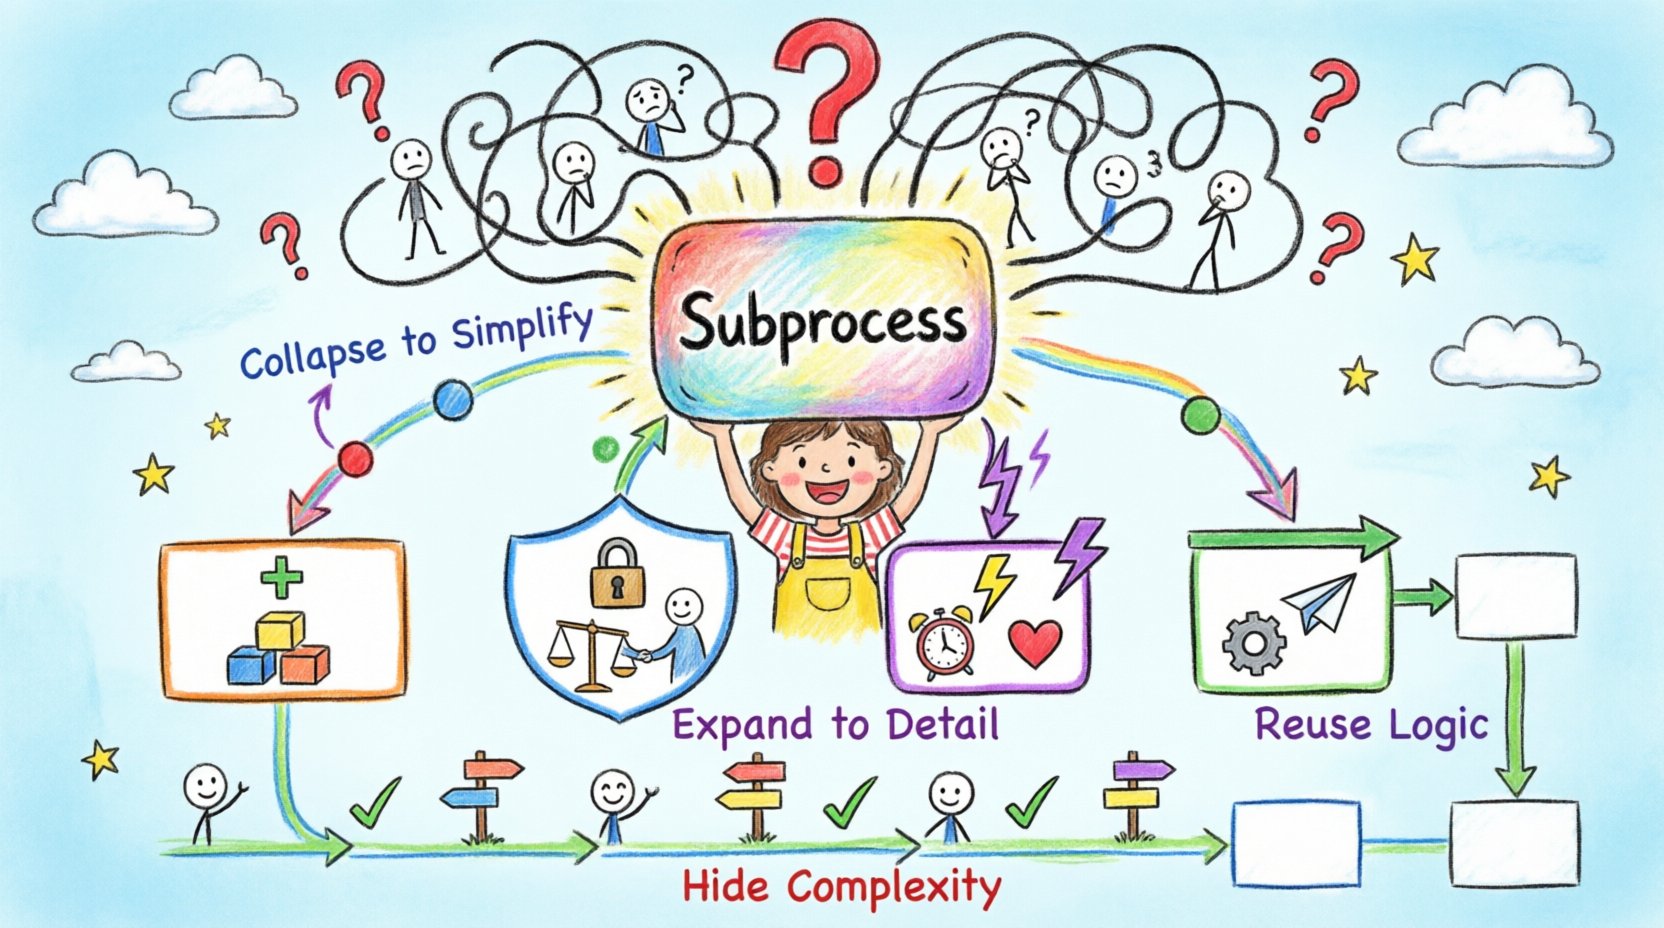
🧩 Le défi de la complexité des processus
Les grands systèmes fonctionnent rarement de manière linéaire. Ils impliquent des flux parallèles, des branchements conditionnels et des interactions humaines qui s’étendent sur plusieurs départements. Un seul diagramme de flux de processus représentant un cycle de vie de traitement de commande de bout en bout peut inclure :
- Étapes d’authentification du client
- Logique de vérification des stocks
- Intégration de la passerelle de paiement
- Sélection du transporteur
- Boucles de rétroaction post-livraison
Tenter de visualiser tous ces éléments sur une seule toile crée plusieurs problèmes :
- Encombrement visuel :Les lignes se croisent, rendant impossible de suivre un chemin spécifique sans se perdre.
- Charge cognitive :Les parties prenantes ne peuvent pas saisir la « vue d’ensemble » sans être submergées par les détails techniques.
- Surcoût de maintenance :Mettre à jour un seul sous-composant nécessite de réévaluer l’intégralité du diagramme.
- Conflits de contrôle de version :Plusieurs analystes travaillant sur différentes parties du même fichier volumineux augmentent le risque d’erreurs de fusion.
La solution réside dansl’abstraction. BPMN fournit des constructions spécifiques pour masquer la complexité sans perdre la capacité d’approfondir. C’est la fonction principale de l’élément Sous-processus.
📦 Comprendre l’élément Sous-processus
Un sous-processus est un conteneur qui encapsule un ensemble d’activités, d’événements et de passerelles. Il fonctionne comme une tâche unique au sein d’un processus parent plus large, tout en contenant sa propre logique interne. Cette structure hiérarchique permet une philosophie de conception modulaire similaire au développement logiciel.
🔍 Vues réduites vs. vues développées
La représentation visuelle d’un sous-processus est dynamique. Elle peut s’afficher dans deux états principaux :
- Réduit :Le sous-processus apparaît sous la forme d’un rectangle comportant un signe plus (+) ou une icône spécifique au centre. Il masque tous les détails internes.
- Développé :Le sous-processus est ouvert pour révéler les activités, événements et passerelles qu’il contient.
Cette dualité est essentielle pour la communication. Un intervenant examinant un tableau de bord stratégique voit la vue réduite, comprenant le flux de haut niveau. Un analyste effectuant le dépannage d’une défaillance spécifique voit la vue développée, comprenant la logique à l’intérieur du bloc.
🛠️ Types de sous-processus dans la BPMN
La BPMN 2.0 définit des types spécifiques de sous-processus, chacun ayant un objectif distinct. Comprendre ces distinctions est essentiel pour une modélisation précise.
| Type | Marqueur d’icône | Comportement | Cas d’utilisation |
|---|---|---|---|
| Sous-processus standard | Signe plus (+) | S’exécute de manière séquentielle | Regroupement logique général |
| Sous-processus transaction | Double défilement | Exécution atomique (Tout ou rien) | Mises à jour de données financières ou critiques |
| Sous-processus événement | Cercle (pointillé) | Déclenché par des événements spécifiques | Gestion des erreurs ou interruptions |
| Activité d’appel | Double cercle | Réutilise un processus externe | Réutilisation modulaire de processus à travers les systèmes |
1. Sous-processus standard
Le type le plus courant. Il regroupe des activités qui appartiennent logiquement ensemble. Par exemple, une étape « Traiter le paiement » dans un flux de commande peut contenir un sous-processus standard avec des étapes pour la validation, l’autorisation et la génération du reçu. Le processus parent traite l’ensemble de ce groupe comme une seule unité de travail.
2. Sous-processus de transaction
Les transactions sont conçues pour la fiabilité. Si un sous-processus de transaction échoue en cours d’exécution, le système tente de revenir en arrière (rollback) sur toutes les modifications apportées au sein de ce sous-processus pour garantir l’intégrité des données. Cela est essentiel pour la banque, la déduction de stock ou tout scénario où une exécution partielle est inacceptable.
3. Sous-processus événementiel
Les sous-processus événementiels s’exécutent en parallèle du flux principal, en attendant un déclencheur spécifique. Ils sont souvent utilisés pour la gestion des erreurs. Si une exception se produit dans le processus principal (comme un dépassement de délai ou une panne réseau), le sous-processus événementiel s’active pour gérer la récupération.
- Événement de démarrage : Définit ce qui déclenche le sous-processus (par exemple, une erreur de message ou un signal).
- Événements de bordure : Peuvent être attachés aux tâches pour capturer les erreurs sans interrompre le flux jusqu’à ce que l’événement se produise.
4. Activité d’appel
Une activité d’appel fait référence à un processus qui existe ailleurs. Elle n’est pas dessinée à l’intérieur du diagramme parent. Au lieu de cela, elle appelle un fichier BPMN distinct. Cela favorise une véritable modularité. Si un processus « Vérification du crédit » est utilisé dans cinq applications différentes, vous le modélisez une seule fois. Les cinq applications font référence à la même activité d’appel. Si la logique de crédit change, vous mettez à jour un seul fichier, et toutes les applications en bénéficient.
🔄 Flux de données et transmission du contexte
L’un des aspects les plus techniques des sous-processus concerne la manière dont les données entrent et sortent. Un sous-processus n’est pas une île isolée ; il nécessite des entrées et produit des sorties. Une cartographie appropriée des données garantit que le processus parent peut transmettre le contexte à l’enfant, et que l’enfant peut renvoyer les résultats.
📥 Données d’entrée
Les données peuvent être transmises à un sous-processus via :
- Objets de données d’entrée : Définis au niveau du sous-processus, ces objets correspondent à des variables dans la portée du processus parent.
- Flux de séquence :Les données peuvent être transportées le long des chemins entrant dans l’événement de démarrage du sous-processus.
- Flux de messages :Si le sous-processus se trouve dans une piscine différente, les messages transportent les données.
📤 Données de sortie
Les résultats sont renvoyés de manière similaire :
- Objets de données de sortie :Les variables remplies à l’intérieur du sous-processus sont mappées vers la portée du processus parent à la fin de l’exécution.
- Événements de fin :Des événements de fin spécifiques peuvent signaler un succès ou un échec, déclenchant ainsi différents chemins de données dans le processus parent.
Important :La portée des données est critique. Les variables créées à l’intérieur d’un sous-processus restent généralement locales sauf si elles sont explicitement mappées vers le processus parent. L’absence de mappage des données de sortie entraîne souvent que le processus parent continue avec des valeurs par défaut ou nulles, provoquant des erreurs en aval.
📐 Structuration pour la maintenabilité
Pour gérer efficacement la complexité, les modélisateurs doivent respecter les meilleures pratiques structurelles. Un regroupement ad hoc conduit souvent à des diagrammes en spaghetti impossibles à maintenir.
- Nommage cohérent :Chaque sous-processus doit avoir un nom clair et descriptif. Évitez les étiquettes génériques comme « Processus 1 ». Utilisez « Valider l’identité du client » ou « Générer une facture ».
- Une seule entrée, une seule sortie :Dans la mesure du possible, concevez les sous-processus pour qu’ils entrent à un seul point et sortent à un seul point. Cela simplifie le traçage et réduit la complexité des passerelles.
- Limitez la profondeur d’imbrication :Bien que l’imbrication soit autorisée, des hiérarchies profondes (plus de 3 niveaux) rendent la navigation difficile. Si vous vous retrouvez à imbriquer profondément, reconsidérez si le processus doit être décomposé en Activités d’appel distinctes.
- Utilisez les nageurs de couloir :Attribuez les sous-processus aux bons couloirs. Cela clarifie quel rôle ou système est responsable de la logique encapsulée.
⚠️ Erreurs courantes de modélisation
Même les modélisateurs expérimentés tombent dans des pièges lors de l’utilisation de sous-processus. Identifier ces écueils tôt permet d’éviter la dette technique.
| Erreur | Conséquence | Atténuation |
|---|---|---|
| Fuite de portée | Les variables définies à l’intérieur fuient vers le parent, provoquant des conflits de nommage. | Utilisez des préfixes de variables locales (par exemple, «sub_var) ou une mappage strict. |
| Sur-imbrication | Le processus devient trop profond pour être navigué efficacement. | Aplatissez la hiérarchie en utilisant des Activités d’appel là où la logique est réutilisée. |
| Gestion des erreurs manquante | Le sous-processus échoue silencieusement dans le flux parent. | Attachez des Sous-processus d’événements pour capturer les exceptions. |
| Limites floues | Il n’est pas clair quelles activités appartiennent au sous-processus. | Utilisez un regroupement visuel (bassins BPMN) ou des conventions de nommage strictes. |
🔗 Intégration avec des systèmes externes
Les grands systèmes existent rarement en isolation. Les sous-processus agissent souvent comme des ponts entre le processus principal et les API externes, les bases de données ou les systèmes hérités.
🔌 Encapsulation des tâches de service
Lorsqu’un processus appelle un service web, il est recommandé d’encapsuler cet appel dans un sous-processus. Cela sépare la logique métier de la logique d’intégration technique. Si l’extrémité de l’API change, vous mettez à jour le sous-processus, et non l’ensemble du flux métier.
🔄 Opérations asynchrones
Certains sous-processus impliquent des tâches de longue durée. Un sous-processus gérant la « Génération de rapports en arrière-plan » peut ne pas se terminer en quelques secondes. L’utilisation d’un sous-processus permet au processus parent de faire une pause et d’attendre, ou de continuer avec d’autres travaux pendant que le sous-processus s’exécute de manière asynchrone.
📜 Gouvernance et normalisation
Pour que les sous-processus soient efficaces au sein d’une organisation, ils doivent être gouvernés. Sans normes, une équipe pourrait utiliser une vue réduite tandis qu’une autre utilise une vue étendue, ce qui entraîne de la confusion.
- Guides de style : Définir des couleurs standard pour les sous-processus (par exemple, tous les sous-processus de transaction sont orange).
- Modèles : Créer des modèles standard pour les sous-processus courants (par exemple, « Gestionnaire d’erreurs standard ») afin d’assurer la cohérence.
- Processus d’examen : Inclure la modélisation des sous-processus dans la phase d’assurance qualité. Vérifier que la mappage des données est correct avant l’approbation.
- Documentation : Lier la documentation externe au sous-processus. Si un sous-processus est complexe, un lien vers un PDF détaillé ou une page wiki peut être joint aux propriétés de l’élément.
🚀 Avenir-proofing de vos modèles
Les processus évoluent. Les exigences changent. La nature modulaire des sous-processus facilite l’adaptation. Lorsqu’une nouvelle réglementation exige une étape dans le flux de paiement, vous pouvez l’ajouter au sous-processus « Traitement du paiement » sans modifier le diagramme de flux de commande. Cette isolation est le principal avantage de l’approche.
De plus, à mesure que les organisations se tournent vers l’automatisation et l’automatisation robotique des processus (RPA), les sous-processus deviennent les unités de déploiement. Un moteur d’automatisation peut cibler un sous-processus spécifique pour qu’il soit exécuté par un robot, laissant intactes les parties du processus parent centrées sur l’humain.
🔑 Points clés pour la mise en œuvre
- L’abstraction est essentielle : Utilisez des sous-processus pour masquer les détails jusqu’à ce qu’ils soient nécessaires.
- Mappage des données : Soyez rigoureux sur la manière dont les variables transitent entre le processus parent et le sous-processus.
- Logique de transaction : Utilisez des sous-processus de transaction pour les opérations critiques et atomiques.
- Modularité : Privilégiez les activités d’appel pour la logique réutilisée dans plusieurs processus.
- Gestion des erreurs : Concevez des sous-processus d’événements pour chaque chemin critique afin de capturer les échecs de manière élégante.
Maîtriser l’utilisation des sous-processus dans la modélisation et la notation des processus métier transforme un diagramme chaotique en un système structuré et évolutif. Cela respecte les limites cognitives du lecteur tout en préservant la profondeur technique requise pour l’exécution. En appliquant ces principes, les organisations peuvent construire des processus qui sont non seulement précis, mais aussi adaptables aux exigences changeantes de l’entreprise moderne.
Cette publication est également disponible en Deutsch, English, Español, فارسی, English, Bahasa Indonesia, 日本語, Polski, Portuguese, Ру́сский, Việt Nam, 简体中文 : liste des langues séparées par une virgule, 繁體中文 : dernière langue.