


Einführung
In der modernen Softwareentwicklung ist die Lücke zwischen Architekturdesign und technischer Dokumentation oft der Punkt, an dem Projekte an Schwung verlieren. Diagramme werden zu veralteten Screenshots, die Dokumentation entfernt sich von der Realität, und die Einarbeitung neuer Teammitglieder wird zu einer mühsamen Übung beim Entschlüsseln von Legacy-Artefakten.
Das KI-gestützte Ökosystem von Visual Paradigm adressiert diese Herausforderung, indem es die Art und Weise verändert, wie Teams technische Dokumentation erstellen und pflegen. Durch die Verbindung von konversationeller Diagrammerstellung, strukturiertem C4-Modellieren, einer zentralisierten Asset-Pipeline und lebendiger Dokumentation in einem nahtlosen Workflow stellt es sicher, dass Ihre Architektur und Ihre Dokumente gemeinsam als einzige Quelle der Wahrheit weiterentwickelt werden.
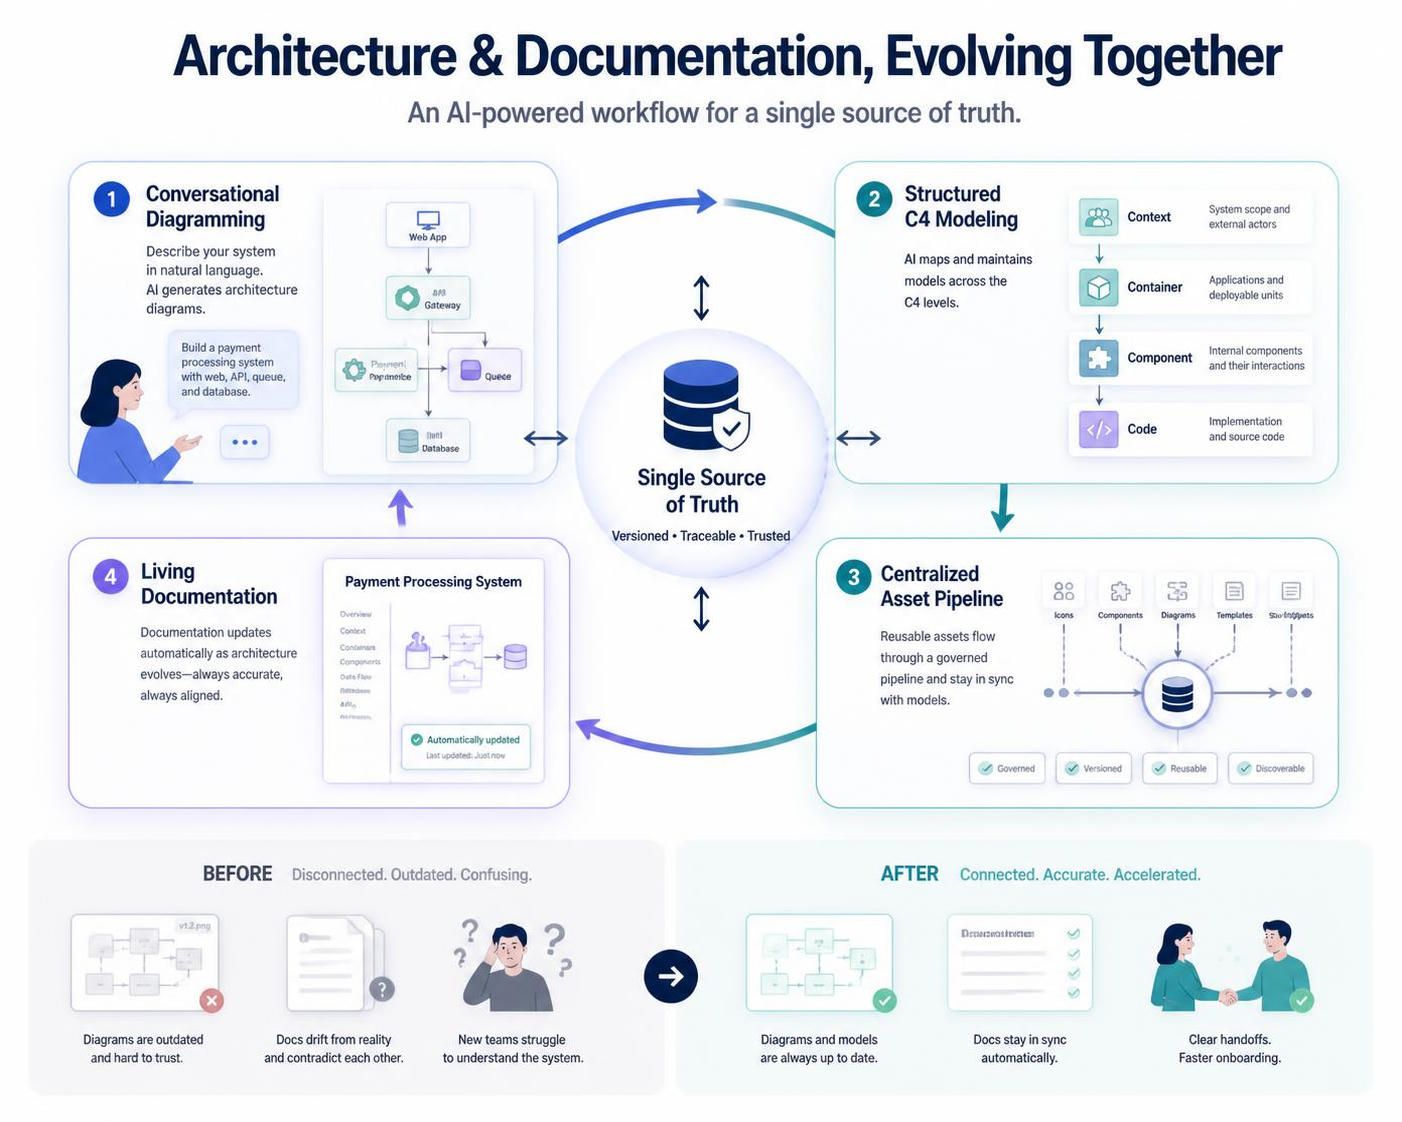
Dieser Leitfaden bietet einen umfassenden, schrittweisen Überblick über diesen vollständigen Workflow – von der ersten Brainstorming-Phase mit KI bis zur Veröffentlichung selbstaktualisierender lebendiger Dokumentation – ergänzt durch umfangreiche PlantUML-Beispiele und Best Practices.
Teil 1: Schlüsselkonzepte und Überblick über das Ökosystem
Die vier Säulen
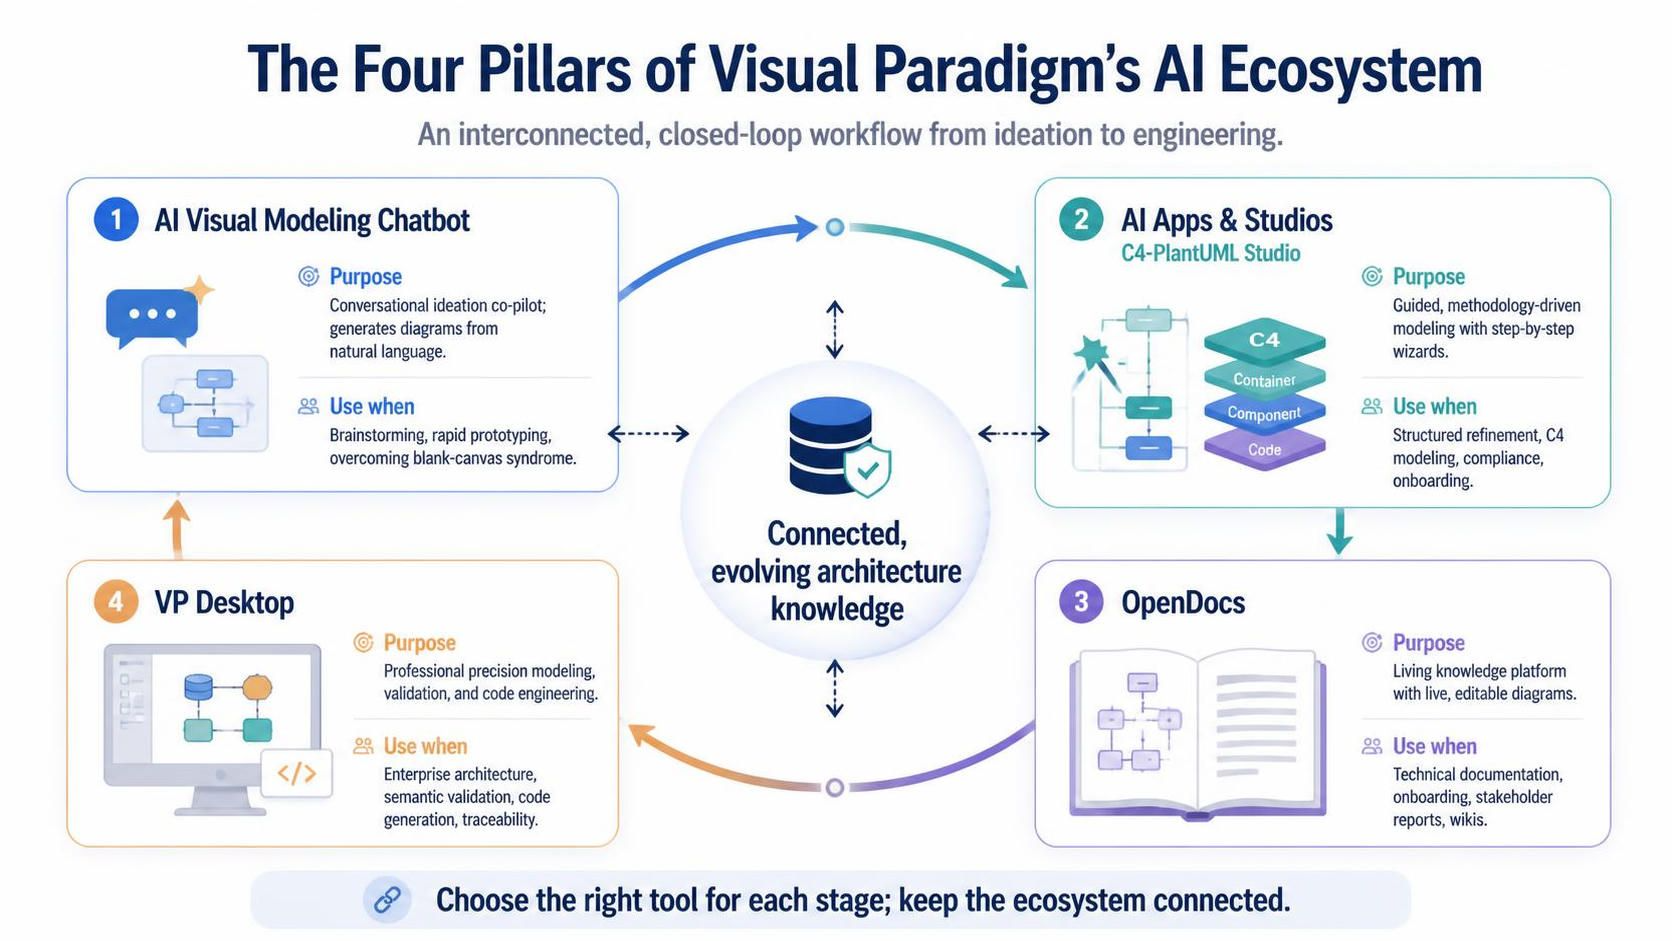
Das Ökosystem von Visual Paradigm besteht aus vier miteinander verbundenen KI-Säulen, die zusammenarbeiten, um einen geschlossenen Workflow zu schaffen:
| Säule | Zweck | Wann verwenden |
|---|---|---|
| KI-Chatbot für visuelles Modellieren | Konversationeller Ideenfindungs-Co-Pilot; erstellt Diagramme aus natürlicher Sprache | Brainstorming, schnelles Prototyping, Überwindung des „Blank Canvas”-Syndroms” |
| KI-Apps & Studios (C4-PlantUML Studio) | Geführtes, methodengesteuertes Modellieren mit schrittweisen Assistenten | Strukturierte Verfeinerung, C4-Modellierung, Compliance, Einarbeitung |
| OpenDocs | Lebendige Wissensmanagement-Plattform mit live-editierbaren Diagrammen | Technische Dokumentation, Einarbeitung, Stakeholder-Berichte, Wikis |
| VP Desktop | Professionelles Präzisionsmodellieren, Validierung und Code-Engineering | Unternehmensarchitektur, semantische Validierung, Code-Generierung, Rückverfolgbarkeit |
Die OpenDocs-Pipeline
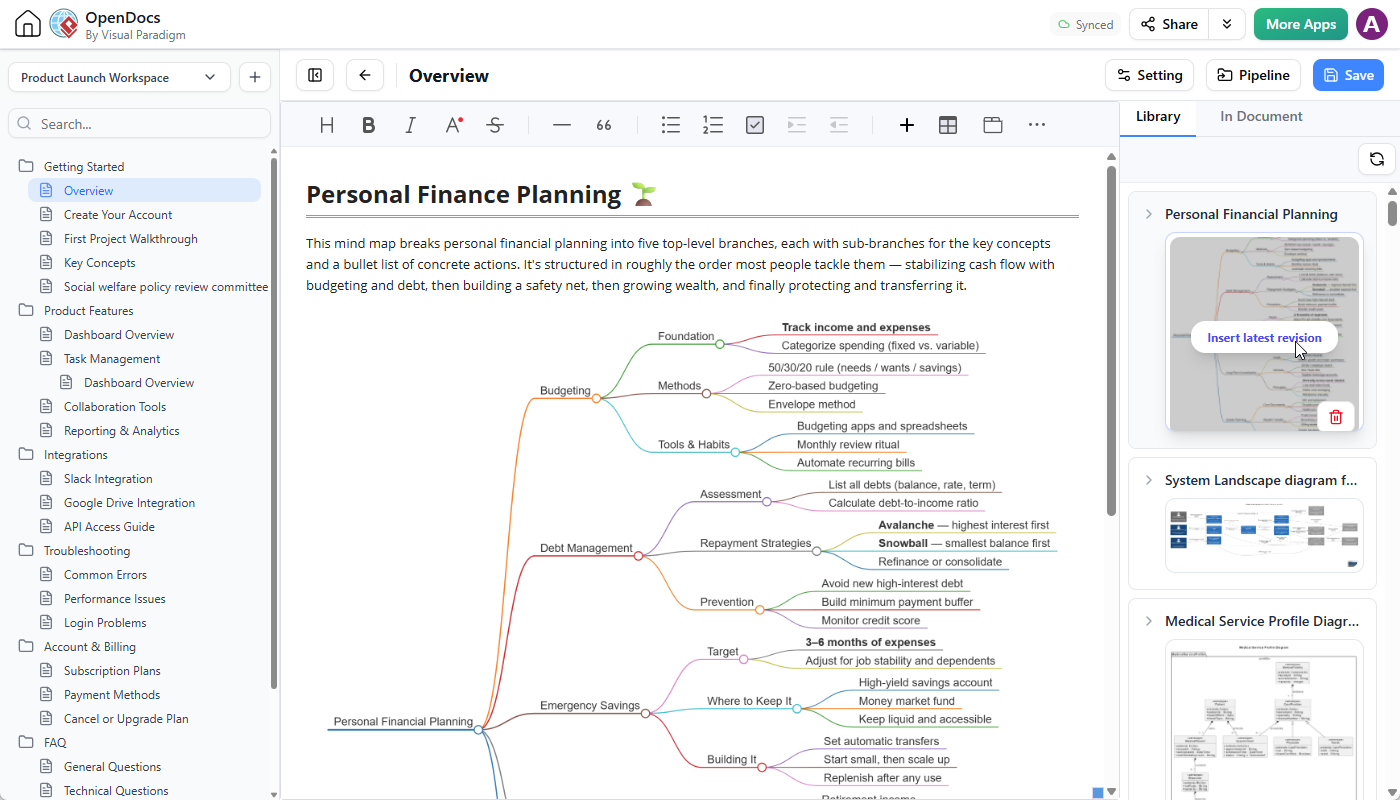
Die Pipeline fungiert als sicherer, cloudbasierter zentraler Transit-Hub, der alle fünf Ausführungsumgebungen innerhalb des Visual Paradigm-Ökosystems verbindet. Sie ermöglicht es Teams, Artefakte aus mehreren Quellen direkt in eine einheitliche technische Dokumentation zu streamen, ohne manuelle Dateiübertragungen oder Screenshots.
Hauptmerkmale:
-
Cloud-basiertes Repository: Zugriff auf Artefakte von jedem Gerät
-
Versionsbewusst: Automatische Revisionserfassung mit Commit-Hinweisen
-
Bearbeitbarkeit erhalten: Diagramme bleiben mit Quellmodellen verknüpft, nicht mit statischen Bildern
-
Rollenbasierter Zugriff: Berechtigungen pro Projekt, Team oder Artefakt konfigurieren
-
KI-integriert: Native Unterstützung für KI-generierte und KI-verfeinerte Diagramme
Die fünf Ausführungsumgebungen:
| Plattform | Modellierung der Natur | Lebenszyklus & Versionierung | Idealer Anwendungsfall |
|---|---|---|---|
| 1. KI-Chatbot | Code-getrieben / Prompt-basiert | Statische Schnappschüsse | Schnelles Brainstorming, Text-zu-Diagramm-Generierung |
| 2. Online-Editor | Visuelle Leinwand-getrieben | Manuelle Verfolgung | Styling-Anpassungen, kollaborative browserbasierte Bearbeitung |
| 3. OpenDocs | Verbraucher & natives Autoring | Live-Link-Einfügung | Zusammenstellung der Enddokumentation, Querverweise |
| 4. Desktop-App | Modellgetrieben & validiert | Automatische Revisionen | Unternehmensarchitektur, validierte Ingenieursmodelle |
| 5. Web-Apps (C4-Wizards) | Kontextgesteuerte Assistenten | Strukturelle Architektur | Modellierung komplexer Frameworks, schrittweise geführte Gestaltung |
Das C4-Modell
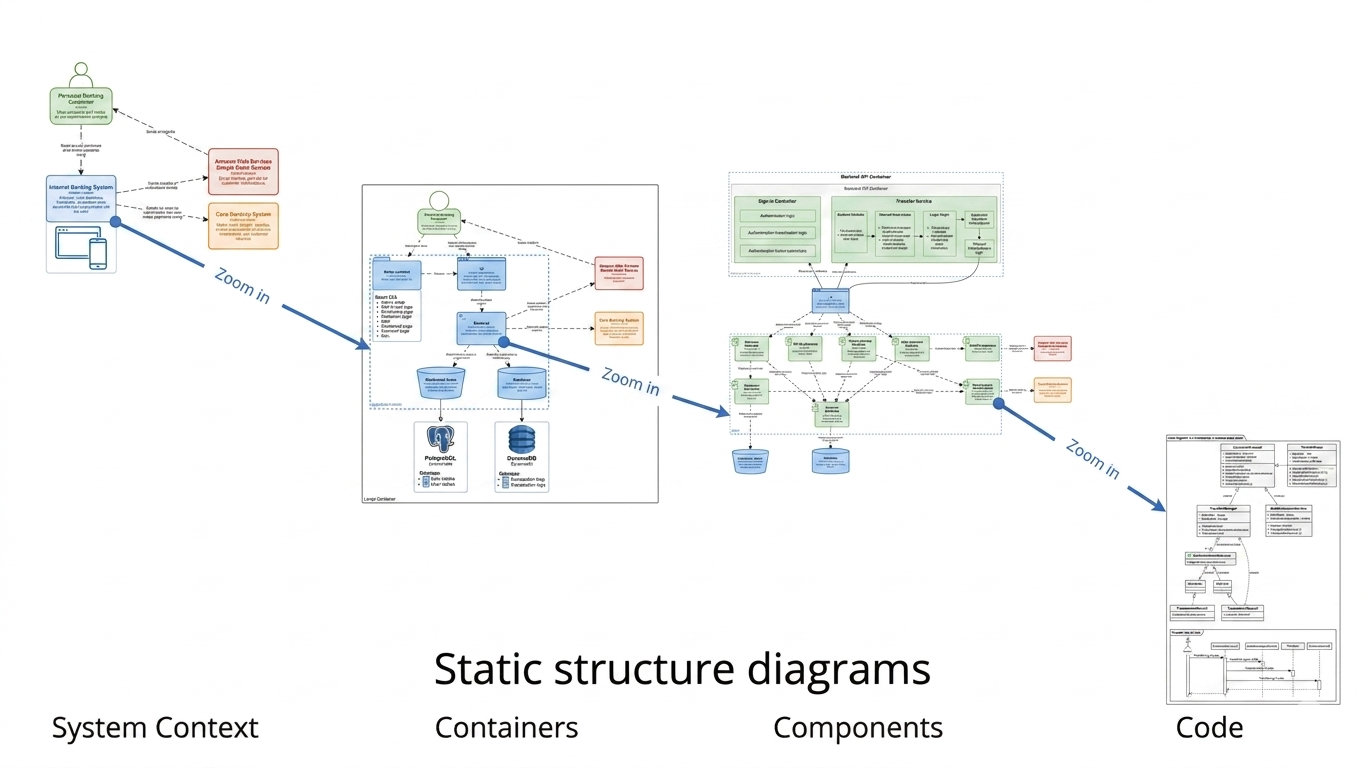
Das C4-Modell, entwickelt von Simon Brown, ist ein hierarchischer Ansatz zur Visualisierung der Softwarearchitektur auf vier Ebenen:
| Ebene | Zweck | Beispiel |
|---|---|---|
| Kontext | Zeigt das System in seiner Umgebung, einschließlich Benutzer und externer Systeme | „E-Commerce-Plattform, die mit Benutzern, Zahlungsgateways und Inventarsystemen interagiert“ |
| Container | Unterteilt das System in deploybare Einheiten (Apps, Datenbanken, Microservices) | „Frontend (React), Backend (Node.js), Datenbank (PostgreSQL)“ |
| Komponente | Beschreibt interne Module und deren Interaktionen | „Benutzerdienst, Auftragsdienst, Zahlungsprozessor“ |
| Code (Optional) | Geht in Details auf Klassenebene ein | „UserRepository, OrderController“ |
Dynamische Ansichten (Sequenz, Bereitstellung) ergänzen die statische Struktur und zeigen Laufzeitverhalten und Infrastruktur.
Teil 2: Schritt-für-Schritt-Arbeitsablauf-Leitfaden
Schritt 1: Ideenfindung mit dem KI-Chatbot
Ziel: Verwandeln Sie eine vage Idee in Sekunden in ein visuelles Prototyp.
Arbeitsablauf:
-
Greifen Sie auf den KI-Chatbot zuüber Ihren Visual Paradigm-Arbeitsbereich oder chat.visual-paradigm.com
-
Stellen Sie der KI eine Anfrage in natürlicher SpracheBeschreiben Sie Ihr System oder Ihren Szenario:
"Erstellen Sie ein C4-Systemkontextdiagramm für eine E-Commerce-Plattform" "Erstellen Sie ein Sequenzdiagramm für unseren Microservices-Authentifizierungsfluss" "Zeigen Sie mir ein Use-Case-Diagramm für eine Food-Delivery-App" -
Überprüfen und verfeinern Sie iterativunter Verwendung von Folgebefehlen:
-
„Fügen Sie einen Admin-Aktor hinzu, der Passwörter zurücksetzen kann“
-
„Fügen Sie eine Wiederholungsschleife ein, falls die OTP-Validierung fehlschlägt (max. 3 Versuche)“
-
„Zeigen Sie parallele Nachrichten: Nach erfolgreicher Zahlung den Kunden benachrichtigen und gleichzeitig den Lagerbestand aktualisieren“
-
-
In Pipeline exportieren: Klicken Sie auf das Export-Symbol → Wählen Sie An OpenDocs-Pipeline senden
-
Metadaten hinzufügen: Fügen Sie beschreibende Kommentare wie „Entwurf des Basis-Authentifizierungsflusses – Q2 2026“ zur Versionsidentifikation hinzu
💡 Profi-Tipp: Verwenden Sie den Chatbot für schnelle Iterationen bei Konzepten im Frühstadium. Sobald sich ein Diagramm stabilisiert hat, migrieren Sie es zur semantischen Validierung und automatischen Synchronisierung in die Desktop-Anwendung.
Beispiel-PlantUML für ein C4-Kontextdiagramm
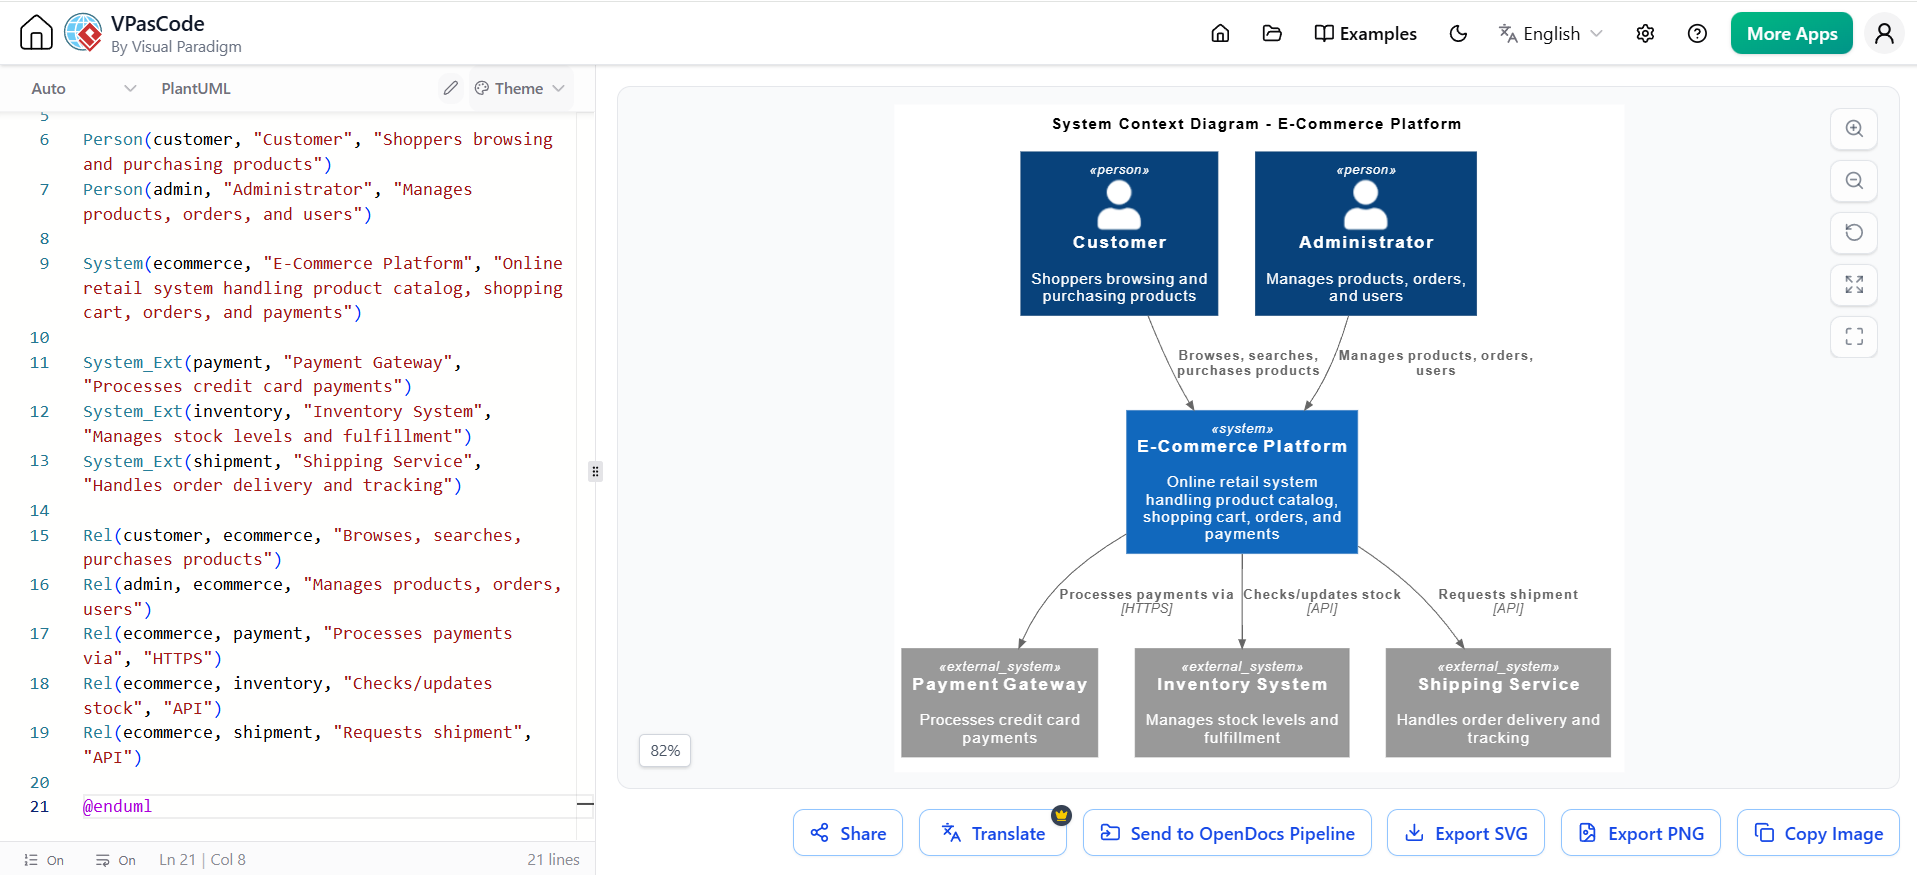
@startuml
!include https://raw.githubusercontent.com/plantuml-stdlib/C4-PlantUML/master/C4_Context.puml

title System Context Diagram - E-Commerce Platform

Person(customer, "Kunde", "Einkäufer, die Produkte durchsuchen und kaufen")
Person(admin, "Administrator", "Verwaltet Produkte, Bestellungen und Benutzer")

System(ecommerce, "E-Commerce-Plattform", "Online-Handelssystem, das Produktkatalog, Warenkorb, Bestellungen und Zahlungen verwaltet")

System_Ext(payment, "Zahlungs-Gateway", "Verarbeitet Kreditkartenzahlungen")
System_Ext(inventory, "Lagersystem", "Verwaltet Lagerbestände und Auslieferungen")
System_Ext(shipment, "Versanddienst", "Verwaltet Bestellzustellung und Verfolgung")

Rel(customer, ecommerce, "Durchsucht, sucht, kauft Produkte")
Rel(admin, ecommerce, "Verwaltet Produkte, Bestellungen, Benutzer")
Rel(ecommerce, payment, "Verarbeitet Zahlungen über", "HTTPS")
Rel(ecommerce, inventory, "Prüft/aktualisiert Lagerbestand", "API")
Rel(ecommerce, shipment, "Fordert Versand an", "API")

@enduml
PlantUML in VPasCode bearbeiten
Beispiel-PlantUML für ein Sequenzdiagramm
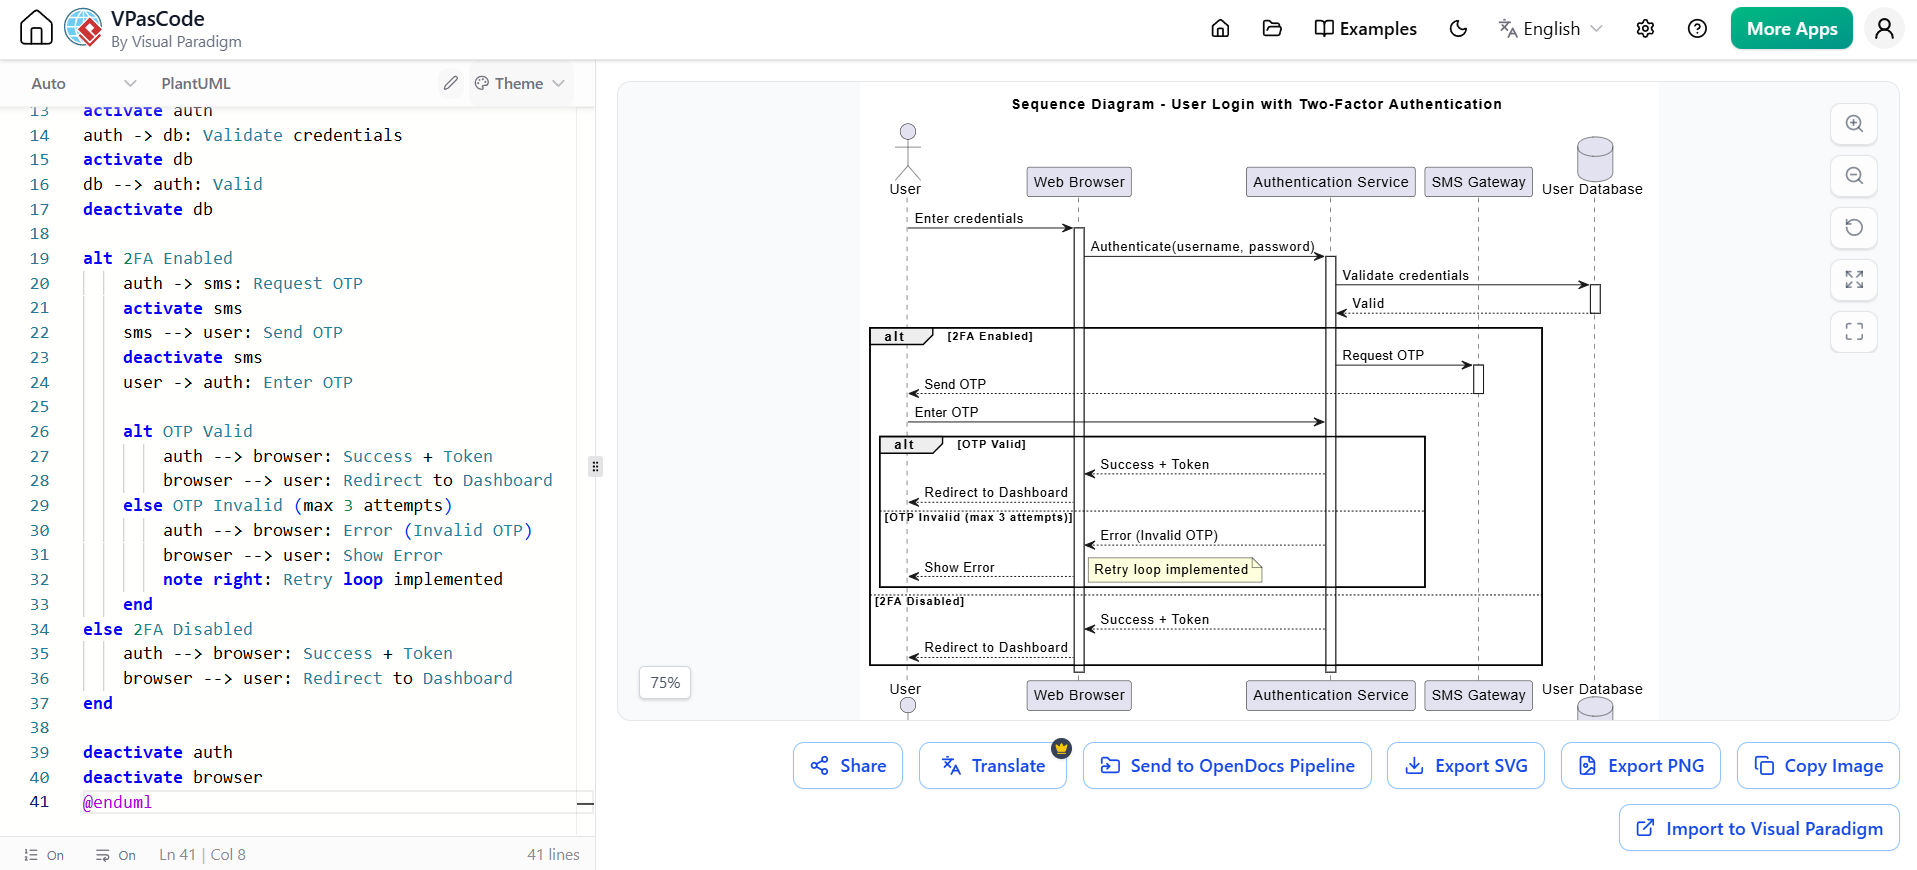
@startuml
title Sequence Diagram - Benutzeranmeldung mit Zwei-Faktor-Authentifizierung

actor "Benutzer" as user
participant "Web-Browser" as browser
participant "Authentifizierungsdienst" as auth
participant "SMS-Gateway" as sms
database "Benutzerdatenbank" as db

user -> browser: Anmelden mit Zugangsdaten
activate browser
browser -> auth: Authentifizieren(Benutzername, Passwort)
activate auth
auth -> db: Zugangsdaten validieren
activate db
db --> auth: Gültig
deactivate db

alt 2FA aktiviert
    auth -> sms: OTP anfordern
    activate sms
    sms --> user: OTP senden
    deactivate sms
    user -> auth: OTP eingeben

    alt OTP gültig
        auth --> browser: Erfolg + Token
        browser --> user: Zum Dashboard weiterleiten
    else OTP ungültig (max. 3 Versuche)
        auth --> browser: Fehler (Ungültige OTP)
        browser --> user: Fehler anzeigen
        note right: Wiederholungsschleife implementiert
    end
else 2FA deaktiviert
    auth --> browser: Erfolg + Token
    browser --> user: Zum Dashboard weiterleiten
end

deactivate auth
deactivate browser
@enduml
PlantUML in VPasCode bearbeiten
Schritt 2: Strukturierte Verfeinerung mit C4-PlantUML Studio
Ziel: Entwickeln Sie die KI-generierte Skizze zu einem vollständigen, normkonformen C4-Modell weiter.
Ablauf:
-
Starten Sie die C4-Architektur-Richtlinieaus dem Menü für Web-Apps
-
Definieren Sie die Problemstellung– Verwenden Sie KI-Assistenz, um eine vollständige Beschreibung zu generieren:
-
Projektname
-
Systemzweck
-
Hauptbenutzer
-
Wichtige Integrationen
-
-
Generieren Sie jede C4-Ebene schrittweise:
-
Ebene 1 – Systemkontext: Geben Sie Systemgrenzen, externe Benutzer und abhängige Systeme ein
-
Ebene 2 – Container: Konfigurieren Sie bereitstellbare Anwendungen, Datenbanken und externe Dienste
-
Ebene 3 – Komponenten: Verfeinern Sie interne Code-Module und deren Interaktionen
-
Ebene 4 – Code (optional): Abbildung auf tatsächliche Code-Strukturen
-
-
Unterstützende Ansichten hinzufügen:
-
Dynamische/Sequenzdiagramme: Zeigen Sie Laufzeit-Interaktionen an
-
Bereitstellungsdiagramme: Abbildung von Software auf Infrastruktur
-
Landschaftsdiagramme: Zeigen Sie das System im weiteren Unternehmenskontext
-
-
In Pipeline streamen: Klicken Sie auf Struktur in Pipeline streamen um den gesamten hierarchischen Modellblock zu exportieren
🎯 Anwendungsfall: Ideal für Architektur-Review-Gremien, Onboarding-Dokumentationen und Stakeholder-Präsentationen, bei denen mehrschichtige Klarheit unerlässlich ist.
Beispiel für ein C4-Container-Diagramm (PlantUML)
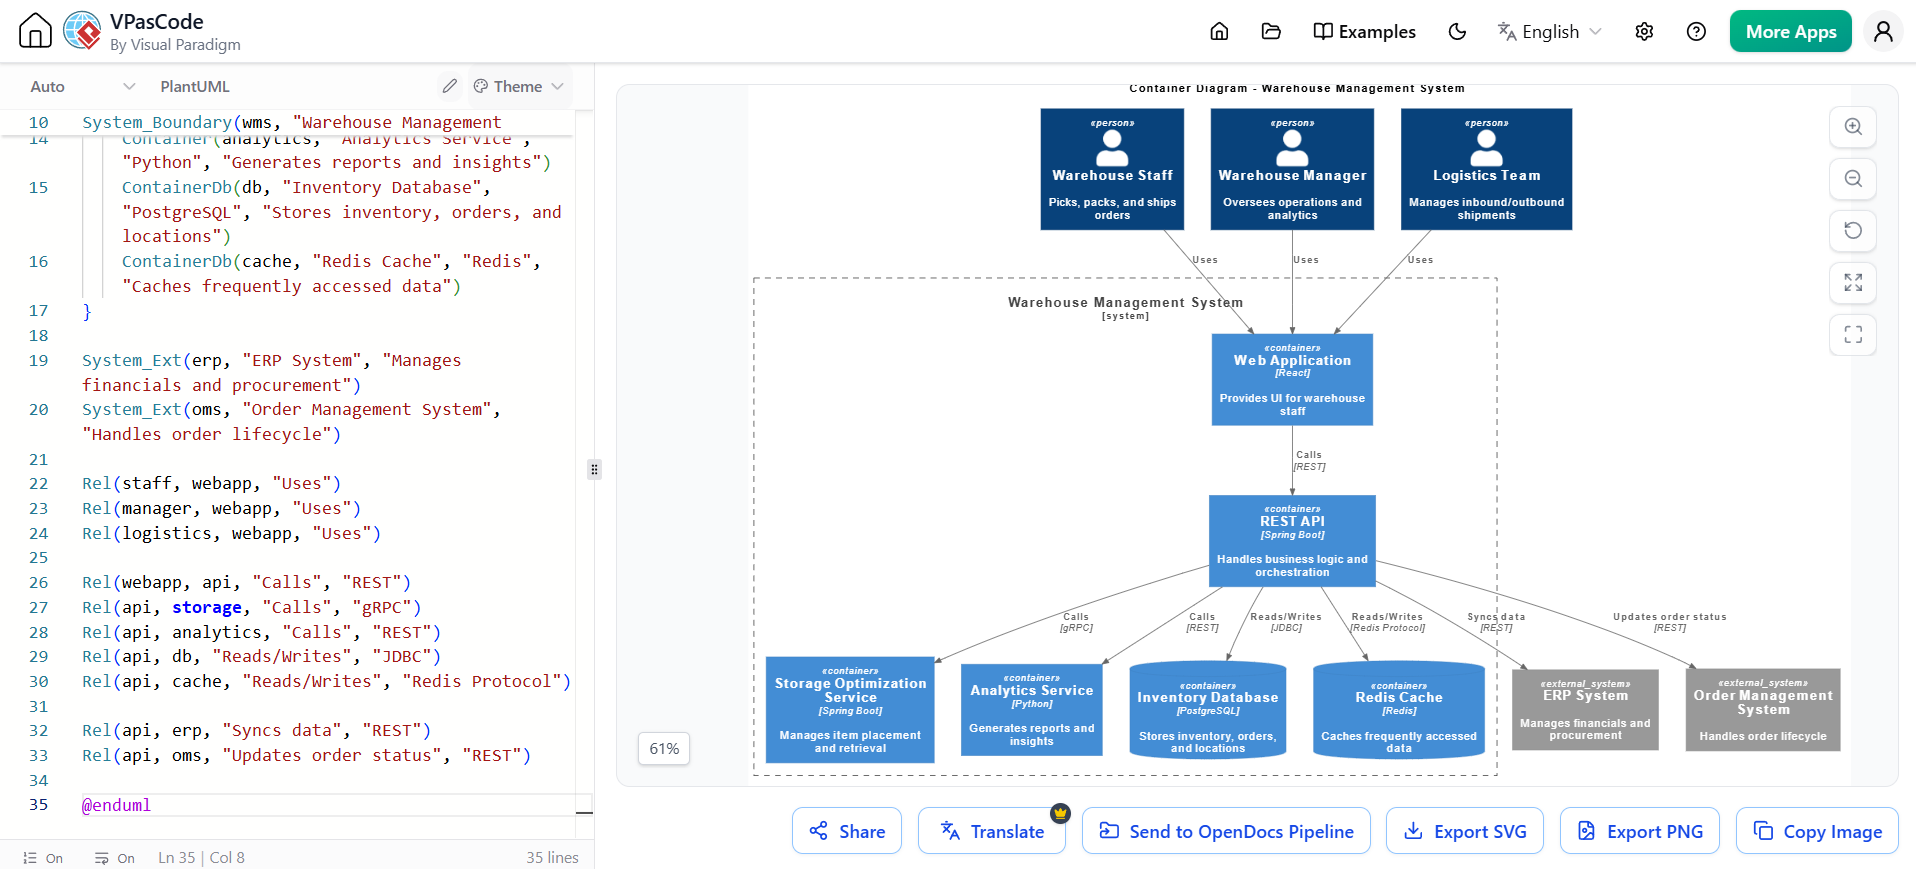
@startuml
!include https://raw.githubusercontent.com/plantuml-stdlib/C4-PlantUML/master/C4_Container.puml

title Container-Diagramm - Lagerverwaltungssystem

Person(staff, "Lagermitarbeiter", "Pickt, verpackt und versendet Bestellungen")
Person(manager, "Lagerleiter", "Überwacht Operationen und Analysen")
Person(logistics, "Logistikteam", "Verwaltet eingehende/ausgehende Sendungen")

System_Boundary(wms, "Lagerverwaltungssystem") {
    Container(webapp, "Webanwendung", "React", "Stellt Benutzeroberfläche für Lagermitarbeiter bereit")
    Container(api, "REST-API", "Spring Boot", "Verwaltet Geschäftslogik und Orchestrierung")
    Container(storage, "Lageroptimierungsdienst", "Spring Boot", "Verwaltet Artikelplatzierung und -abruf")
    Container(analytics, "Analyse-Dienst", "Python", "Erstellt Berichte und Erkenntnisse")
    ContainerDb(db, "Inventardatenbank", "PostgreSQL", "Speichert Inventar, Bestellungen und Standorte")
    ContainerDb(cache, "Redis-Cache", "Redis", "Cacht häufig genutzte Daten")
}

System_Ext(erp, "ERP-System", "Verwaltet Finanzen und Beschaffung")
System_Ext(oms, "Bestellverwaltungssystem", "Verwaltet den Bestelllebenszyklus")

Rel(staff, webapp, "Verwendet")
Rel(manager, webapp, "Verwendet")
Rel(logistics, webapp, "Verwendet")

Rel(webapp, api, "Ruft auf", "REST")
Rel(api, storage, "Ruft auf", "gRPC")
Rel(api, analytics, "Ruft auf", "REST")
Rel(api, db, "Liest/Schreibt", "JDBC")
Rel(api, cache, "Liest/Schreibt", "Redis-Protokoll")

Rel(api, erp, "Synchronisiert Daten", "REST")
Rel(api, oms, "Aktualisiert Bestellstatus", "REST")

@enduml
Plantuml in VPasCode bearbeiten
Beispiel für ein Komponentendiagramm (PlantUML)
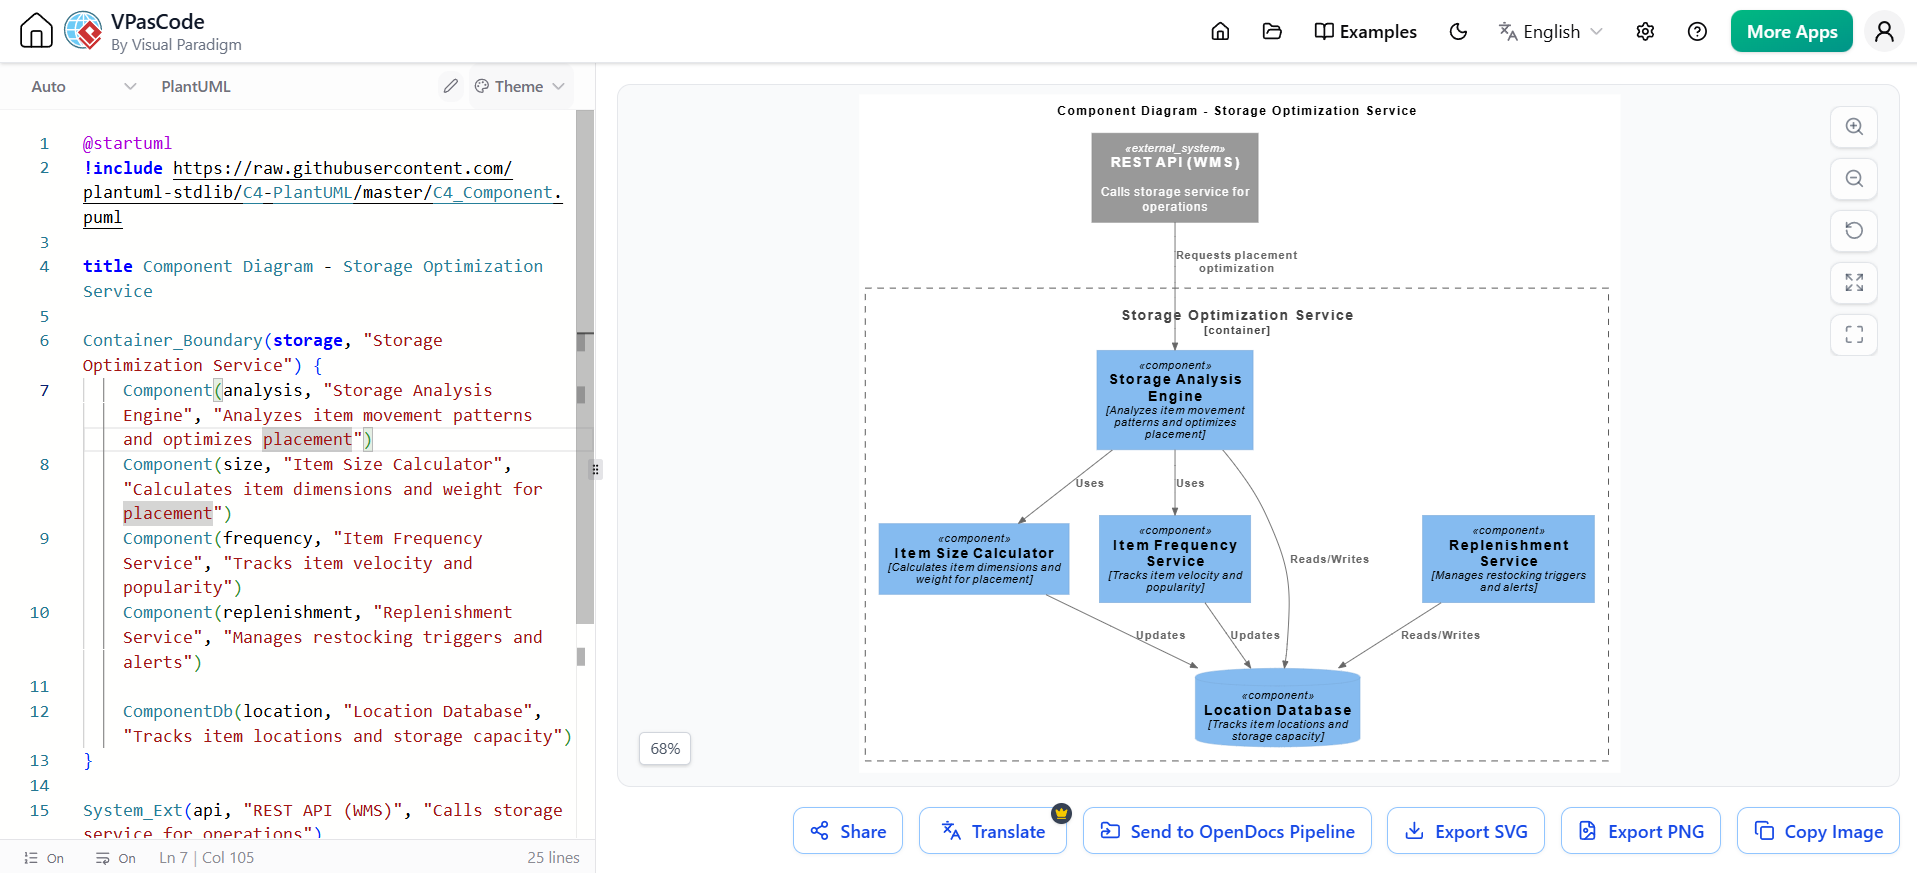
@startuml
!include https://raw.githubusercontent.com/plantuml-stdlib/C4-PlantUML/master/C4_Component.puml

title Komponentendiagramm - Lageroptimierungsdienst

Container_Boundary(storage, "Lageroptimierungsdienst") {
    Component(analysis, "Lageranalyse-Engine", "Analisiert Artikelbewegungsmuster und optimiert Platzierung")
    Component(size, "Artikelgrößenrechner", "Berechnet Artikelabmessungen und -gewicht für die Platzierung")
    Component(frequency, "Artikelhäufigkeitsdienst", "Verfolgt Artikelgeschwindigkeit und Popularität")
    Component(replenishment, "Nachfülldienst", "Verwaltet Nachfüllauslöser und Warnungen")

    ComponentDb(location, "Standortdatenbank", "Verfolgt Artikelstandorte und Lagerkapazität")
}

System_Ext(api, "REST-API (WMS)", "Ruft Lagerdienst für Operationen auf")

Rel(api, analysis, "Fordert Platzierungsoptimierung an")
Rel(analysis, size, "Verwendet")
Rel(analysis, frequency, "Verwendet")
Rel(analysis, location, "Liest/Schreibt")
Rel(size, location, "Aktualisiert")
Rel(frequency, location, "Aktualisiert")
Rel(replenishment, location, "Liest/Schreibt")

@enduml
Plantuml in VPasCode bearbeiten
Beispiel für ein Bereitstellungsdiagramm (PlantUML)
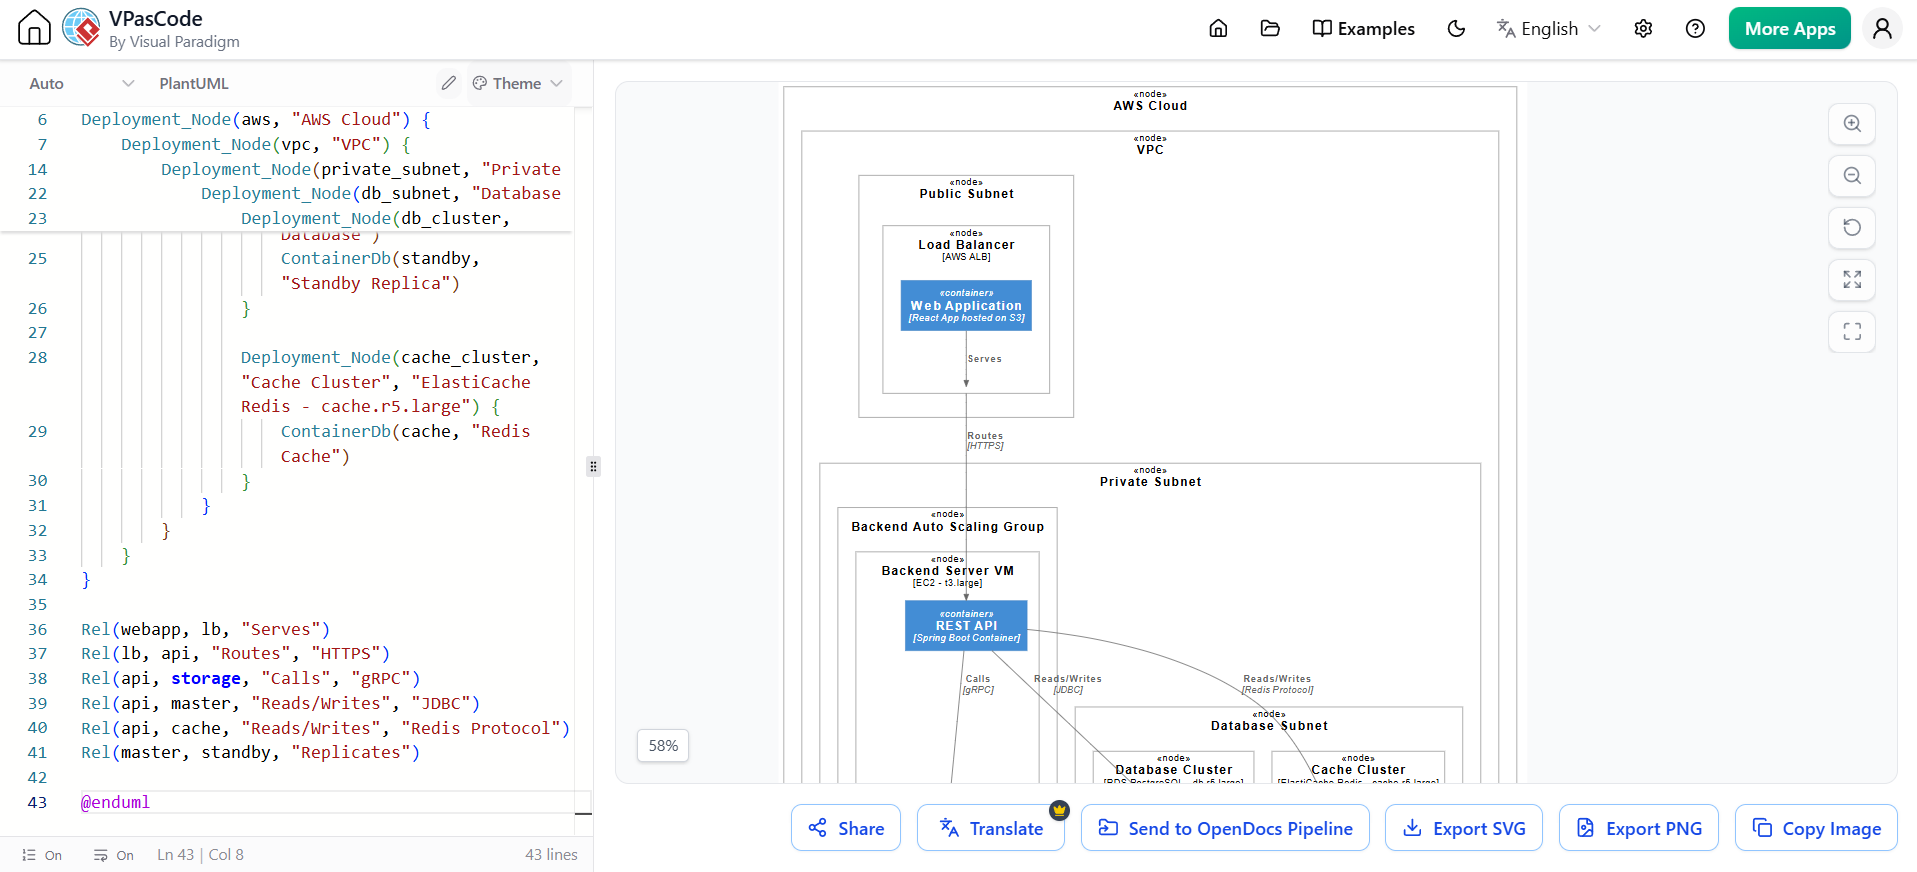
@startuml
!include https://raw.githubusercontent.com/plantuml-stdlib/C4-PlantUML/master/C4_Deployment.puml

title Bereitstellungsdiagramm - Lagerverwaltungssystem

Deployment_Node(aws, "AWS Cloud") {
    Deployment_Node(vpc, "VPC") {
        Deployment_Node(public_subnet, "Öffentliches Subnetz") {
            Deployment_Node(lb, "Load Balancer", "AWS ALB") {
                Container(webapp, "Webanwendung", "React App gehostet auf S3")
            }
        }

        Deployment_Node(private_subnet, "Privates Subnetz") {
            Deployment_Node(backend_asg, "Backend Auto-Scaling-Gruppe") {
                Deployment_Node(backend_vm, "Backend-Server-VM", "EC2 - t3.large") {
                    Container(api, "REST-API", "Spring Boot Container")
                    Container(storage, "Lageroptimierung", "Spring Boot Container")
                }
            }

            Deployment_Node(db_subnet, "Datenbank-Subnetz") {
                Deployment_Node(db_cluster, "Datenbank-Cluster", "RDS PostgreSQL - db.r5.large") {
                    ContainerDb(master, "Primäre Datenbank")
                    ContainerDb(standby, "Standby-Replik")
                }

                Deployment_Node(cache_cluster, "Cache-Cluster", "ElastiCache Redis - cache.r5.large") {
                    ContainerDb(cache, "Redis-Cache")
                }
            }
        }
    }
}

Rel(webapp, lb, "Bereitstellt")
Rel(lb, api, "Leitet", "HTTPS")
Rel(api, storage, "Ruft auf", "gRPC")
Rel(api, master, "Liest/Schreibt", "JDBC")
Rel(api, cache, "Liest/Schreibt", "Redis-Protokoll")
Rel(master, standby, "Repliziert")

@enduml
Plantuml in VPasCode bearbeiten
Schritt 3: Beziehungen verfeinern und erweitern
Ziel: Transformieren Sie das initiale C4-Modell in eine präzise, wartbare Architektur mit korrekten Beziehungen.
Wichtige Beziehungsmuster:
| Beziehung | Zweck | Beispiel |
|---|---|---|
| «include» | Verpflichtendes, gemeinsam genutztes Verhalten, das in mehreren Anwendungsfällen wiederverwendet wird | „Tisch reservieren“ beinhaltet „Zahlung abwickeln“ |
| «extend» | Optionales oder bedingtes Verhalten | „Rabatt anwenden“ erweitert „Tisch reservieren“, wenn ein Promo-Code eingegeben wird |
| Verallgemeinerung | Vererbung zwischen Akteuren oder Anwendungsfällen | „Administrator“ erbt von „Benutzer“ |
KI-geschlagene Verfeinerungen:
-
Ermittlung von Gemeinsamkeiten: Identifizierung redundanter Schritte → Vorschlag von «include»-Beziehungen
-
Verzweigung bedingter Logik: Erkennen von „Wenn-dann“-Szenarien → Vorschlag von «extend»-Beziehungen
-
Akteur-Verallgemeinerung: Finden überlappender Verantwortlichkeiten → Vorschlag einer Hierarchie
-
Komplexitätszerlegung: Identifizierung übermäßig großer Anwendungsfälle → Aufteilung in Teildiagramme
Kern-Erkenntnis: Die KI übernimmt die mechanische Arbeit des Zeichnens von Pfeilen und Erkennens von Mustern, während Ihr Domänenwissen sicherstellt, dass die Beziehungen einen echten geschäftlichen Sinn ergeben.
Beispiel für ein Anwendungsfalldiagramm mit verfeinerten Beziehungen
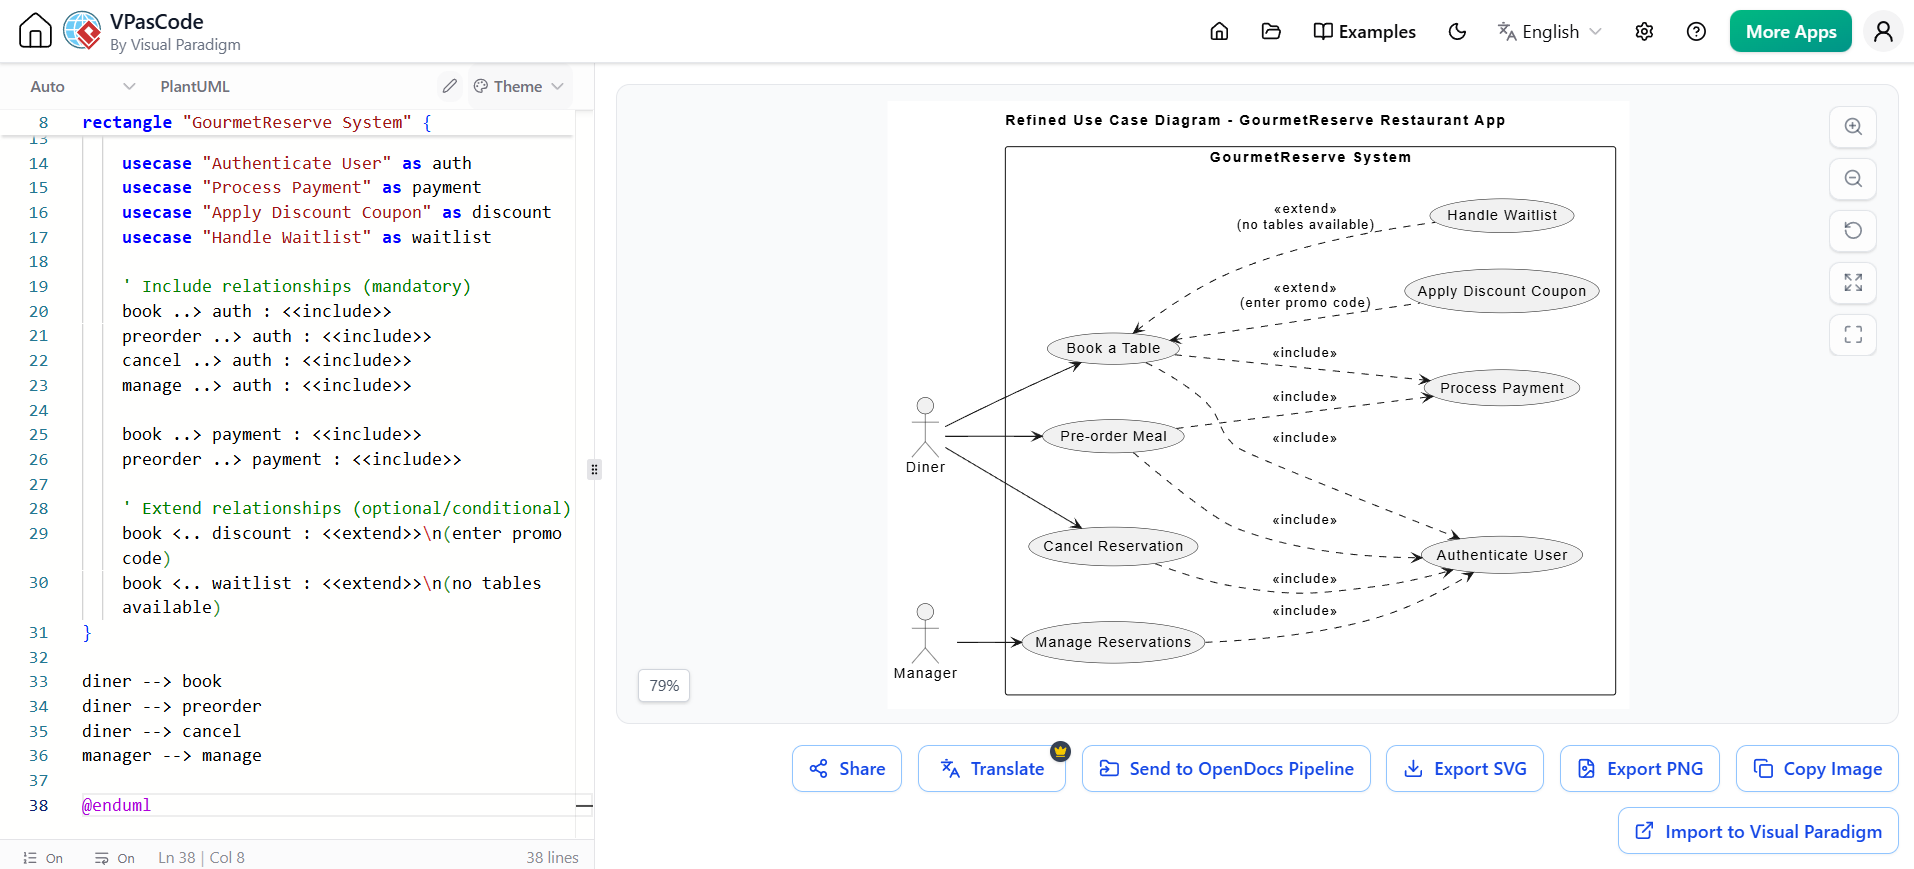
@startuml
title Verfeinertes Anwendungsfalldiagramm - GourmetReserve Restaurant-App

left to right direction
actor "Gast" as diner
actor "Manager" as manager

rectangle "GourmetReserve-System" {
    usecase "Tisch reservieren" as book
    usecase "Vorbestellung einer Mahlzeit" as preorder
    usecase "Reservierung stornieren" as cancel
    usecase "Reservierungen verwalten" as manage

    usecase "Benutzer authentifizieren" as auth
    usecase "Zahlung abwickeln" as payment
    usecase "Rabattgutschein anwenden" as discount
    usecase "Warteliste verwalten" as waitlist

    ' Include-Beziehungen (verpflichtend)
    book ..> auth : <<include>>
    preorder ..> auth : <<include>>
    cancel ..> auth : <<include>>
    manage ..> auth : <<include>>

    book ..> payment : <<include>>
    preorder ..> payment : <<include>>

    ' Extend-Beziehungen (optional/bedingt)
    book <.. discount : <<extend>>n(Promo-Code eingeben)
    book <.. waitlist : <<extend>>n(keine Tische verfügbar)
}

diner --> book
diner --> preorder
diner --> cancel
manager --> manage

@enduml
Plantuml in VPasCode bearbeiten
Schritt 4: OpenDocs – Die lebendige Dokumentationszentrale
Ziel: Erstellen und veröffentlichen Sie lebendige Dokumentation, bei der Diagramme automatisch aktualisiert werden, wenn sich die Quelldatenmodelle ändern.
Workflow:
-
Öffnen Sie Ihr technisches Handbuchim OpenDocs-Dokumenteditor
-
Zeiger positionierenam gewünschten Einfügepunkt
-
Pipeline-Artefakt einfügen:
-
Symbolleiste → Einfügen → Pipeline(linke Seitenleiste)
-
Durchsuchen Sie die gemeinsam genutzte Team-Sammlung
-
Nach Kommentar, Datum oder Quellplattform filtern
-
-
Inline darstellen: Das Diagramm wird sofort in voller Auflösung und mit interaktiven Funktionen angezeigt
-
Umgebenden Kontext schreibenunter Verwendung von Markdown mit Live-Vorschau:
-
Rich-Text-Bearbeitung
-
Tabellen, Code-Blöcke, hierarchische Ordner
-
Alles, während Diagramme interaktiv bleiben
-
-
Updates verwalten:
-
Ein schwebendes Versionshinweis (🔄)erscheint neben eingebetteten Diagrammen, wenn neuere Pipeline-Versionen verfügbar sind
-
Klicken Sie auf den Hinweis, um zeitliche Stempel, Commit-Hinweise und die Quellplattform nebeneinander anzuzeigen
-
Versionen austauschen, um Ihr Master-Dokument sofort zu aktualisieren
-
Vorherige Versionen bleiben für Prüfpfade oder Rollback-Szenarien zugänglich
-
💡 Schlüsselkonzept: Im Gegensatz zu Standard-Textplattformen, bei denen Bilder statische Schnappschüsse sind, bleiben eingebettete Visualisierungen in OpenDocs lebende Vektoren. Benutzer können das Element direkt im Dokument anklicken, um das Quelldiagramm zu öffnen und zu aktualisieren.
Beispielhafte OpenDocs-Inhaltsstruktur
📁 Projektdokumentation
├── 📄 01 - Zusammenfassung für die Geschäftsführung
│   └── [KI-generierte Stakeholder-Zusammenfassung mit Systemkontextdiagramm]
├── 📄 02 - Architekturübersicht
│   ├── [C4-Kontextdiagramm – Live]
│   ├── [C4-Containerdiagramm – Live]
│   └── Entscheidungen zur Technologie-Stack
├── 📄 03 - Detaillierte Gestaltung
│   ├── [Komponentendiagramme – Live]
│   ├── [Sequenzdiagramme – Live]
│   └── API-Spezifikationen
├── 📄 04 - Bereitstellungsarchitektur
│   ├── [Bereitstellungsdiagramm – Live]
│   └── Infrastruktur-Anforderungen
└── 📄 05 - Qualitätssicherung
    ├── [Testfälle vom KI-Generator]
    └── Abdeckungsmetriken
Schritt 5: Qualitätssicherung und Testing
Ziel: Automatisch nachvollziehbare Testfälle aus Ihren Modellen generieren.
KI-generierte Test-Assets:
| Test-Artefakt | Quelle | Beispiel |
|---|---|---|
| Testfälle | Anwendungsfallspezifikationen, Entscheidungstabellen, Aktivitäts-/Sequenzdiagramme | TC-001 – Happy Path, TC-002 – Zahlungsfehler |
| Voraussetzungen | Anwendungsfallschritte | „Gast angemeldet, Tische verfügbar, Gruppengröße 4“ |
| Nachverfolgbarkeits-Links | Anforderungen zu Designelementen zu Testfällen | „Nachverfolgung: Hauptschritte 1–7, Entscheidungstabellenregel R1“ |
| Abdeckungsmetriken | Projekt-Dashboard | „92 % der Entscheidungstabellenregeln getestet“ |
Beispielhafte KI-generierte Testfälle:
TC-001 – Happy Path – Keine Anzahlung erforderlich
Priorität: Hoch
Voraussetzungen: Gast angemeldet (Gold-Loyalität), Tische verfügbar, außerhalb der Stoßzeiten, Gruppengröße 4
Schritte:
  1. Tische suchen → Slot auswählen
  2. Zusammenfassung prüfen (keine Anzahlung angezeigt)
  3. Buchung bestätigen
Erwartet: Reservierung bestätigt, Bestätigung gesendet, kein Zahlungsbildschirm
Nachverfolgung: Hauptschritte 1–7, Entscheidungstabellenregel R1

TC-002 – Anzahlung erforderlich – Zahlung fehlschlägt
Priorität: Hoch
Voraussetzungen: Gruppengröße 10, Stoßzeiten, kein Gold-Status, gültige Karte, aber unzureichende Mittel
Schritte:
  1. Slot auswählen → zur Zahlung fortfahren
  2. Karte eingeben → absenden
Erwartet: Fehlermeldung „Zahlung abgelehnt“, Buchung nicht erstellt, Rückkehr zur Slot-Auswahl
Nachverfolgung: Entscheidungstabellenregel R5, Ausnahmefluss 4b
Schritt 6: Synchronisation und kontinuierliche Aktualisierungen
Ziel: Eine einzige Quelle der Wahrheit über alle Artefakte hinweg pflegen.
Der geschlossene Arbeitsablauf:
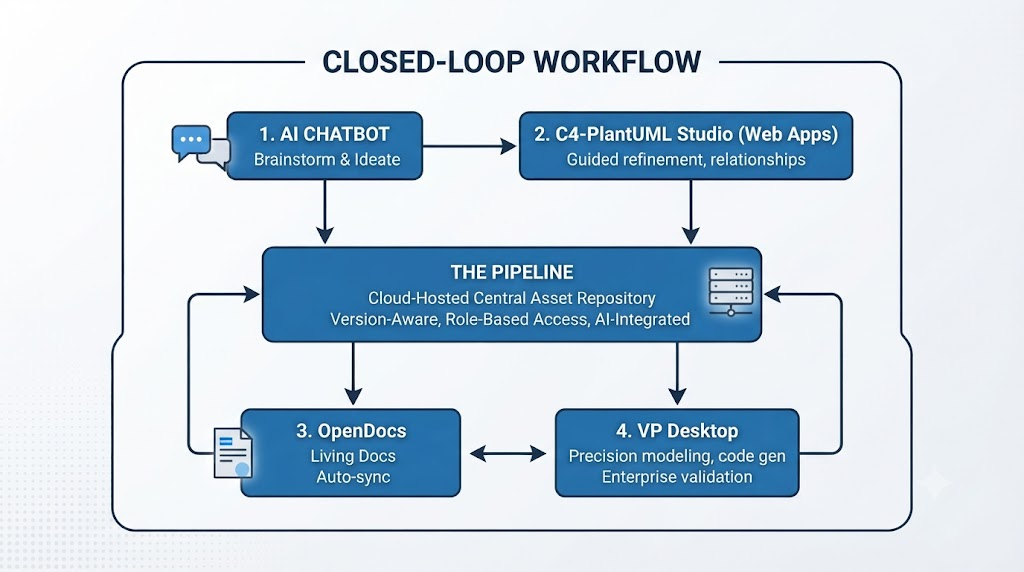
Vorteile der bidirektionalen Synchronisation:
-
Klasse in Desktop aktualisieren → wird in OpenDocs automatisch aktualisiert
-
Prompt im Chatbot verfeinern → Änderungen zurück an Studios senden
-
Synchronisation über ein einzelnes Konto
-
Versionsverlauf und vollständige Nachverfolgbarkeit
-
Keine manuelle Nacharbeit
Teil 3: Richtlinien und Best Practices
1. Best Practices für KI-Chatbots
Effektive Prompting-Techniken:
| Tun Sie | Tun Sie nicht |
|---|---|
| Nennen Sie Teilnehmer klar von Anfang an: „Benutzer, Browser, AuthService“ | Vage Anfragen wie „Erstellen Sie ein Systemdiagramm“ |
| Verwenden Sie Kontrollfluss-Sprache: „if…then…else“, „while“, „in parallel“ | Gehen Sie davon aus, dass die KI Architektur-Schichten kennt, die Sie nicht erwähnt haben |
| Geben Sie Architektur-Schichten an: „Controller → Service → Repository“ | Mischen Sie mehrere nicht zusammenhängende Szenarien in einem Prompt |
| Fordern Sie Annotationen an: „Fügen Sie Hinweise für Vorbedingungen hinzu“ | Erwarten Sie ein perfektes Layout beim ersten Versuch |
| Fordern Sie Variationen an: „Zeigen Sie den Fehlerpfad separat“ | Vergessen Sie, zu iterieren und zu verfeinern |
Befehle zur iterativen Verfeinerung:
"Fügen Sie eine Wiederholungsschleife hinzu, wenn die OTP-Validierung fehlschlägt (max. 3 Versuche)"
"Fügen Sie einen Zwei-Faktor-Schritt nur ein, wenn der Benutzer 2FA aktiviert hat (verwenden Sie ein opt-Fragment)"
"Zeigen Sie parallele Nachrichten: nach erfolgreicher Zahlung, benachrichtigen Sie den Kunden und aktualisieren Sie den Lagerbestand gleichzeitig"
"Ändern Sie die Lebensdauer von PaymentGateway, um einen Timeout nach 30 Sekunden anzuzeigen"
"Fügen Sie eine Selbstnachricht auf OrderService hinzu, um die Summe zu berechnen, bevor PaymentGateway aufgerufen wird"
2. Best Practices für C4-Modellierung
Schichtspezifische Richtlinien:
| Schicht | Best Practice |
|---|---|
| Kontext | Zeigen Sie nur die Systemgrenze und unmittelbare externe Interaktionen; eine Box für das gesamte System |
| Container | Zeigen Sie deployierbare Einheiten (Anwendungen, Datenbanken, Dienste); vermeiden Sie die Darstellung von Technologiedetails in Beziehungen |
| Komponente | Zeigen Sie die logische Gruppierung von Klassen; stellen Sie sicher, dass jede Komponente eine klare Verantwortung hat |
| Bereitstellung | Ordnen Sie Komponenten der tatsächlichen Infrastruktur zu; fügen Sie Informationen zu Redundanz und Skalierung hinzu |
Allgemeine C4-Prinzipien:
-
Jede Ebene sollte eine andere Perspektive bieten, nicht nur mehr Details
-
Diagramme sollten selbsterklärend mit minimalem Text sein
-
Stellen Sie die Konsistenz der Terminologie über alle Ebenen hinweg sicher
-
Verwenden Sie Farbcodierung, um System- von externen Komponenten zu unterscheiden
3. Best Practices für Pipelines
Metadaten-Verwaltung:
| Praxis | Warum |
|---|---|
| Fügen Sie beschreibende Commit-Notizen hinzu | Unterstützen Sie die Versionsidentifizierung und Nachverfolgung |
| Verwenden Sie konsistente Namenskonventionen | Aktivieren Sie Filterung und Suche über die Team-Sammlung hinweg |
| Enthalten Sie Informationen zur Quellplattform | Verfolgen Sie die Herkunft von Artefakten |
| Kennzeichnen Sie mit Sprint- oder Release-Identifikatoren | Rollback und Vergleich erleichtern |
Versionsverwaltung:
-
Überarbeiten Sie Änderungen, bevor Sie Dokumente austauschen
-
Bewahren Sie frühere Versionen für Prüfpfade zugänglich
-
Verwenden Sie den Revisionsindikator (🔄), um veraltete Diagramme zu identifizieren
-
Führen Sie bei Bedarf Batch-Aktualisierungen durch, um die Kohärenz der Dokumente zu wahren
4. Best Practices für OpenDocs
Dokumentationsstruktur:
| Praxis | Beschreibung |
|---|---|
| Verwenden Sie baumstrukturierte Bereiche | Organisieren Sie die Dokumentation mit hierarchischen verschachtelten Ordnern; spiegeln Sie die Systemarchitektur wider |
| Einbetten, nicht anhängen | Fügen Sie lebende Pipeline-Artefakte ein statt statischer Screenshots |
| Trennung der Belange aufrechterhalten | Trennen Sie Architekturdiagramme von detaillierten Implementierungsdokumenten |
| Zusammenarbeit ermöglichen | Teilen Sie einzelne Links; Interessengruppen kommentieren direkt Diagramme oder Texte |
JIT (Just-in-Time)-Einbettungspfade:
-
Ad-hoc-Einbettung: Klicken Sie direkt auf einer Dokumentenseite auf Einfügen > Diagramm
-
KI-gesteuerte Generierung: Verwenden Sie natürliche Sprache, um Diagramme innerhalb der Texterzählung zu erstellen
-
Zentrale Asset-Pipeline: Pushen Sie von Desktop/Online in die Pipeline; ziehen Sie sie in Dokumente
5. Best Practices für Qualitätssicherung
Rückverfolgbarkeitsanforderungen:
| Artefakt | Rückverfolgbarkeitsanforderung |
|---|---|
| Anwendungsfälle | Verknüpfung mit Anforderungen und Testfällen |
| Entscheidungstabellen | Stellen Sie sicher, dass jede Regel durch mindestens einen Test abgedeckt ist |
| Aktivitäts-/Sequenzdiagramme | Verknüpfen Sie Testschritte mit spezifischen Diagrammelementen |
| Nicht-funktionale Aspekte | In Notizen oder Einschränkungen aufnehmen; separat testen |
Testabdeckungsmetriken:
-
Vollständigkeit über das Projekt-Dashboard überwachen
-
Abdeckung verfolgen über: Anwendungsfälle, Entscheidungstabellen, Szenarien (Happy Path, Alternativen, Ausnahmen, Randfälle)
-
Risikobasierte Priorisierung verbleibender Testfälle
6. Best Practices für Berichterstattung und Dokumentation
KI-generierte Berichtsstruktur:
| Abschnitt | Inhalt |
|---|---|
| Zusammenfassung für die Geschäftsführung | Übergreifende Darstellung der Systemziele |
| Visuelle Logikmodelle | Gerenderte Anwendungsfälle-, Aktivitäts- und Sequenzdiagramme |
| Funktionale Spezifikationen | Detaillierter Ablauf von Ereignissen (Haupt-, Alternativ-, Ausnahmepfade) |
| Rückverfolgbarkeitsmatrix | Anforderungen → Design → Testfälle |
| Datenschema | Entity-Relationship-Diagramme und Klassenstrukturen |
| Bereitstellungsplan | Infrastrukturanforderungen und Topologie |
Teil 4: Beispiel für einen End-to-End-Arbeitsablauf
Szenario: Entwicklung eines Lagerverwaltungssystems
Schritt 1: KI-Chatbot – Ideenfindung
Prompt: "Erstellen Sie ein C4-Systemkontextdiagramm für ein Lagerverwaltungssystem, das mit ERP und Auftragsverwaltung integriert ist"
Ausgabe: Initiales Kontextdiagramm, das Benutzer (Lagerpersonal, Manager, Logistik) und externe Systeme (ERP, OMS) zeigt.
Schritt 2: C4-PlantUML Studio – Geführte Verfeinerung
-
Problemstellung mit KI-Assistenz definieren
-
Container-Diagramm generieren: Web-App (React), Storage-Optimierungsdienst (Spring Boot), Inventardatenbank (PostgreSQL)
-
Komponentendiagramm generieren: Storage-Analyse-Engine, Artikelgrößenrechner, Artikelhäufigkeitsdienst, Nachfülldienst
-
Bereitstellungsdiagramm generieren: AWS-Architektur mit EC2, RDS, ElastiCache
-
Dynamische Ansichten hinzufügen: Sequenzdiagramme zur Verfolgung von Inventarbewegungen
Schritt 3: Beziehungsverfeinerung
KI identifiziert und schlägt vor:
-
«include» → Benutzer für alle Anwendungsfälle authentifizieren
-
«include» → Zahlung für Tischreservierung und Vorbestellung eines Essens verarbeiten
-
«extend» → Rabattgutschein anwenden (abhängig vom Promo-Code)
-
«extend» → Warteliste verwalten (abhängig von der Verfügbarkeit von Tischen)
Schritt 4: OpenDocs – Lebende Dokumentation
-
Alle Pipeline-Artefakte in Dokumentationsseiten einfügen
-
Markdown-Erklärungen mit eingebetteten Live-Diagrammen schreiben
-
Automatisch aus Anwendungsfällen und Entscheidungstabellen generierte Testfälle hinzufügen
-
Über einen sicheren Freigabelink im Stakeholder-Portal veröffentlichen
Schritt 5: Synchronisation
-
Zwei Wochen später ändert die Entwicklungsabteilung den Storage-Optimierungsalgorithmus
-
Architekt bearbeitet das Diagramm in VP Desktop
-
OpenDocs meldet die Synchronisationsänderung an das Autorenteam
-
Das Team wechselt zu einer neuen Revision, ohne das manuelle Formatierung zu beeinträchtigen
-
Alle Beteiligten sehen aktualisierte Dokumentation sofort
Teil 5: Zusammenfassung und Kernpunkte
Das Wertversprechen
Das KI-Ökosystem von Visual Paradigm wandelt fragmentierte „Konzept-zu-Dokumente”-Workflows in eine einheitliche automatisierte Pipeline um, in der visuelle Modelle und Dokumentation gemeinsam als eine einzige Quelle der Wahrheit weiterentwickelt werden.
Hauptvorteile:
| Für technische Teams | Für geschäftliche Stakeholder | Für Organisationen |
|---|---|---|
| Reduzierter Wartungsaufwand | Besseres Verständnis komplexer Systeme | Eine einzige Quelle der Wahrheit |
| Verbesserte Genauigkeit | Schnellere Entscheidungsfindung | Abgeschaffte Informationssilos |
| Verbesserte Zusammenarbeit | Reduziertes Risiko von Missverständnissen | Skalierbares Wissensmanagement |
| KI-gestützte Effizienz | Aktuelle Informationen jederzeit verfügbar | Zukunftssichere Veröffentlichung |
Zusammenfassung des finalen Workflows
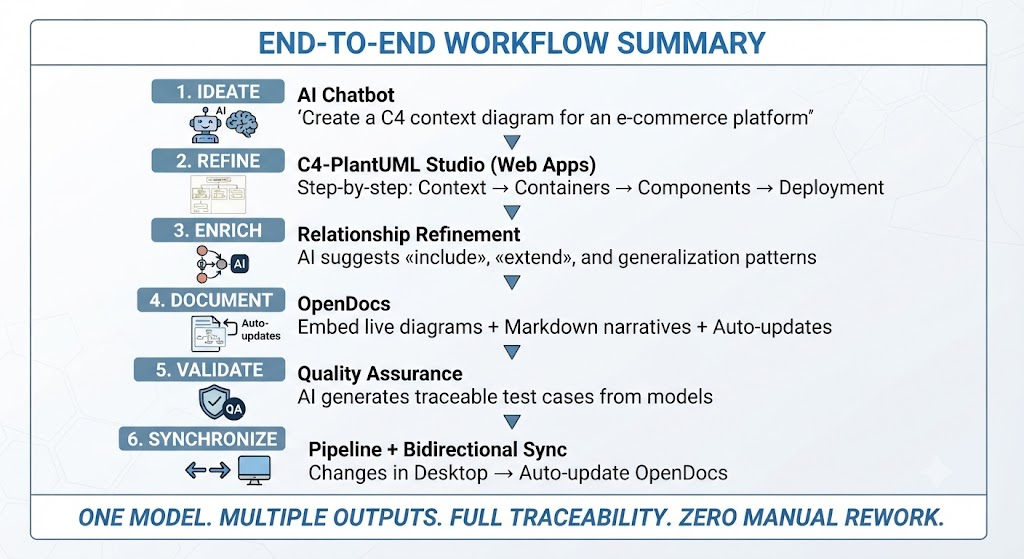
Schnellreferenz: Welches Werkzeug für welche Aufgabe
| Aufgabe | Werkzeug | Warum |
|---|---|---|
| Brainstorming und schnelles Prototyping | KI-Chatbot | Schnellster Weg von der Idee zur Visualisierung |
| Strukturierte C4-Modellierung | C4-PlantUML Studio | Geführte Workflows stellen Vollständigkeit sicher |
| Lebendige Dokumentation | OpenDocs | Diagramme aktualisieren sich automatisch; eine einzige Quelle der Wahrheit |
| Präzisionsingenieurwesen | VP Desktop | Validierung, Code-Generierung, Unternehmensfunktionen |
| Generierung von Testfällen | KI-Anwendungsfall-Studio | Von Anwendungsfall und Entscheidungstabellen zu Test-Assets |
| Berichterstattung | KI-Berichterstattung | Zusammenfassungen für Führungskräfte, technische Leitfäden, Prüfpfade |
Anhang: Schnelle Referenz für PlantUML-Code-Snippets
C4-Kontext
!include https://raw.githubusercontent.com/plantuml-stdlib/C4-PlantUML/master/C4_Context.puml
Person(user, "Benutzer", "Beschreibung")
System(system, "Systemname", "Beschreibung")
System_Ext(external, "Externes System", "Beschreibung")
Rel(user, system, "Verwendet", "Protokoll")
Plantuml in VPasCode bearbeiten
C4-Container
!include https://raw.githubusercontent.com/plantuml-stdlib/C4-PlantUML/master/C4_Container.puml
Container(container, "Containername", "Technologie", "Beschreibung")
ContainerDb(db, "Datenbank", "PostgreSQL", "Speichert Daten")
Plantuml in VPasCode bearbeiten
C4-Komponente
!include https://raw.githubusercontent.com/plantuml-stdlib/C4-PlantUML/master/C4_Component.puml
Component(component, "Komponentenname", "Beschreibung")
PlantUML in VPasCode bearbeiten
C4-Bereitstellung
!include https://raw.githubusercontent.com/plantuml-stdlib/C4-PlantUML/master/C4_Deployment.puml
Deployment_Node(node, "Knotenname", "Technologie")
PlantUML in VPasCode bearbeiten
Sequenzdiagramm
actor "Akteurname" as actor
participant "Teilnehmer" as participant
actor -> participant: Nachricht
activate participant
participant --> actor: Rückgabe
deactivate participant
PlantUML in VPasCode bearbeiten
Anwendungsfalldiagramm
actor "Benutzer" as user
usecase "Anwendungsfall" as uc
user --> uc
uc ..> included : <<include>>
uc <.. extended : <<extend>>
PlantUML in VPasCode bearbeiten
Fazit
Das von KI unterstützte Ökosystem von Visual Paradigm stellt einen bedeutenden Fortschritt in der Art und Weise dar, wie technische Teams Komplexität verwalten. Durch die Integration von KI-gesteuerter Ideenfindung, strukturierter C4-Modellierung und lebendiger Dokumentation in einer einzigen Pipeline wird die traditionelle Reibung zwischen Design und Dokumentation beseitigt.
Egal, ob Sie eine neue Microservice-Architektur brainstormen, unternehmensweite Bereitstellungsstrategien verfeinern oder sicherstellen, dass Ihre Onboarding-Dokumente aktuell bleiben – dieser Workflow stellt sicher, dass Ihre visuellen Modelle und textlichen Erklärungen synchronisiert, präzise und zugänglich bleiben. Beginnen Sie mit dem KI-Chatbot für schnelle Ideenfindung, nutzen Sie C4-PlantUML Studio für strukturierte Verfeinerung und schließen Sie den Kreis mit OpenDocs für lebendige Dokumentation, die automatisch mit Ihrer sich entwickelnden Architektur synchronisiert bleibt.
Der Artikel ist auch in English, Español, فارسی, Français, Bahasa Indonesia, 日本語, Polski, Portuguese, Ру́сский, Việt Nam, 简体中文 and 繁體中文 verfügbar.